

指南
使用 AWS Lambda 进行网页抓取:Python、Java 指南 2026
TL;DR: 简而言之:使用 AWS Lambda 进行网页抓取时,最佳实践是确保每次调用都简短、可控且可独立重试。建议从直接 HTTP 请求、AWS SAM 和 S3 开始,仅当工作负载确实需要时,再添加 SQS、容器、浏览器渲染、代理或托管抓取层。
Suciu Dan6 min read
阅读文章Blog · 文章
关于网页抓取、代理管理和数据提取的分步教程、最佳实践及实用指南。
已发表的文章
105
文章
105 文章
TL;DR: 简而言之:使用 AWS Lambda 进行网页抓取时,最佳实践是确保每次调用都简短、可控且可独立重试。建议从直接 HTTP 请求、AWS SAM 和 S3 开始,仅当工作负载确实需要时,再添加 SQS、容器、浏览器渲染、代理或托管抓取层。

TL;DR: 简而言之:GoSpider 是一款用于发现 URL 的命令行爬虫工具,并非功能完整的结构化数据抓取工具。本《GoSpider 使用指南》介绍了有限范围爬取、干净的输出处理、Colly 到 CSV 的数据转换,以及针对 403 响应或需要 JavaScript 渲染的页面的故障排查路径。
TL;DR: 简要说明:Redfin 公开了隐藏的 API 端点,这些端点可返回结构化的 JSON 房源列表,从而使完全跳过脆弱的 HTML 解析成为可能。本指南将指导您构建一个 Python 搜刮器,它可以提取租售数据、按位置搜索、通过 XML 网站地图监控新房源,并将干净的结果导出为 CSV 或 JSON。
TL;DR: 使用 Python 中的 json.loads 和 json.load 解析 JSON,修复解码错误,验证嵌套数据,流式处理大文件,并提取隐藏在网页中的 JSON-LD 或 __NEXT_DATA__——此外还包括 WebScrapingAPI 封装。

TL;DR: 没有一款AI爬虫能胜任所有工作负载。根据数据提取方法、用户类型、操作功能和成本对11款工具进行对比,然后通过实用的测试方案选择最适合的工具。
TL;DR: 简要说明:XPath 是一种查询语言,用于通过路径、属性或文本内容导航 HTML/XML 树。本指南涵盖 XPath 语法、轴和函数,然后展示了使用 lxml 和 Selenium 运行 Python scraers 的情况。您还将获得一份综合小抄和针对最常见 XPath 错误的故障排除部分。
TL;DR: 简要说明:Scrapy-Playwright 可让你通过 Playwright 控制真实的 Chromium、Firefox 或 WebKit 浏览器,直接在 Scrapy spiders 中渲染 JavaScript 繁重的页面。本教程将指导你完成安装、配置、页面交互、AJAX 截取、反检测和生产就绪的项目结构,这样你就可以在不离开 Scrapy 生态系统的情况下抓取动态网站了。
TL;DR: 使用 Python 结合 JavaScript 渲染、代理服务器、CSS 选择器和分页功能,抓取 Expedia 的酒店列表,然后对数据进行清理并导出为 CSV 格式。
TL;DR: 将密钥设置为环境变量,发送您的第一个 WebScrapingAPI SERP API 请求,然后按国家/地区、语言和设备对 Google 搜索结果进行本地化,采用防御性方式解析 Google 和 Bing 的 JSON 数据,自行提取 DuckDuckGo 和 Yandex 的 HTML 内容,运行异步 Google 任务, 根据文档中记载的错误代码进行重试,并根据截至 2026 年 10 月的 Google 定价方案选择合适的套餐。
TL;DR: 开始使用 WebScrapingAPI 的亚马逊数据抓取 API:发送您的第一个请求,从九种请求类型(商品、搜索、畅销榜、优惠、卖家评论等)中进行选择,支持 20 个亚马逊市场,解析每个 JSON 响应,处理错误和重试,并选择合适的套餐。

TL;DR: 简而言之:Scrapy 是一个完整的抓取框架,可在一个软件包中处理请求、解析和数据导出。Beautiful Soup 是一个轻量级解析库,可与 HTTP 客户端(如请求)配对使用。当你需要利用内置管道进行大规模并发抓取时,请选择 Scrapy。当你需要一个快速、最小化的设置来解析少量页面时,请选择 Beautiful Soup。

TL;DR: 简要说明:Scrapy Splash 将 Scrapy 的快速抓取引擎与 Splash 无头浏览器配对使用,以渲染 JavaScript 较多的页面。本 Scrapy Splash 教程将指导你完成 Docker 设置、Scrapy 项目配置、SplashRequest 基础知识、用于滚动和点击的 Lua 脚本、代理集成,以及修复你将遇到的最常见错误。

TL;DR: 简要说明:亚马逊产品页面包含大量有价值的数据(价格、评分、评论、ASIN),但可靠地提取这些数据需要的不仅仅是基本的 HTTP 请求。本指南将指导您使用 Requests 和 BeautifulSoup 构建 Python scraper,处理分页和反僵尸防御,导出为 CSV 或 JSON,并将结果输入 LLM 工作流。您还将了解何时使用刮擦 API 而不是推出自己的解决方案。

TL;DR: 简要说明:职位搜索工具包括轻量级 API 服务和开源浏览器自动化,以及人工智能驱动的提取器和可视化无代码平台。本指南比较了 Google Jobs、Indeed、Monster、Upwork 和自由职业者市场上的最佳工作搜索工具,然后指导您通过重复数据删除、调度和反僵尸处理来构建可靠的管道,从而开始大规模收集干净的工作数据。

TL;DR: 简要说明:Cloudflare 通过对浏览器进行指纹识别、检查报头和分析行为信号来阻止 vanilla Selenium。本指南介绍了五种实用的绕过方法(未检测到的 ChromeDriver、Selenium Stealth、SeleniumBase UC 模式、验证码解码器集成和刮擦 API),并附有 Python 代码、比较表和故障排除运行手册,因此您可以根据自己的规模和预算选择合适的方法。

TL;DR: 简要说明:没有官方的 Google SERP API,因此由第三方提供商来填补这一空白。价格从每千次搜索大约 0.30 美元到 15 美元不等,正确的选择取决于您的搜索量、预算以及需要提取的 SERP 功能。本指南对顶级提供商进行了并列比较,分解了规模化的真实成本,并为您提供了一个决策框架,以筛选出最适合您项目的 SERP API。
TL;DR: 简要说明:Axios 通过代理路由请求,接受包含主机、端口和可选 auth 字段的代理对象。本指南介绍如何从头开始设置 Axios 代理配置:基本布线、认证代理、HTTPS 隧道、使用拦截器的轮换系统、通过 socks-proxy-agent 实现 SOCKS5 以及诊断常见错误。每个片段都是可复制粘贴的 Node.js 代码。
TL;DR: 简而言之:Puppeteer 下载文件工作流程有四种形式:点击按钮,让 Chrome 浏览器写入你控制的文件夹;在页面内运行 fetch() 并将 base64 管道传回 Node;利用下载进度事件驱动 Chrome DevTools 协议;或者跳过浏览器,利用从 Puppeteer 会话中获取的 Cookie 通过 Axios 获取 URL。根据文件大小、身份验证和网站公开链接的方式进行选择。

TL;DR: 简要说明:Node-Fetch 没有内置代理开关,因此您需要通过代理选项将 HTTP、HTTPS 或 SOCKS5 代理接入请求。本指南从头到尾介绍了如何在 Node-Fetch 中使用代理:经过验证的 HTTP 和 HTTPS 代理、SOCKS5、轮换、重试、TLS 边缘情况、故障排除以及 Node 18+ 原生获取的现代 undici 路由。

TL;DR: 简而言之:用 Python 对 JavaScript 表格进行网络刮擦很少需要无头浏览器。打开 DevTools,找到与网格融为一体的 JSON 端点,用请求重放它,对它进行分页,只有当网络调用被签名、加密或以其他方式密封时,才返回 Playwright。

TL;DR: 简要说明:本指南展示了如何在 Golang 中从头到尾地刮擦 HTML 表格:在 Colly、goquery 和 golang.org/x/net/html 之间进行选择,以正确的 <tbody> 为目标,将行建模为类型化结构,并导出干净的 JSON 和 CSV。你还能获得分页、反阻塞和 JavaScript 渲染的表格模式。
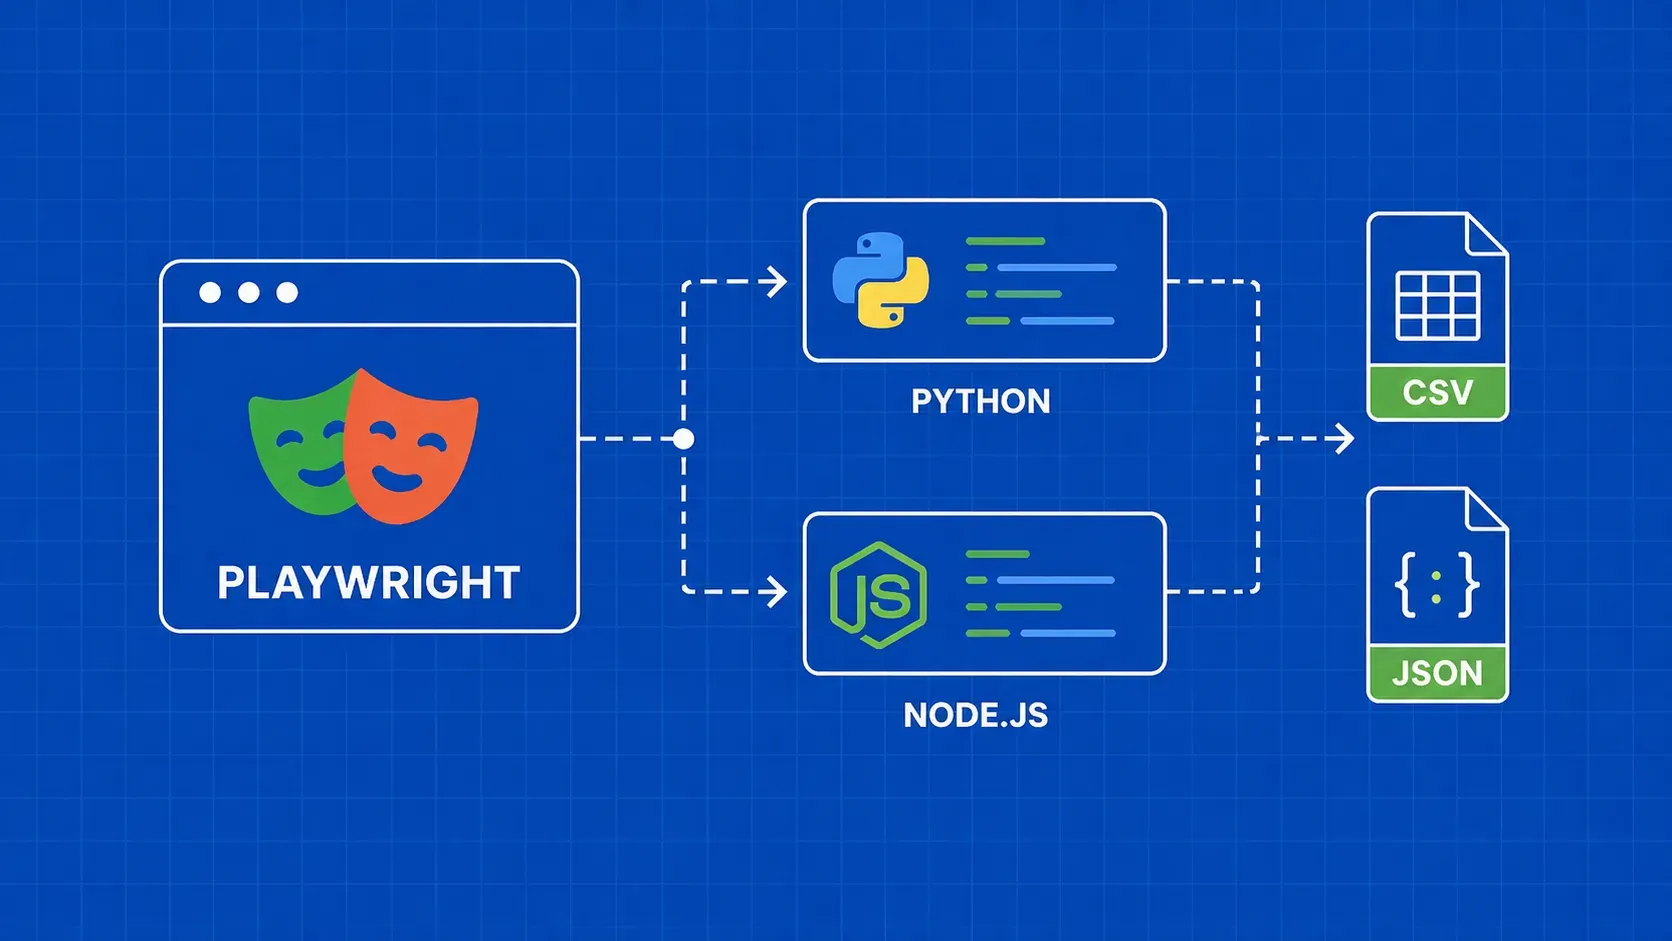
TL;DR: 简要说明:Playwright 为您提供了全面的浏览器自动化功能,可用于刮擦 JavaScript 繁重的网站,并为 Python 和 Node.js 提供一流的支持。本指南将指导您完成安装、元素提取、代理配置、反检测、分页、图片下载以及将数据导出为 CSV 或 JSON 等操作,并提供两种语言的并行代码示例。

TL;DR: 简要说明:要想知道如何从 Google 地图中抓取评论,有三种方法:旋转代理后的 DIY Selenium 抓取器、带有渲染说明的抓取 API 或返回解析 JSON 的结构化地图评论 API。本指南用 Python 演示了这三种方法,包括可复制粘贴的代码、分页模式、防拦截策略,以及将原始评论转化为企业可实际使用的内容的最后清理步骤。

TL;DR: 学习用 urllib、requests 和 aiohttp 在 Python 中下载文件:流式下载、进度条、并行与异步下载、重试以及身份验证。

TL;DR: 简要说明:本指南从头到尾介绍了如何在 Python Requests 中使用代理:一个有效的代理字典、经过验证的 URL、环境变量、会话重用、不泄漏 DNS 的 SOCKS5 以及带有重试和断路器的轮换池。到最后,你就会知道什么时候托管 API 比 DIY 池更有价值。

TL;DR: 了解如何使用 Node.js 配合我们的 API 抓取 Google 地图的地点结果:分步指南、专业抓取工具的优势等。轻松获取 data_id、坐标以及构建数据参数。
TL;DR: 简而言之:当您需要从您已经信任的 HTML 中提取简短、可预测的文本模式(价格、SKU、电子邮件、日期)时,使用 regex 进行 Web scraping 就会大显身手。将 Python 的 re 模块与 Beautiful Soup 搭配使用,将模式范围扩大到解析的节点而不是原始标记,让 regex 远离完整的 HTML 树解析。本指南将介绍标题和价格搜索器的工作原理、高级 regex 功能,以及真正的搜索器在生产中会遇到的陷阱。
TL;DR: 利用专业的网页抓取技术,充分挖掘Twitter数据。学习如何抓取Twitter数据以进行情绪分析、市场营销和商业情报分析。本指南全面介绍了如何使用TypeScript进行操作。

TL;DR: 简要说明:要在 C# 中使用 HttpClient 代理,只需创建一个 WebProxy,将其附加到 HttpClientHandler(或 SocketsHttpHandler),然后将该处理程序传递给 HttpClient 构造函数。在生产中,将手动循环换成 IHttpClientFactory,为经过验证的代理添加 NetworkCredential,并使用 Polly 将调用包裹在重试中,这样死 IP 就不会让你的工作程序宕机。
TL;DR: 简而言之:只需使用一行 pandas.read_html 命令,就能刮擦大部分 HTML 表格。当表格是分页的、JavaScript 渲染的或有合并表头时,请切换到 Requests + BeautifulSoup 或像 Playwright 这样的无头浏览器。本指南为您提供了决策矩阵、三种方法的工作代码,以及将刮擦行转化为管道就绪数据的清理步骤。
TL;DR: 简而言之:Cheerio 是轻量级 HTML 解析器;Puppeteer 驱动真正的 Chromium 浏览器。当数据已经存在于原始 HTML 中时,使用 Cheerio;当 JavaScript 渲染数据时,使用 Puppeteer;当每次访问需要提取大量字段的 JS 页面时,将它们结合起来使用。

TL;DR: 简而言之:如果你正在研究如何干净利落地抓取 Realtor.com,那么有三件事最为重要:稳定的选择器(能经受住散列类名称的考验)、能经受住 Realtor 反僵尸堆栈的请求层,以及能同时浏览列表页和详情页的代码。本指南是完整的 Python 构建,包含反僵尸策略和 LLM 就绪导出。

TL;DR: 简要说明:本指南将介绍如何使用 Python 从头到尾对 Booking.com 进行网络搜刮:提取搜索列表、酒店页面、每晚价格和客人评论。您将获得两种互补方法:一种是用于 JS 渲染页面的 Selenium Wire 工作流,另一种是直接调用 Booking.com 内部 /dml/graphql 端点的更快路径,此外还有反阻塞播放器、货币处理和解决约 1,000 个结果分页上限的方法。

TL;DR: 简要说明:Idealista 是西班牙、意大利和葡萄牙最大的房产交易市场,但它背后有一个严密的反僵尸堆栈,可以快速阻止天真的刮擦程序。本指南将指导您如何使用 Python 从 Idealista 端到端搜刮数据,包括网站映射、Selenium 与 undetected-chromedriver、DataDome 处理、代理轮换和干净的导出,以及竞争对手通常跳过的生产加固。
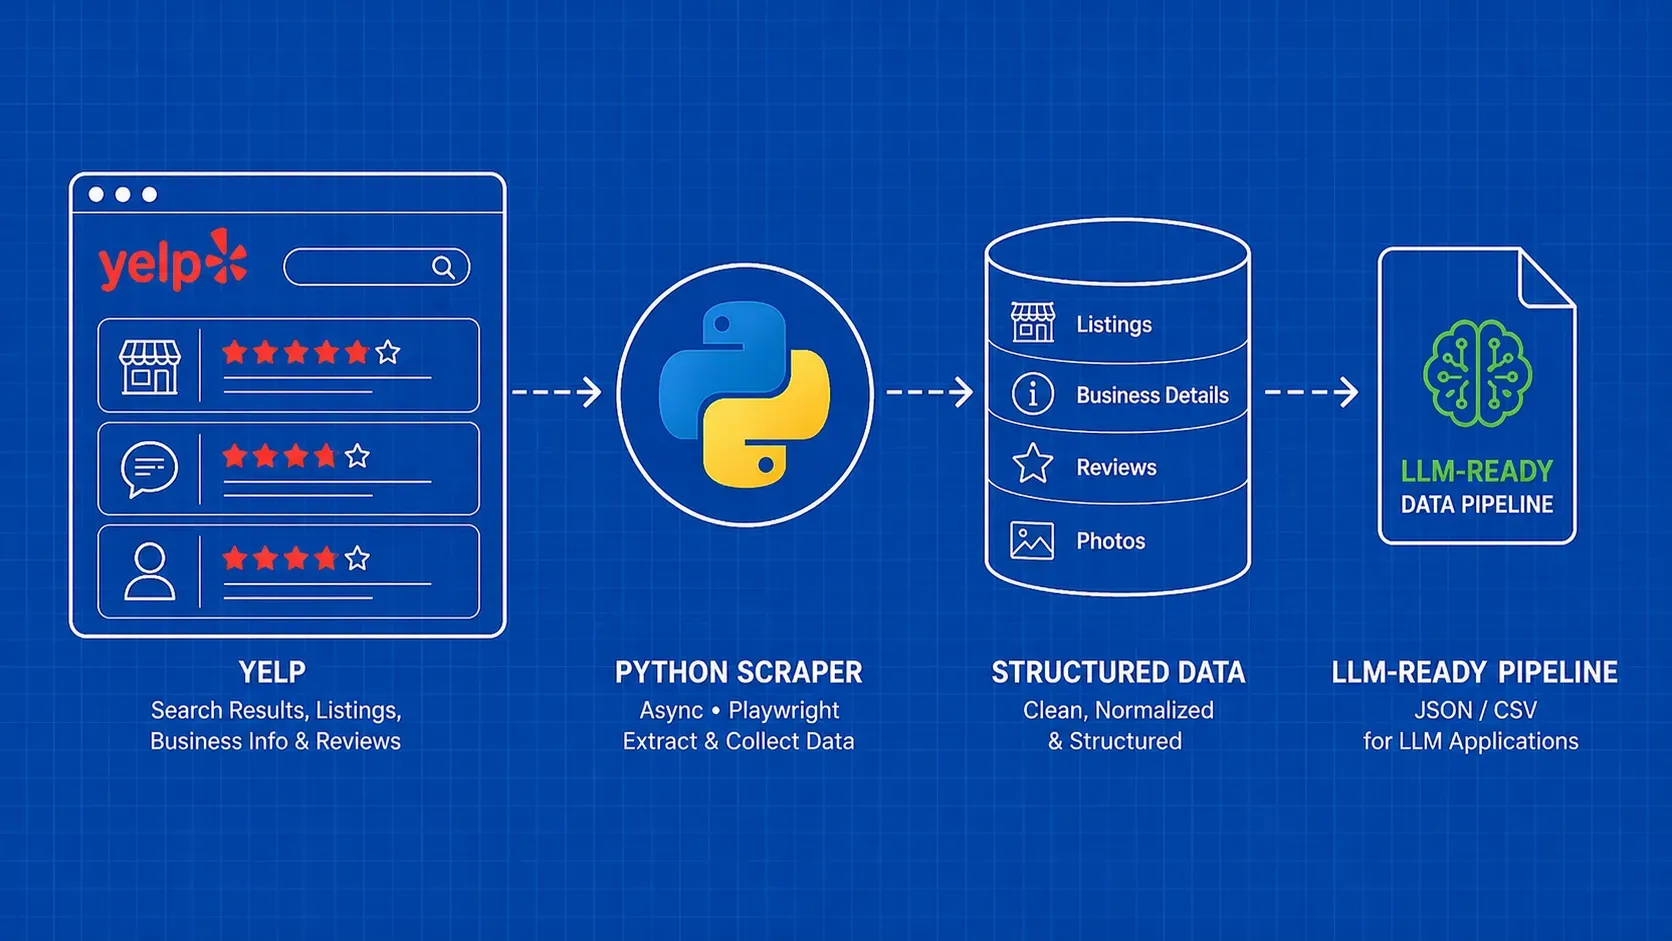
TL;DR: 简要说明:本指南将指导您使用 Python 构建一个完整的 Yelp 搜索工具,包括搜索结果、企业详细信息和评论,并提供工作代码。您还将学习如何处理反僵尸保护、将数据导出为 CSV 或 JSON,以及如何将搜索到的评论输入 LLM 进行情感分析,这是其他 Yelp 搜索教程所不具备的。
TL;DR: 了解如何使用 Node.js 和我们的 API 从 Google 购物中抓取附近的卖家信息。借助我们专业的网页抓取工具,快速轻松地提取有价值的数据。
TL;DR: 简而言之:在快速、确定性的 Puppeteer 提交表单脚本中使用 page.locator(selector).fill(value),在页面观察真实按键(自动完成、反机器人、实时验证)时使用 page.type()。通过点击按钮、按回车键或调用 form.requestSubmit() 提交,并始终等待具体的成功信号,而不是固定的超时。
TL;DR: 简要说明:Pyppeteer 是 Puppeteer 的非官方 Python 移植版本,仍可用于从 asyncio 驱动真正的 Chromium。在本指南中,您将安装它,使用 asyncio.run 和 try/finally 编写 Pyppeteer 现代 Web 刮擦程序,处理等待、表单、截图、无限滚动、cookie 和代理,并了解何时迁移到 Playwright、Selenium 或托管刮擦 API。
TL;DR: 简要说明:本指南介绍了如何使用 Python 端到端网络搜刮沃尔玛产品数据,从解析隐藏的 __NEXT_DATA__ JSON 到使用代理、重试和异步获取进行扩展。它还诚实地说明了什么时候托管的搜刮 API 能胜过 DIY。

TL;DR: 了解使用 Node.js 抓取 Google 购物产品规格的分步指南。通过本教程提升您的网页抓取技能。

TL;DR: 简而言之:Cloudflare 通过将 TLS 指纹识别、JavaScript 挑战、行为分析和 Turnstile 验证码层层叠加到一个综合信任分数中来阻止刮擦。要可靠地绕过 Cloudflare,您需要同时匹配每一层。本指南涵盖了检测堆栈,比较了四种实用工具(Nodriver、SeleniumBase UC、Camoufox、curl-impersonate),并介绍了代理策略、会话持久性、错误排除和生产扩展。

TL;DR: 通过我们的快速入门指南,了解如何像专家一样使用 Web Stealth Proxy。获取分步操作指南,提升您的代理使用技巧,将您的在线隐私保护提升到新高度。立即开始!
TL;DR: TL;DR:这是一本关于如何用 Python 搜刮 YouTube 的 2026 操作手册。你将使用决策矩阵选择正确的方法(Data API v3、yt-dlp、隐藏的 /youtubei/v1/ 端点或托管的 scraper),然后运行代码来处理视频元数据、评论、频道、搜索、Shorts 和转录,其中还有一个关于代理、标头和 429 回退的制作部分,这样你就不会被屏蔽了。
TL;DR: 简而言之:Python 无头浏览器可让您渲染 JavaScript、点击 SPA,以及抓取普通 HTTP 客户端无法访问的网站。Selenium 是最安全的默认设置,Playwright 是新代码的现代选择,Pyppeteer 和 Splash 仍有利基用途,而托管浏览器 API 则是在反僵尸防御或规模开始吃紧时的选择。
TL;DR: 简而言之:应根据具体工作负载选择 Ruby HTML 和 XML 解析器,而非依据通用排名。对于广泛的 HTML 和 XML 树解析,建议首先使用 Nokogiri;针对特定的 XML 任务,可考虑使用 Ox 或 LibXML Ruby;仅当必须由真实浏览器渲染页面或与页面交互时,才添加 Selenium。
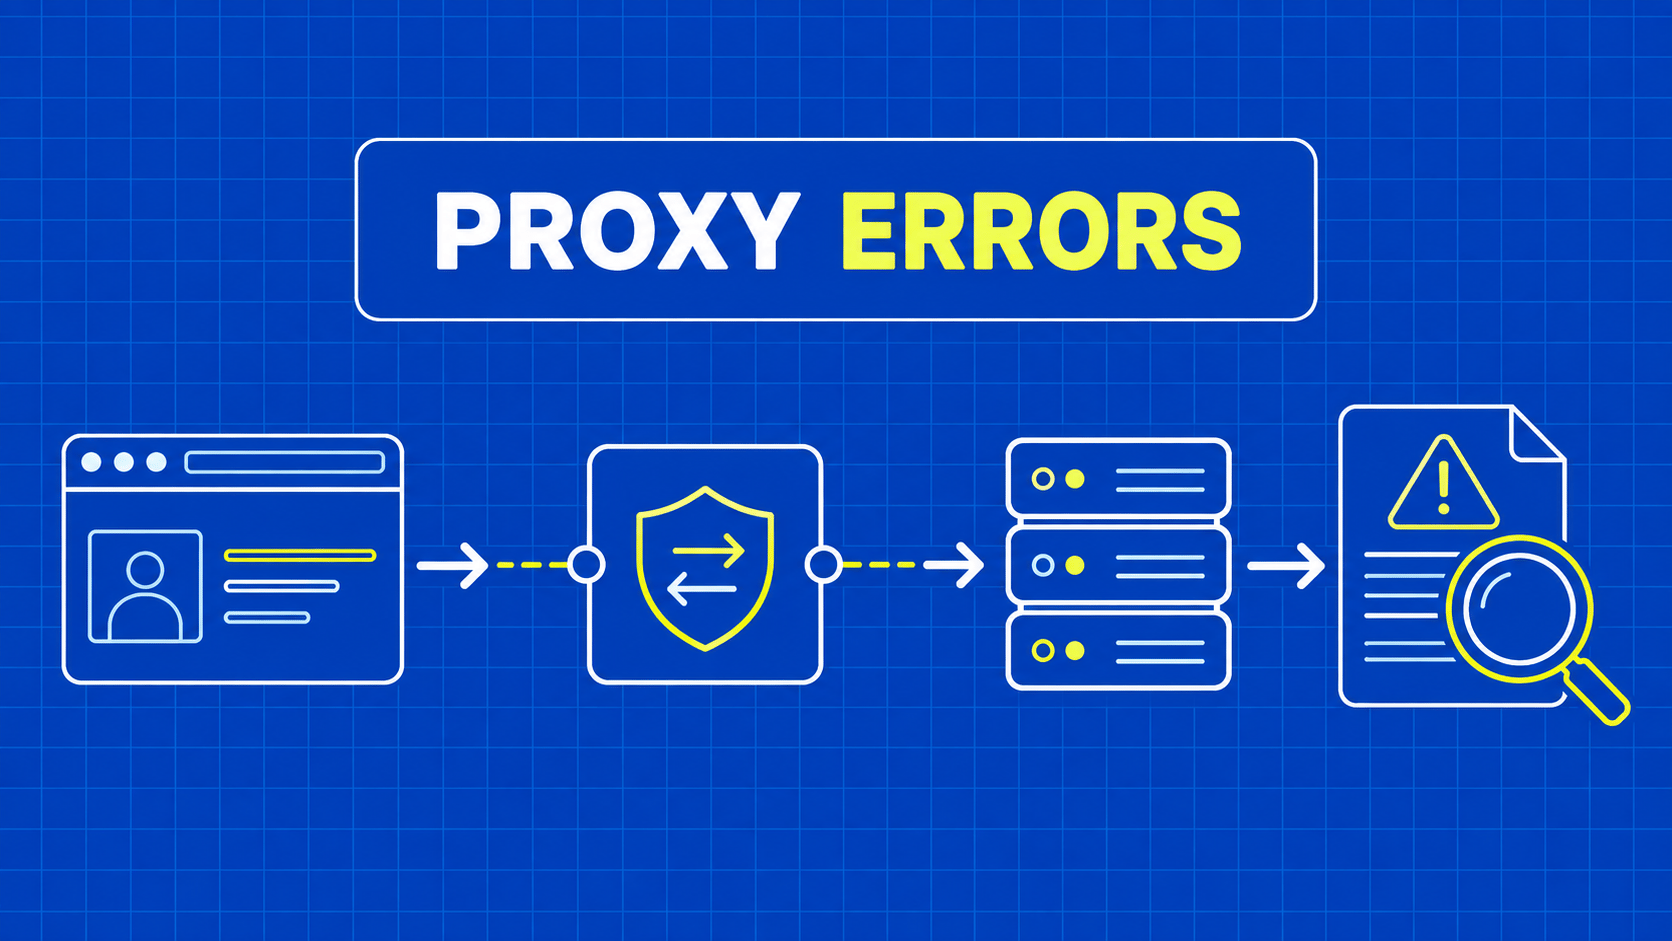
TL;DR: 在重试代理请求之前,请先定位出现故障的跳点。利用状态码、CONNECT 结果以及安全诊断记录,将代理故障与目标响应区分开来。
TL;DR: 简而言之:首先确定表格行是否存在于 HTTP 响应中、是否通过数据请求获取,还是需要浏览器渲染。然后使用下文提到的静态 Axios 和 Cheerio 脚本,或针对性更强的 Puppeteer 方案,在 JavaScript 中抓取 HTML 表格,验证基于表头的记录,去除页面重复项,并安全地写入 CSV 文件。 HTML 表格将信息组织为行和列,通常包含 <table>、<tr>、<th> 和 <td> 元素。在 JavaScript 中抓取 HTML 表格,是指检索或渲染该标记,将每行数据转换为 JavaScript 对象,验证结果,并将其序列化为 CSV 等格式。

TL;DR: 简要说明:Jsoup 是 Java 中用于 HTML 解析的默认库。本指南介绍了整个生命周期(Maven 设置、加载文档、CSS 选择器、DOM 遍历、提取、修改和序列化),以及可运行的刮擦项目、错误处理、分页和将您推向无头浏览器或刮擦 API 的限制。
TL;DR: 简而言之:要以 Python 方式从 HTML 中提取文本,请使用真正的解析器(BeautifulSoup、lxml.html 或 html-text)解析标记,去除脚本、样式和网站 Chrome 浏览器,然后在保存前对空白和 Unicode 进行规范化处理。本指南对主要库进行了比较,修正了常见的清理陷阱,最后提供了一个可运行的爬虫,可写入 JSONL 和每页的 .txt 文件。
TL;DR: TL;DR:这是一本有见地的、端到端的指南,介绍如何在 2026 年使用 Scrapy 进行网页刮擦。你将安装 Scrapy、在外壳中建立选择器原型、构建多页面电子商务蜘蛛、使用 Item Loaders 清理项目、持久化到数据库、加固设置以防封禁,以及为 JavaScript 渲染的页面安装 Scrapy-Playwright。
TL;DR: 简而言之:在 Scrapy 中使用 JavaScript 并不总是需要浏览器。首先应检查原始响应、网络请求和嵌入式页面状态;仅当目标数据确实依赖于浏览器执行时,才添加 scrapy-playwright,然后有针对性地控制等待、交互、清理和并发。
TL;DR: 简而言之:Axios 设置了五层标头:每请求配置、全局默认值、axios.create() 实例、请求和响应拦截器以及响应本身。本指南使用可运行的 v1 代码段对每一层进行了说明,然后修复了咬伤每个人的四个 bug:多部分边界、CORS cookie、自签名证书和标头封装。
TL;DR: 使用 JavaScript 和 Node.js 进行网页抓取:利用原生 fetch 方法和 Cheerio 获取并解析页面,礼貌地爬取分页网站,调用隐藏的 JSON 接口,使用 Playwright 或 Puppeteer 渲染页面,离线测试解析器,并将被屏蔽的页面交由抓取 API 处理,而无需重写代码。

TL;DR: 使用 Ruby 进行网页抓取是指请求网页内容、在 HTML 或浏览器渲染的文档中定位有用值,并使用 Ruby 代码将这些值转换为结构化记录的过程。最易于维护的方法是使用能够可靠访问数据的、最轻量级的技术栈。
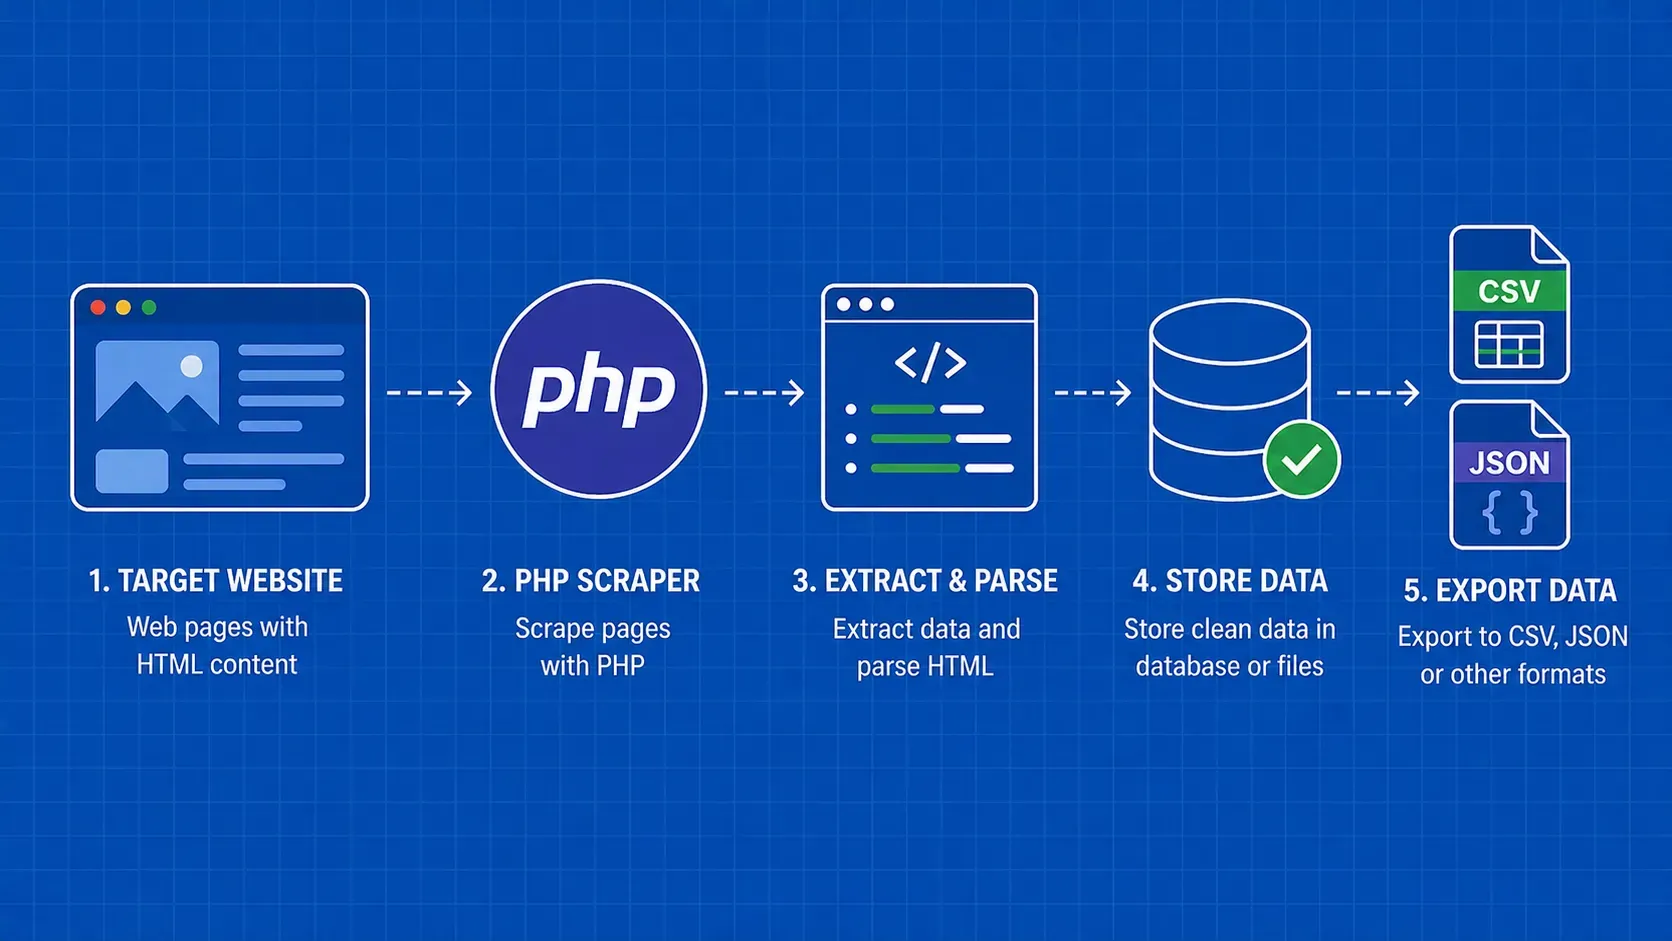
TL;DR: 简而言之:由于内置了 cURL 和 DOMDocument 等扩展,再加上包括 Guzzle、Symfony DomCrawler 和用于无头浏览的 Symfony Panther 在内的丰富的 Composer 生态系统,PHP 完全有能力胜任 Web 搜索。本指南将指导您完成整个工作流程:获取页面、解析 HTML、将结果存储到 CSV/JSON/MySQL、处理错误以及避免阻塞。
TL;DR: 简而言之:Cheerio 是一款适用于 Node.js 的快速 HTML 解析器,提供 jQuery 风格的 API,因此当数据已经存在于页面的原始 HTML 中时,非常适合网页抓取。静态页面使用 fetch 加 Cheerio;如果页面通过 JSON 加载数据,就直接调用该 JSON;只有当内容由 JavaScript 构建时才用浏览器渲染。本指南构建一个经过测试的爬虫,支持分页、重试以及 JSON 或 CSV 导出。
TL;DR: 简要说明:这本 XPath 小抄涵盖了网络搜刮实际需要的语法、谓词、轴和函数,还有 CSS 到 XPath 转换表和可运行的 Puppeteer 和 Scrapy 示例。下次当你依赖的网站上的 CSS 选择器悄无声息地崩溃时,你可以将它作为桌面参考。

TL;DR: 简而言之:在 Python 中使用 cURL 有三种合理的方法:使用子进程 shell out 到 curl 二进制文件,通过 PycURL 绑定到 libcurl,或者完全跳过 curl 而使用 Requests 库。了解如何在 Python 中很好地使用 cURL 意味着对这三种方法都了如指掌。本指南将为你提供这三种方法的可运行示例、curl-flag-Python 转换表和决策矩阵,以便你第一次就能选择正确的工具。

TL;DR: 了解如何使用新发布的 node-fetch 直接从 Node.js 发起 HTTP 请求。node-fetch 相当于 JavaScript 中的 fetch API

TL;DR: 为您的爬虫选择合适的 Python HTTP 客户端。通过实际示例和可靠性建议,对比分析 Requests、HTTPX、aiohttp、urllib3、curl_cffi 和 Niquests。

TL;DR: 简要说明:Scraping LinkedIn 意味着要绕过咄咄逼人的认证墙、行为跟踪和 TLS 指纹识别。本指南为您提供了按页面类型划分的方法决策树,适用于工作、个人资料和公司的 Python 工作模式(必要时使用隐藏 API、JSON-LD 和 Selenium),以及 2026 年的综合防拦截清单。

TL;DR: 简要说明:2026 年的 12 款最佳免费网络搜刮工具分为四类:管理 API(免费积分)、开源框架、无代码浏览器扩展和人工智能提取器。首先根据使用情况(一次性搜索与计划管道)进行选择,然后根据技能水平进行选择。大多数免费层级包括评估,而非生产;一旦你的成功率低于 90%,或者你在区块上花费的时间多于数据,就该升级到付费 API 了。
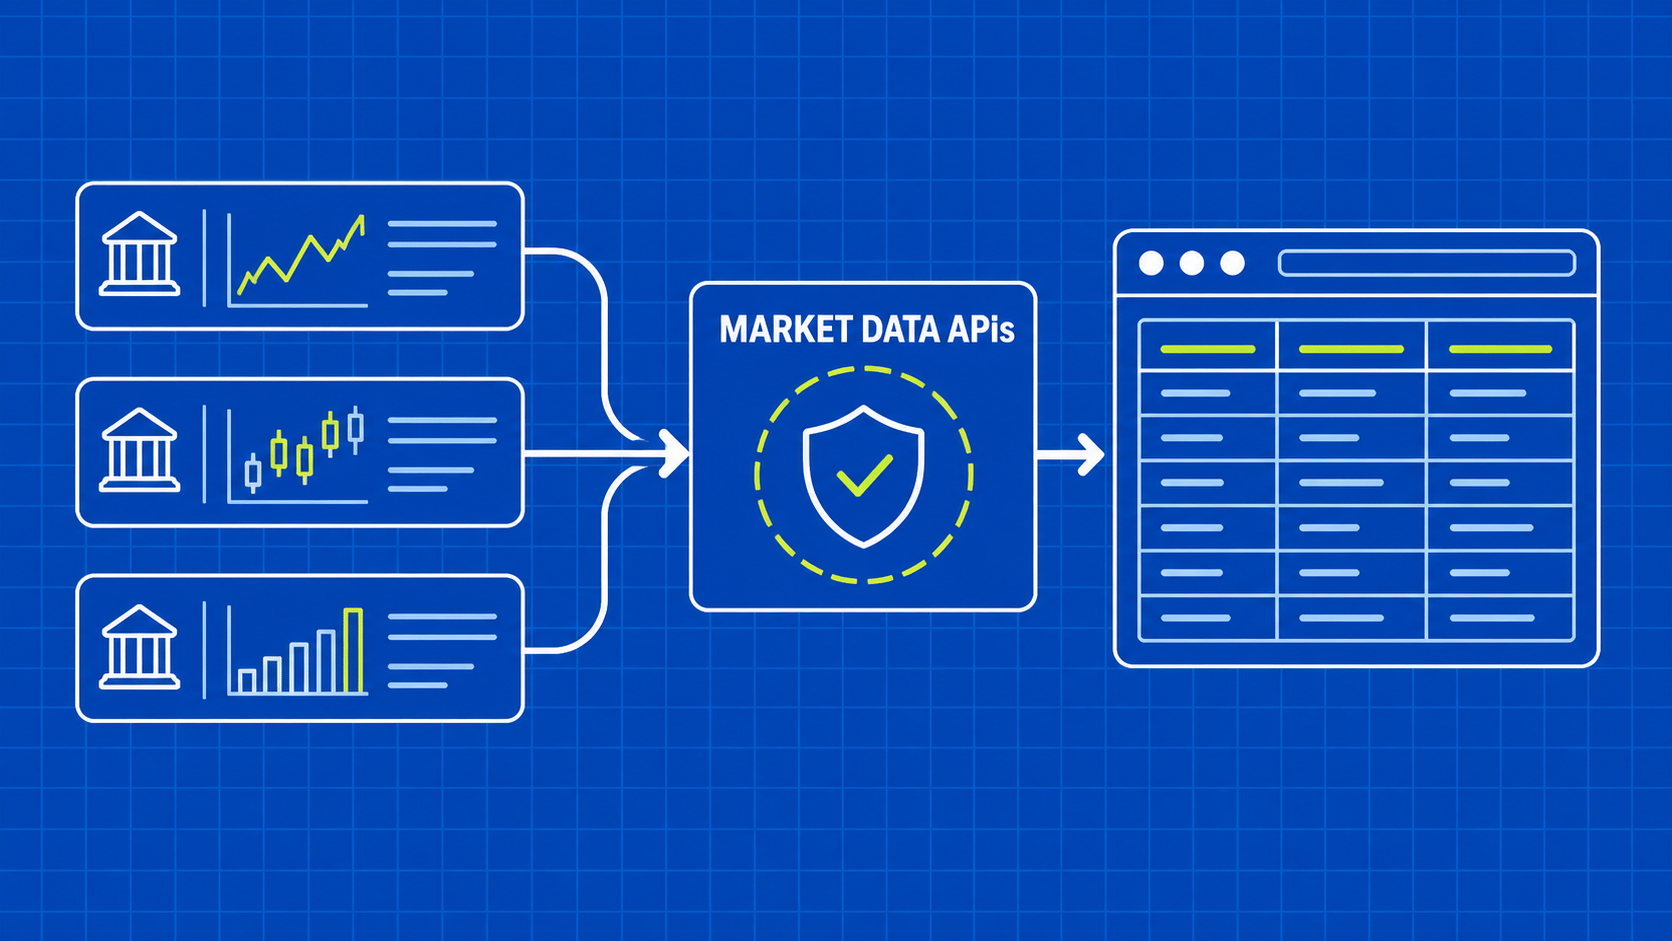
TL;DR: 对比各家有记录的市场数据提供商,然后在明确数据源、时区、调整、许可和验证要求的基础上进行迁移。

TL;DR: 简要说明:网络搜索合法吗?通常是,但有注意事项。合法性取决于数据类型、访问路径、所涉及的司法管辖区以及你对输出结果的处理方式。本指南将为您提供直接判断、5 分钟的预搜索框架、重要案例,以及可在发布前运行的检查清单。
TL;DR: 探索9款顶尖的Google图片搜索API工具,实现高效的图片抓取。了解如何利用这些强大的API优化图片搜索,并提升数据采集效率。

TL;DR: 简而言之:糟糕的代理服务器代价高昂。它们会消耗带宽、触发封禁,并悄无声息地破坏你的 scraper 所依赖的数据。本指南介绍了如何使用 ping、curl、在线检查器、IP 数据库和一个可重复使用的 Python 脚本来测试代理的五个健康信号(连接性、出口 IP、速度、匿名性和声誉),您可以将其放入您的 CI 管道中。
TL;DR: 简而言之:最佳网页抓取 API 取决于任务:静态 HTML 选便宜的页面 API,大量依赖 JavaScript 的应用选渲染选项或托管浏览器,需要解析好的记录选 SERP 或电商端点,LLM 管道则选以 Markdown 为主的 API。先筛选两三家服务商,再用您自己的 URL 比较每个可用页面的成本,因为积分倍率和失败请求计费才决定真实成本。
TL;DR: 简而言之:webscraper.io 的 Web Scraper 是一款免费的 Chrome 和 Firefox 扩展,另有付费的 Web Scraper Cloud,适合在普通公开网站上执行中小规模的周期性任务。如果只有几个人每天或每周刷新少数网站,并且有人维护选择器,就继续使用它。如果您需要抓取大量网站、受保护或大量依赖 JavaScript 的目标,或需要代码级控制,请换用其他方案。
TL;DR: 了解 Cookie 存储、浏览器策略和会话所有权如何影响抓取到的响应。学习如何在不泄露凭据的情况下诊断身份验证失败。
TL;DR: 通过一个测试完整交付工作流的试点项目,从项目配置、执行、导出和维护等方面对 Octoparse、ParseHub、Web Scraper 和 Apify 进行对比。
TL;DR: 构建具有显式运行标识、有限重试次数、验证功能以及重放安全交付能力的定时收集器。了解如何在不隐藏缺失数据的情况下恢复故障。
TL;DR: 为网站审计、自定义爬取、浏览器交互、视觉数据提取或数据集清理找到合适的替代方案,然后通过试点项目验证此次切换的可行性。
TL;DR: 选择一种适用于各种布局或精确模板规则的文章提取器,然后在您自己的语料库上测试文本保真度、元数据、结构以及错误处理情况。

TL;DR: 简而言之:Puppeteer 是快速实现 Chromium 自动化的好帮手,但它的单一浏览器锁定、资源繁重的扩展性和零内置反僵尸支持等问题,促使许多团队转向其他替代方案。本指南按使用案例(刮擦、E2E 测试、跨浏览器 QA、移动)细分了最强大的 Puppeteer 替代品,为您提供了并排比较表,最后还提供了一个决策框架,让您无需反复试验就能选择合适的工具。
TL;DR: 构建一个具有明确就绪状态、经过验证的记录以及可靠停止条件的浏览器采集器。了解在何种情况下,DOM 提取比截图和 OCR 更可取。
TL;DR: 根据调试任务,对比分析 mitmproxy、Fiddler Everywhere、HTTP Toolkit 和 Proxyman。通过受控测试来验证数据捕获、证据共享和证书清理功能。
TL;DR: 根据数据提取的所有权和交付需求,对比 Octoparse、Browse AI、Apify 和 Scrapy。构建一个试点项目,用于验证数据的完整性、时效性以及迁移准备情况。
TL;DR: 设计一个网站收集器,涵盖从记录定义到交付验证的整个流程。界定源数据范围,选择执行模型,验证观察结果,并恢复未完成的运行。
TL;DR: PhantomJS 已于 2018 年停止开发。请根据您的脚本原有的功能选择替代方案,将 PhantomJS 的调用映射到 Playwright 或 Puppeteer,并清理旧的依赖项。
TL;DR: 简而言之:正确的选择取决于 Scrapy 的瓶颈是渲染、阻塞、语言适配还是操作。 在可能的情况下保留或扩展运行良好的爬虫;对于交互式页面,使用浏览器工具;对于操作类任务,使用托管平台;对于范围有限的静态任务,使用轻量级技术栈;当请求基础设施成为限制因素时,使用托管 API。通过成本模型和具有代表性的概念验证来验证候选方案。
TL;DR: 根据建模方式对比 Octoparse、Browse AI、Apify 和 Playwright。在替换 Web Scraper 时,保留导航、记录身份及交付行为。
TL;DR: 在产品数据提取方面,对比 Octoparse、ParseHub、Web Scraper 和 Apify。在替换 WebHarvy 之前,请验证产品变体、优惠信息、缺货商品以及导出数据。
TL;DR: 根据任务、证据来源和交付需求,比较各种产品研究方案。构建可重复的试验方案,同时避免将预估需求与经核实的销售额混为一谈。
TL;DR: 简而言之:Wget 虽然可靠,但已经老化。如果需要并行下载,可以使用 aria2。如果需要广泛的协议覆盖范围和脚本,curl 是首选。想要更友好的 API 测试工作流程?HTTPie(或它的 Rust 兄弟 xh)就非常适合。如果你想要最接近的升级路径,wget2 会添加 HTTP/2、多线程和插件系统,同时保留你已经熟悉的命令模式。
TL;DR: 简而言之:在支持的 Node.js 版本中,建议优先使用原生 Fetch,仅当需要替换具有实质意义的自定义代码时才添加依赖项。Axios 侧重于跨运行时的便捷性,Got 提供更深入的 Node.js 特定控制,Ky 提升了 Fetch 的易用性,而 SuperAgent 则适合流畅的表单和文件处理工作流。 无论您选择哪种方案,在迁移过程中都要保留状态、超时、重试、Cookie 以及流的行为。
TL;DR: 用 rvest 和 httr2 学习 R 语言网页抓取:解析页面和表格、跟随分页、处理 JavaScript、调用抓取 API,并用本地保存的页面做测试。
TL;DR: 在遵循旧版“Profit Scraper”建议之前,请先验证当前服务的身份。针对商品列表数据、成交价调研以及透明的成本假设,构建一套替代工作流。

TL;DR: 这是一份关于使用 Elixir 进行网页抓取的完整指南。了解如何使用这种最适合并发编程的语言之一来构建网页抓取工具。

TL;DR: Rust 是一种运行速度快且内存利用率高的编程语言。但它在处理网页抓取方面表现如何呢?请阅读这篇适合初学者的指南,了解如何使用它来构建一个基础的网页抓取工具。
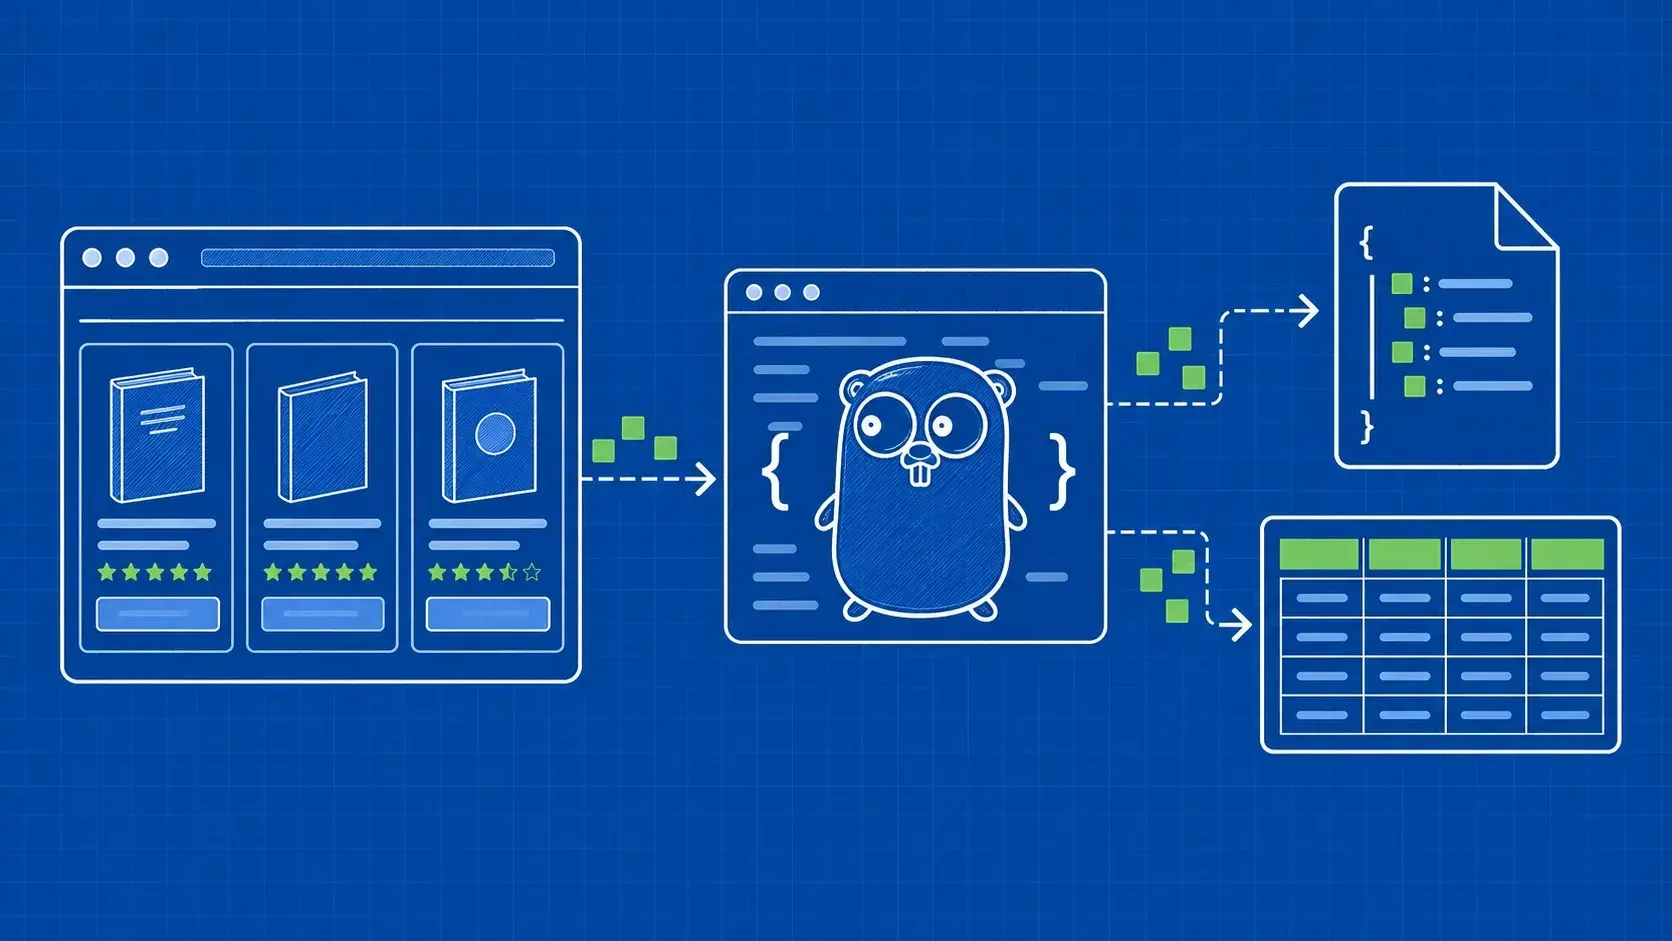
TL;DR: 构建一个 Go 爬虫,用于将图书记录提取为 JSON。先参考一个经过测试的 goquery 示例,然后规划分页、Colly、浏览器渲染和错误处理。
TL;DR: 根据保留工作量对 Web Scraper、Browse AI、Apify 和 Scrapy 进行比较。在替换 Octoparse 之前,应进行受控的可修复性测试,并验证交付成果是否完整。
TL;DR: 简而言之:在 C# 中进行网页抓取,请从 .NET 10 入手:用内置的 HttpClient 下载网页,用 AngleSharp 通过 CSS 选择器解析 HTML。如果您更喜欢 XPath 或需要维护旧代码,请选择 HtmlAgilityPack;当页面由 JavaScript 构建时,再加入 Playwright for .NET。本指南构建一个爬虫,涵盖礼貌重试、有界爬取、CSV 和 JSON 导出以及离线测试。

TL;DR: 简而言之:2026 年最好的 Node.js Web 搜刮工具分为两大阵营:HTTP 客户端(如用于静态页面的 Axios 和 Superagent)和无头浏览器(如用于 JavaScript 繁重网站的 Puppeteer 和 Playwright)。根据工作流而非受欢迎程度进行选择,一旦反僵尸防御或规模开始占用你的工程时间,就将渲染卸载到托管的刮削 API。
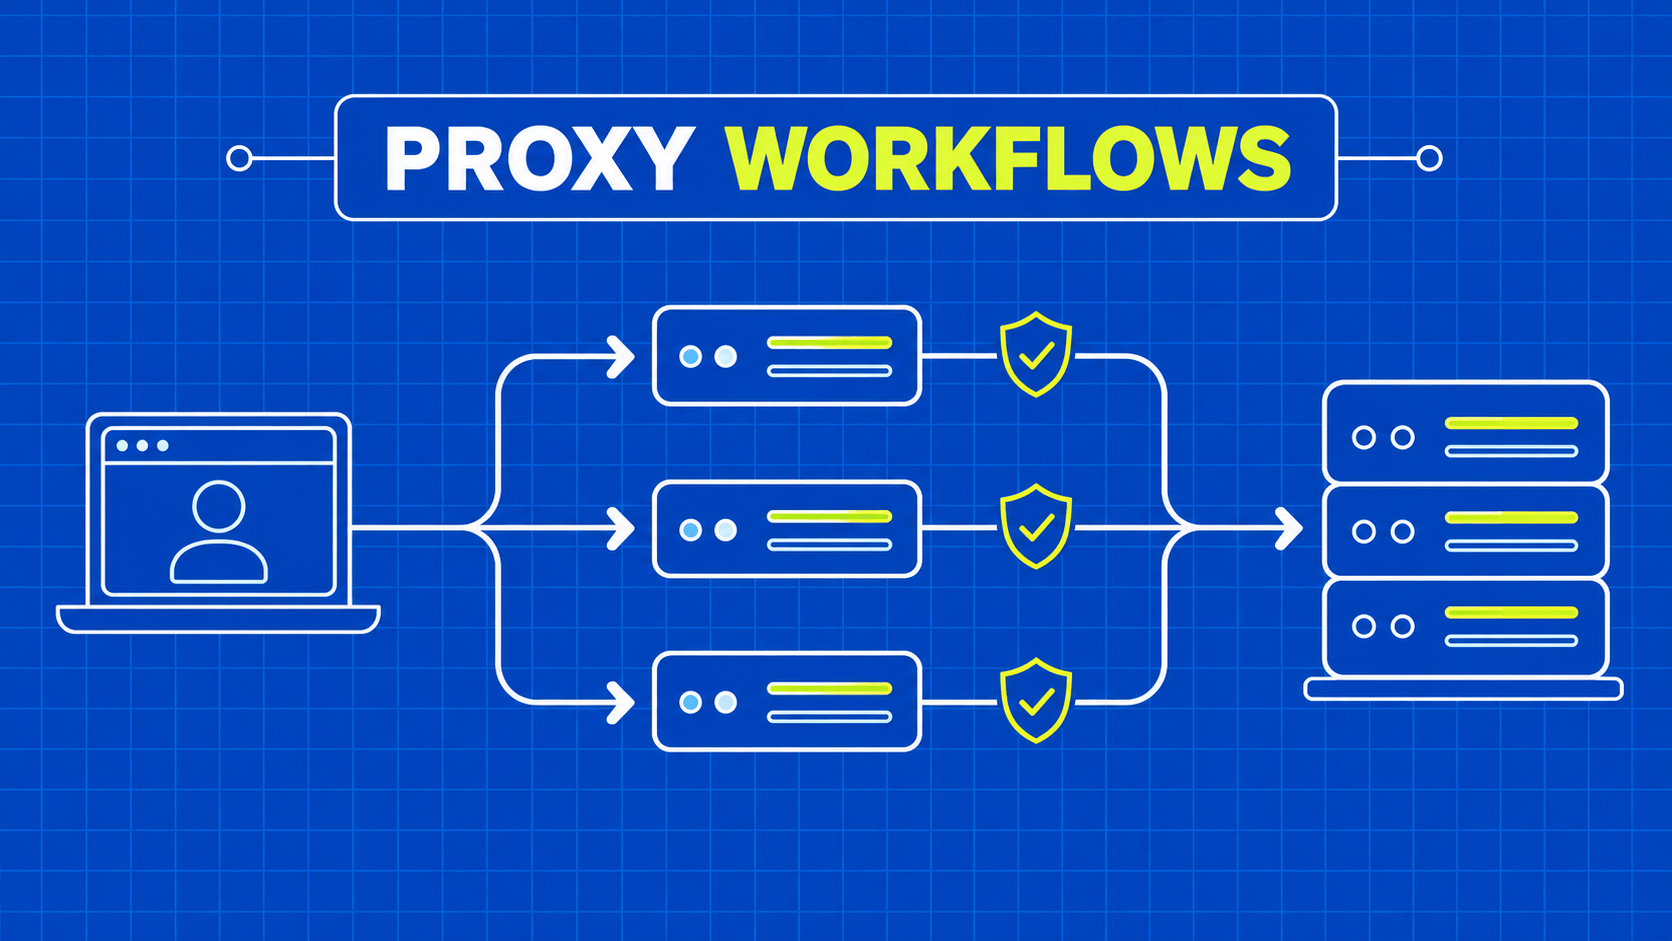
TL;DR: 根据会话行为、数据来源以及每条接受记录的成本,对比代理网络和托管数据获取方案。采用受控测试和可逆迁移计划。
TL;DR: 简而言之:若需轻量级的基础方案,请使用原生 Fetch;若需提升 Fetch 的易用性,请使用 Ky;若需更丰富的客户端行为,请使用 Got 或 SuperAgent;若前端请求状态是真正的需求,则请使用 Alova。 仅当渲染、交互、代理或反机器人系统导致普通 HTTP 传输无法满足需求时,才选择 Puppeteer 或托管式爬虫 API。

TL;DR: 对于新产品来说,定价往往令人头疼。不过,有一个解决办法:从电商巨头那里抓取数据,并根据清晰的数据来定价。
TL;DR: 简要说明:Puppeteer 可让你在 Node.js 中完全控制一个无头 Chrome 浏览器实例,使其成为刮削 JavaScript 渲染页面的首选工具。本指南将指导你完成安装、基于选择器的提取、无限滚动、表单登录、请求拦截、隐身插件、结构化数据导出和 Docker 部署,这样你就可以从一个玩具脚本变成一个生产级的搜刮器。
TL;DR: 学习如何用 Python 抓取房地产数据:选择数据源,解析房源列表和 JSON-LD,核查各房产门户的使用条款,并通过开放数据获取房价。
TL;DR: 简要说明:这篇 BeautifulSoup 教程将引导您完成一个完整的 Python scraper,从 pip 安装到一个加固的脚本,该脚本可以分页浏览 Hacker News、导出为 CSV 和 JSON,并保持足够的礼貌以免被屏蔽。每个片段都可运行,我们还指出了 BeautifulSoup 是错误工具的确切时刻。
TL;DR: 简而言之:当返回的 HTML 中包含数据时,先使用 HttpClient 和 Jsoup;在适当的情况下调用公开的 JSON 数据源;仅在涉及浏览器相关状态时才添加渲染或使用 Selenium。 本 Java 网络爬虫教程通过分页、并发限制、重试、会话管理、数据验证和持久化输出,逐步扩展一个 Java 21 代码库。
TL;DR: 简要说明:Selenium 可让您通过 Python 代码驱动真实浏览器,从而刮擦 JavaScript 繁重的网站。本教程将指导您完成每个阶段的工作:安装 Selenium、配置 Chrome 浏览器、定位元素并与之交互、处理等待和分页、导出干净的数据,以及使用代理、Selenium Grid 和基于 API 的替代方法扩展您的 scraper。
TL;DR: 使用 libcurl 和 lexbor 在 C 和 C++ 中抓取网站:利用 CMake 和 vcpkg 构建一个“礼貌型”的 C++20 爬虫,导出格式规范的 CSV 和 JSON 文件,通过三种方式处理 JavaScript 页面,并用纯 C 语言运行相同的抓取程序。
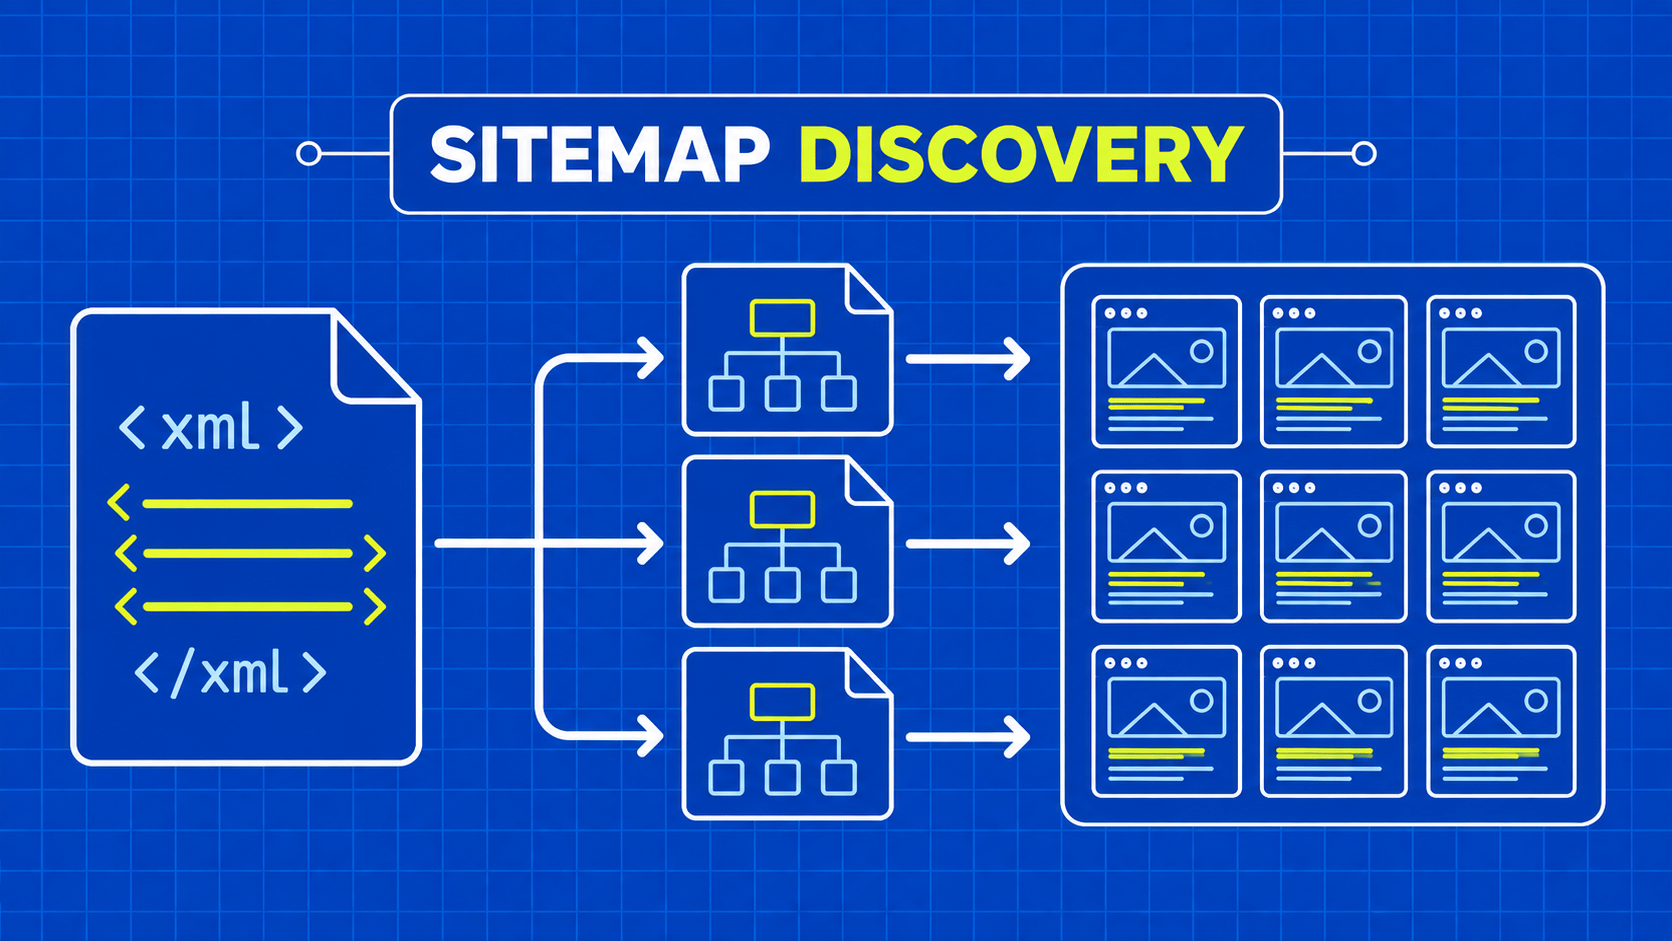
TL;DR: 将网站地图索引转化为可追踪的 URL 发现队列。了解支持命名空间的解析、协议限制、数据时效性注意事项,以及针对不可信 URL 的安全边界。
TL;DR: 请先将密钥设置为环境变量,并发送您的第一个 WebScrapingAPI 爬虫 API 请求,随后仅在目标需要时,再添加 JavaScript 渲染、地理定位、数据提取规则和异步任务。 本指南涵盖了所有已记录的错误代码、按调用计费的跟踪机制、截至 2026 年 10 月的套餐方案、何时应选择浏览器 API、搜索结果页面 (SERP) API、爬虫 API 或数据 API,以及如何通过 Web MCP 连接 AI 代理。
TL;DR: 简而言之:这是一份实操性的 Python 网页爬取指南,首先介绍决策树,随后逐步讲解 Requests 配合 Beautiful Soup、lxml 实现的 XPath、Playwright、Selenium、Scrapy,以及针对高难度目标的爬取 API。 完成本指南后,您将获得可运行的代码、一套反封锁策略、适用于大型语言模型(LLM)的存储模式,以及一份生产环境检查清单。