跳至内容
免费开始
返回博客

使用 Go 进行网页抓取:构建一个可靠的 HTML 抓取工具

Sorin-Gabriel Marica最后更新于 2 min read
使用 Go 进行网页抓取:构建一个可靠的 HTML 抓取工具
简而言之:使用 Go 进行网页抓取时,请使用 net/http 来获取静态 HTML,并使用 goquery 通过 CSS 选择器提取字段。从单个页面开始,验证每一条记录,并导出 JSON。若目标页面需要,可添加 Colly 进行爬取调度,或使用浏览器处理纯 JavaScript 内容。下面的完整示例包含超时设置、响应限制、状态检查以及显式的解析错误处理。

一个仅输出一次标题的爬虫很容易演示。而在 Go 应用程序中,一个能在页面发生变化、请求失败或字段消失时通知你的爬虫则要实用得多。这种差异源于你在数据获取、解析和导出过程中所构建的边界。

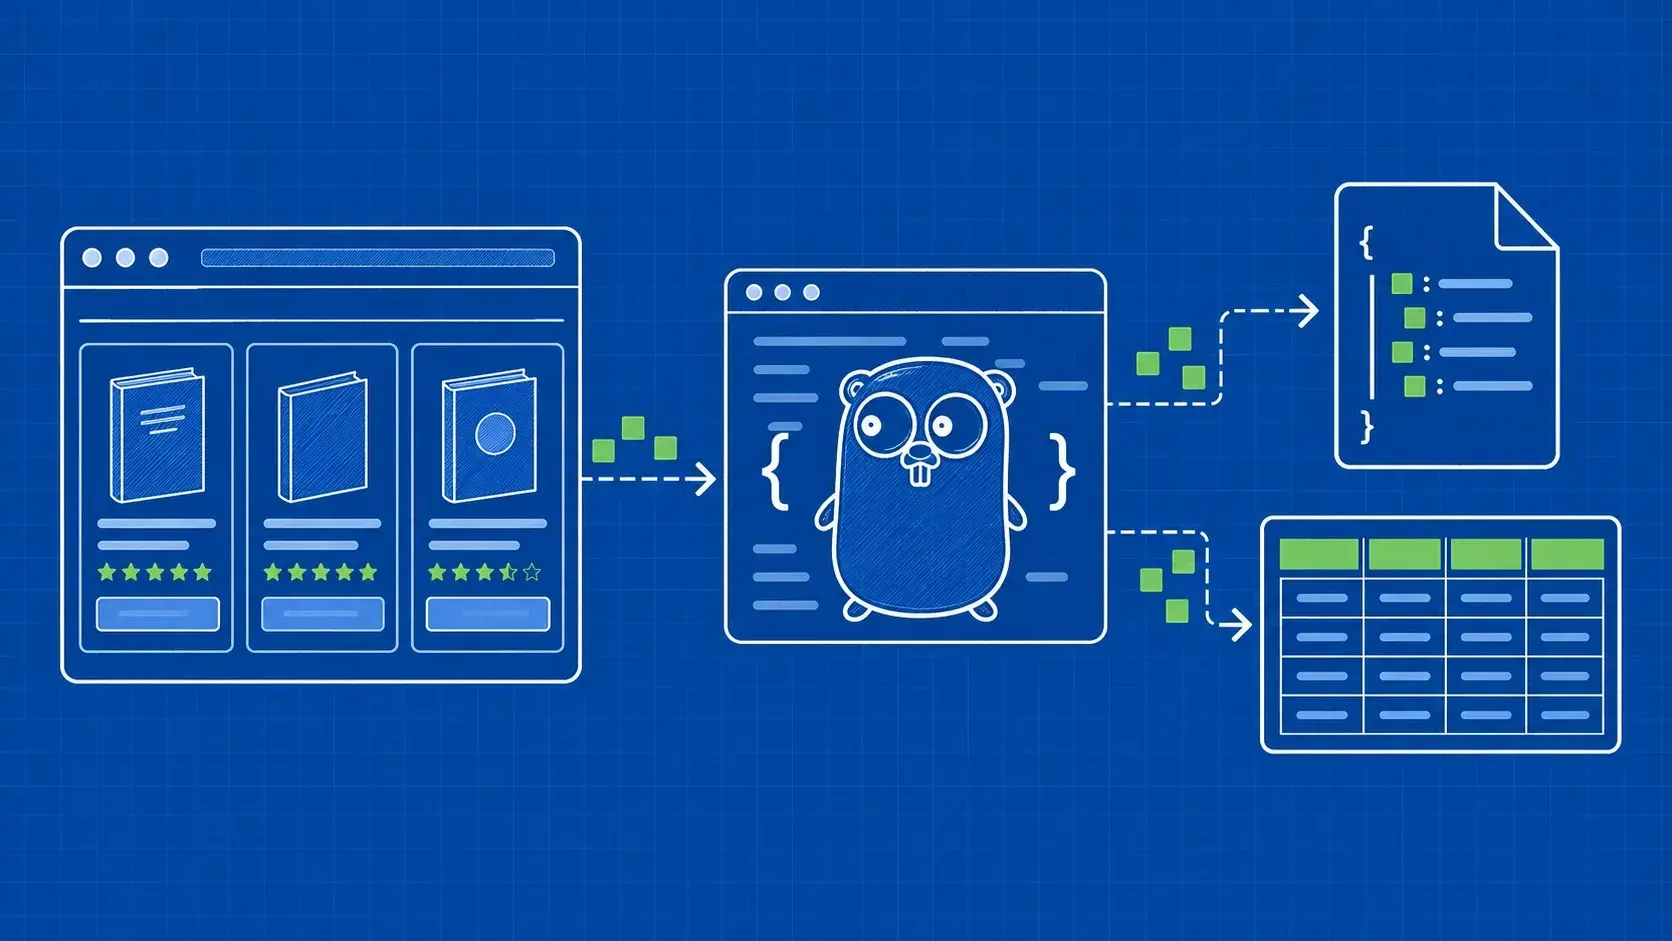
本指南将通过一个书店示例,逐步讲解如何使用 Go 语言进行网页抓取。您将创建一个模块,抓取商品目录页面,提取图书记录,并写入 JSON 文件。该程序已完整实现,因此您可以在将选择器适配到其他数据源之前先运行它。 你应该已经熟悉 Go 中的函数、结构体、错误返回以及基本的命令行操作。

这种方法适用于许多 Go 语言的网页抓取项目:首先定义输出字段,检查源 HTML,并使缺失的数据可视化。接下来,我们将探讨分页、Colly、浏览器渲染和测试,以便您在扩展初始版本时仍能掌控其行为。

请确保初始成功标准具体明确:请求的单个页面应返回一组有效的图书记录,或者返回一个说明无法返回原因的错误。这为你提供了有用的衡量标准,以便在添加更多页面或 worker 之前进行评估。
使用 Go 进行网页抓取:选择合适的工具

首先将页面获取、HTML 解析和浏览器执行分离。即使某个库将其中几项打包在一起,它们仍是不同的任务。对于 HTML 响应中已包含所需记录的页面,仅需一个 HTTP 客户端和解析器即可。

工具

职责

有用的起点

net/http

发送请求并读取响应

您希望对请求和错误进行显式控制

goquery

选择并读取 HTML 元素

你需要对下载的内容使用 CSS 选择器

Colly

协调请求和回调

您需要导航规则和爬取调度

chromedp

通过 CDP 控制浏览器

该页面需要执行 JavaScript 或进行交互

下面的示例结合了 net/http 与 goquery 结合使用。这样可以保持 fetch 和 parse 函数足够简洁,以便单独测试。选择器的更改无需通过网络请求进行验证,且 HTTP 错误也不会被提取代码所掩盖。

当调度工作量较大时,请使用 Colly。在检查响应并确认初始 HTML 中不包含相关字段后,再启动浏览器。运行浏览器并不意味着提取的值自动正确。

对于使用 Go 进行网页抓取,这一选择通常比比较语言运行速度更为重要。选择能返回解析器实际所需内容且最简单的工具,然后验证生成的记录。

设置可重现的 Go 模块

在任何现有 Go 模块之外创建一个目录,并初始化一个小型项目:

mkdir go-book-scraper
cd go-book-scraper

go mod init example.com/book-scraper
go get github.com/PuerkitoBio/goquery@v1.13.0

该示例已在 Go 1.26.2 和 goquery 1.13.0 环境下测试通过。此固定版本的 goquery 在其模块元数据中将 Go 1.25.0 声明为最低支持版本。请使用兼容的工具链,而非盲目采信旧教程中关于最新 Go 版本的陈述。

保留 go.mod 并 go.sum 文件保留在项目中。Go 的依赖管理指南解释了模块要求和校验和如何支持可重现的构建。请有意识地更新依赖项,并在更新后重新运行解析器测试。

我们的目标是“Books to Scrape”,这是一个用于抓取练习的模拟书店。其目录包含带有标题、价格和链接的产品卡片。本示例假设 HTML 采用 UTF-8 编码,每次调用处理一个目录页面。这种刻意缩小的范围,使得在添加导航或并发工作者之前,更容易检查使用 Go 进行的网页抓取过程。

构建一个经过测试的 HTML 转 JSON 爬虫

将以下完整程序保存为 main.go。该程序提取每本书的完整书名、显示价格和绝对商品 URL。它将价格保留为包含货币符号的源字符串,而非在首次提取步骤中引入数值转换。

这些选择器专为此练习站点设计。每个 article.product_pod 都是一个记录容器, h3 a 用于存储书籍链接和完整书名属性,而 .price_color 则存储显示价格。请读取每个卡片(card)内的字段,以确保某本书的标题不会意外地与另一本书的价格配对。

package main

import (
	"bytes"
	"context"
	"encoding/json"
	"fmt"
	"io"
	"log"
	"net/http"
	"net/url"
	"os"
	"strings"
	"time"

	"github.com/PuerkitoBio/goquery"
)

const maxBody = 2 << 20 // A 2 MiB limit chosen for this tutorial.

type Book struct {
	Title string `json:"title"`
	Price string `json:"price"`
	URL   string `json:"url"`
}

func parseBooks(r io.Reader, base *url.URL) ([]Book, error) {
	doc, err := goquery.NewDocumentFromReader(r)
	if err != nil {
		return nil, fmt.Errorf("parse HTML: %w", err)
	}
	cards := doc.Find("article.product_pod")
	if cards.Length() == 0 {
		return nil, fmt.Errorf("no book cards found")
	}
	books := make([]Book, 0, cards.Length())
	for _, node := range cards.Nodes {
		card := goquery.NewDocumentFromNode(node)
		link := card.Find("h3 a").First()
		title, _ := link.Attr("title")
		href, _ := link.Attr("href")
		price := strings.TrimSpace(card.Find(".price_color").Text())
		title = strings.TrimSpace(title)
		href = strings.TrimSpace(href)
		if title == "" || href == "" || price == "" {
			return nil, fmt.Errorf("book card has a missing required field")
		}
		target, err := base.Parse(href)
		if err != nil || (target.Scheme != "http" && target.Scheme != "https") {
			return nil, fmt.Errorf("book card has an invalid link")
		}
		books = append(books, Book{Title: title, Price: price, URL: target.String()})
	}
	return books, nil
}

func fetchBooks(ctx context.Context, client *http.Client, target string) ([]Book, error) {
	req, err := http.NewRequestWithContext(ctx, http.MethodGet, target, nil)
	if err != nil {
		return nil, err
	}
	req.Header.Set("User-Agent", "GoBookTutorial/1.0")
	resp, err := client.Do(req)
	if err != nil {
		return nil, fmt.Errorf("fetch page: %w", err)
	}
	defer resp.Body.Close()
	if resp.StatusCode != http.StatusOK {
		return nil, fmt.Errorf("unexpected HTTP status: %s", resp.Status)
	}
	body, err := io.ReadAll(io.LimitReader(resp.Body, maxBody+1))
	if err != nil {
		return nil, fmt.Errorf("read body: %w", err)
	}
	if len(body) > maxBody {
		return nil, fmt.Errorf("response exceeds 2 MiB")
	}
	return parseBooks(bytes.NewReader(body), resp.Request.URL)
}

func run(w io.Writer, target string) error {
	client := &http.Client{Timeout: 15 * time.Second}
	defer client.CloseIdleConnections()
	books, err := fetchBooks(context.Background(), client, target)
	if err != nil {
		return err
	}
	encoder := json.NewEncoder(w)
	encoder.SetIndent("", "  ")
	return encoder.Encode(books)
}

func main() {
	target := "https://books.toscrape.com/"
	if len(os.Args) > 1 {
		target = os.Args[1]
	}
	if err := run(os.Stdout, target); err != nil {
		log.Fatal(err)
	}
}

运行程序,并在成功提取数据后才写入其 JSON 输出:

go run . > books.tmp.json && mv books.tmp.json books.json

在已检查的第一页中,第一条记录是“A Light in the Attic”,显示价格为“£51.77”,并包含一个绝对产品 URL。在修改示例代码之前,请检查输出中的这三个字段。仅凭可读的 JSON 文件并不能证明选择器捕获了预期值。

临时输出文件可避免在后续请求失败时,用空文件覆盖你上一次成功获取的数据集。标准输出包含 JSON 文档;错误则发送到标准错误输出,并产生非零退出状态码。

HTTP 客户端的超时时间为 15 秒。fetch 函数还将响应大小限制为 2 MiB,这是本教程中设定的限制,而非通用的页面大小建议。该函数会额外读取 1 字节,因此超大文档会明确报错,而非被默默截断为 HTML 片段。

请求的上下文会被传递给客户端。在更大的程序中,请将 context.Background() 调用边界处的代码替换为任务上下文,以便取消操作能终止正在进行的工作。Go HTTP 文档还指出一个重要区别:诸如 404 之类的响应可能在没有传输错误的情况下到达。这就是为什么状态检查与 err.

解析操作相分离——当预期卡片结构或必填字段缺失时,解析会返回错误。本示例会直接拒绝该页面,而非生成部分填充的结果。这是一种策略选择,您可以在后期进行更改,但请务必明确操作:若您的生产管道接受部分输出,请记录被拒绝的行。

最后,产品链接是根据最终响应 URL 解析的。当页面发生重定向或使用相对链接时,这一点尤为重要。代码会在导出链接前验证链接方案;它不会追踪这些产品 URL。

对于使用 Go 语言进行网页抓取,这些边界为您提供了有用的基准:请求错误、页面大小限制、选择器失败以及输出错误仍会清晰可见。在将生成的记录视为完整数据集之前,仍需进行应用程序特定的检查。

在不进行无限制爬取的情况下添加分页

单页程序不会爬取整个书店。要查看下一页目录,请显式传入其 URL:

go run . https://books.toscrape.com/catalogue/page-2.html

在本教程测试中,两个目录页面均返回了 20 条记录。这是在练习站点上观察到的结果,并不保证未来页面布局或其他网站也会如此。

若要实现自动分页,应将页面发现与记录提取作为两个独立步骤处理。从同一下载文档中解析下一页链接,将其与响应 URL 进行关联解析,并决定该链接是否应包含在下一批请求中。应避免仅因提取和导航是独立功能而导致同一页面被重复抓取。

一个有界的分页循环应执行以下操作:

  1. 从已验证的目录 URL 和页面限制开始。
  2. 获取并验证当前页面。
  3. 提取记录并检查“下一页”链接。
  4. 解析该链接,并验证其方案、主机和路径是否符合预期。
  5. 若无下一页链接、该地址已被访问过,或达到页数限制,则停止。
  6. 根据源站点的运行限制等待一段时间,然后请求下一页。

如果爬取必须限制在同一源内,则需检查重定向目标以及发现的链接。仅对初始地址进行同源检查,并不能限制 HTTP 重定向将客户端发送到何处。

将已访问页面的 URL 与记录标识符分开追踪。重复的目录页面和重复的书籍属于不同的重复问题。应保持这两项检查的清晰可辨,而非删除所有查询参数并假设这些地址是等效的。

我们的 GoSpider 爬取指南涵盖了专门的发现工作流。当使用 Go 进行网页抓取时,若范围超出已知地址,这种分离有助于您判断缺失的记录是源于发现不完整还是提取错误。

需要爬取调度时请使用 Colly

当您需要自行维护大量请求回调、导航规则和按域限额时,Colly 便能发挥作用。其收集器负责协调数据检索及处理程序,例如 OnHTML, OnRequest,以及 OnError.

对于 v2 模块,请使用带版本号的模块路径:

go get github.com/gocolly/colly/v2@v2.3.0

Import github.com/gocolly/colly/v2 。 /v2 后缀至关重要;旧示例中若导入未带版本号的路径,将无法选定此模块版本。若您稍后向演示项目中添加 Colly,请保持解析器的记录规则保持一致,而非同时更改输出模式。

配置 AllowedDomains 以限制目标,并为相关域使用 LimitRule 配置相关域。检查 Limit。设置请求超时并注册 OnError ,以免请求失败被回调函数掩盖。

若启用 Async,请调用 Wait ,然后才将该任务视为已完成。保护共享切片和输出写入器,或者通过通道将记录传递给一个写入器。向共享切片追加数据的并发回调仍属于并发代码,需要采用同步策略。

Colly 的包参考文档中详细记录了这些控制措施。请注意, MaxDepth 边界限制的是链接深度;它并非整页的预算。一个浅层页面可以链接到许多目标。

对于使用 Go 进行网页抓取,框架可以减少调度代码,但它不会选择正确的筛选器、验证业务字段,也不会决定数据集必须达到何种完整性。请明确界定这些职责。

审慎处理 JavaScript 和请求失败的情况

在更改数据提取栈之前,请检查收到的响应。字段缺失可能表明选择器发生了变化、响应页面不同,或者内容尚未被 JavaScript 渲染。

症状

首先检查

HTTP 200 状态码但无产品卡片

检查返回的正文并确认是否为预期页面

响应 HTML 中缺少可见的浏览器数据

检查这些数据是否由 JavaScript 或用户交互提供

HTTP 429

降低请求频率并遵守 Retry-After (若存在)

HTTP 403

检查响应和访问条件

有效卡片中存在缺失值

请重新检查字段选择器和必填字段规则

无头浏览器可以执行 JavaScript 并进行交互。在 Go 语言中,chromedp 通过 Chrome DevTools 协议控制浏览器。其默认行为是启动无头版 Chrome;但浏览器执行仍需要适当的浏览器环境。

请勿默认将每个 HTTP 请求都替换为浏览器请求。应首先确定哪些内容需要渲染,然后等待相关元素或页面状态的出现,而不是仅依赖任意的睡眠时间。

同样,不要将每个失败的请求都视为可重试的。设置重试配额,区分临时故障与持续拒绝,并遵守源站的爬取规则。用户代理字符串仅用于标识本教程中的客户端,并不保证能够访问。

使用 Go 进行可靠的网页抓取,首先要诊断是哪一阶段出了问题。更改选择器无法解决传输超时问题,增加并发数也无法修复缺少请求数据的页面。

在增加并发度之前先测试记录

fetch 和 parse 函数具有独立的输入参数,因此您可以在不依赖于不断变化的网站的情况下对其进行测试。向 parseBooks 一个小型 HTML 测试数据集和一个基础 URL。将完整的 title 属性、原始价格字符串以及解析后的产品地址与明确的预期值进行核对。

然后对测试数据进行变体处理:移除价格、重命名商品卡片类、省略标题属性,以及提供无效链接。每种变体都应产生管道预期的失败结果。还应包含一个返回成功 HTTP 状态码但不包含任何商品卡片的页面。

对于网络行为,请使用 Go 语言的 httptest 包来提供受控响应。返回 404 和 429 状态码,延迟响应直至客户端超时,并发送超过配置大小限制的响应正文。这些情况能揭示单次成功的实时请求无法发现的故障。

随附的示例已通过本地测试数据、 go vet以及竞态检测器进行了验证。测试套件涵盖了成功的 JSON 输出以及上述错误情况,语句覆盖率达 84.3%。通过对练习目录的两次直接请求,分别验证了实际环境中的选择器。这是功能验证,而非吞吐量基准测试。

在引入并行处理之前,请确保输出路径对多个工作者安全。复用已配置的 HTTP 客户端,限制工作者数量,并确保记录写入由单一所有者负责。在记录错误时应保留足够的页面上下文以便排查,同时避免将凭据写入日志。

对于使用 Go 语言进行的网页抓取,应逐一增加限制,并检查有效记录数和请求数。只有当完成的请求能生成应用程序所需的记录时,更多的完成请求才有价值。

关键要点

  • 将检索与提取分离。HTTP 客户端获取响应;解析器将 HTML 转换为记录。保持这些功能的独立性,可让您通过保存的测试数据重现选择器失败的情况,而无需再次发送实时请求。
  • 在定义输出模式时同步定义失败行为。需决定标题缺失、价格为空或出现意外页面时,是应拒绝单行数据还是整个结果集。示例中选择拒绝该页面,这样布局发生变化时能立即显现。
  • 在自动化导航之前先对其进行限制。允许的目标页面、已访问的地址、页数限制和请求节流分别解决不同的问题。当将单页命令扩展为爬取时,应将其视为明确的控制机制。
  • 在能够信任记录之后再添加并发处理。设置工作线程限制并指定单一输出所有者,有助于更轻松地理解后续版本。在监控网络请求的同时,也要监控被接受的记录和被拒绝的页面。

常见问题

golang.org/x/net/html是标准库的一部分吗?

不是。HTML 解析器位于独立的 golang.org/x/net 模块中。Go 的标准 html 包与该解析器的导入路径和职责各不相同。goquery 在其选择 API 底层使用外部解析器。在遵循教程时,请务必检查模块依赖关系,切勿假设 Go 项目维护的每个包都会随工具链一并提供。

goquery 能否解析存储在磁盘上的 HTML?

可以。打开文件并将它的读取器传递给 `goquery.NewDocumentFromReader`,同时检查两个错误。请在调用代码中关闭文件;解析器不会负责关闭文件。当需要绝对链接时,请单独保留原始页面的 URL,因为本地文件名无法提供网站 URL 的解析上下文。

如何处理非 UTF-8 页面?

在解析之前先转换输入内容。golang.org/x/net/html/charset 包提供了 NewReader,该方法会返回一个读取器,它会根据编码检测结果和声明的内容类型将 HTML 转换为 UTF-8。请在请求层处理转换配置错误,并遵守响应大小限制。包含带重音字符的测试数据有助于发现仅使用 ASCII 测试时可能遗漏的编码问题。

是否应将价格导出为 JSON 数字?

根据消费者的需求选择表示形式。如果需要进行计算,请显式定义货币单位和小数位数;使用次级单位的整数或十进制表示形式可能比二进制浮点数更合适。当可追溯性重要时,请将原始显示值作为单独字段保留。 不要盲目删除标点符号:分组符和小数点分隔符取决于源数据的格式规范。

结论

一个有用的 Go 语言网络爬虫初始实现应具备明确可观察的契约:请求已知页面、验证响应、提取定义好的记录结构,并报告失败情况。书店示例通过可运行的程序和已针对实践目录验证过的选择器,为您提供了这一起点。

您的下一步应根据实际遇到的问题来推进。当记录跨越已知的目录页面时,添加分页功能;当请求调度和回调变得繁重时,引入 Colly;当所需内容依赖于 JavaScript 或交互时,使用浏览器渲染。在每种情况下,都要保持输出模式和验证规则足够稳定,以便在更改前后比较结果。

如果维护页面检索成为一项独立的运维负担,请评估 WebScrapingAPI 提供的 Scraper API 来处理工作流的这一部分。您的 Go 应用程序可以继续负责解析、记录验证和存储。将返回的内容与您在直接请求中使用的相同测试数据和字段预期进行比较。

首先运行示例,检查其 JSON 内容,并有意修改一个选择器以观察失败情况。理解该失败路径是自信地扩展爬虫的实用基础。

关于作者

Sorin-Gabriel Marica, 全栈开发工程师 @ WebScrapingAPI

Sorin-Gabriel Marica

全栈开发工程师

索林·马里卡(Sorin Marica)是 WebScrapingAPI 的全栈及 DevOps 工程师,负责开发产品功能并维护确保平台平稳运行的基础设施。

开始构建

准备好扩展您的数据收集规模了吗?

加入2,000多家企业,使用WebScrapingAPI在无需任何基础设施开销的情况下,以企业级规模提取网络数据。