跳至内容
免费开始

Blog · 文章

网络爬虫技术

深入探讨爬取、解析、反机器人系统背后的科学原理,以及大规模网络数据提取所面临的工程挑战。

已发表的文章

34

文章

网络爬虫技术

34 文章

Nodriver Python 教程:隐身浏览器爬取——从第一个脚本到投入生产
网络爬虫技术

Nodriver Python 教程:隐身浏览器爬取——从第一个脚本到投入生产

TL;DR: 简而言之:Nodriver 是一个异步 Python 库,通过 Chrome DevTools Protocol 驱动 Chromium,无需 Selenium 或 chromedriver 二进制文件。当一个更接近真实 Chrome 会话的自托管隐身浏览器比 WebDriver 技术栈更合适时,请使用它;但要知道,它本身并不能消除 IP、TLS 或行为层面的风险。本教程从第一个脚本讲到容器化生产部署以及托管的 Browser API。

Suciu Dan5 min read
阅读文章
如何在搜索结果页面(SERP)抓取工具中处理 Google /goto 重定向 URL 和 CAES 令牌
网络爬虫技术

如何在搜索结果页面(SERP)抓取工具中处理 Google /goto 重定向 URL 和 CAES 令牌

TL;DR: Google 搜索会在搜索结果页面(SERP)中的结果与目标页面之间插入一个不透明的重定向。href 属性中可能不会直接显示 URL,而是显示包含 CAES 令牌的 google.com/goto——或者较旧的 /url 包装形式。了解如何在生产环境的 SERP 抓取工具中,无需解密 CAES 即可对这些重定向进行分类、去重和解析。

Suciu Dan4 min read
阅读文章
cURL 中的 HTTP 响应头:每个标记、技巧和脚本配方
网络爬虫技术

cURL 中的 HTTP 响应头:每个标记、技巧和脚本配方

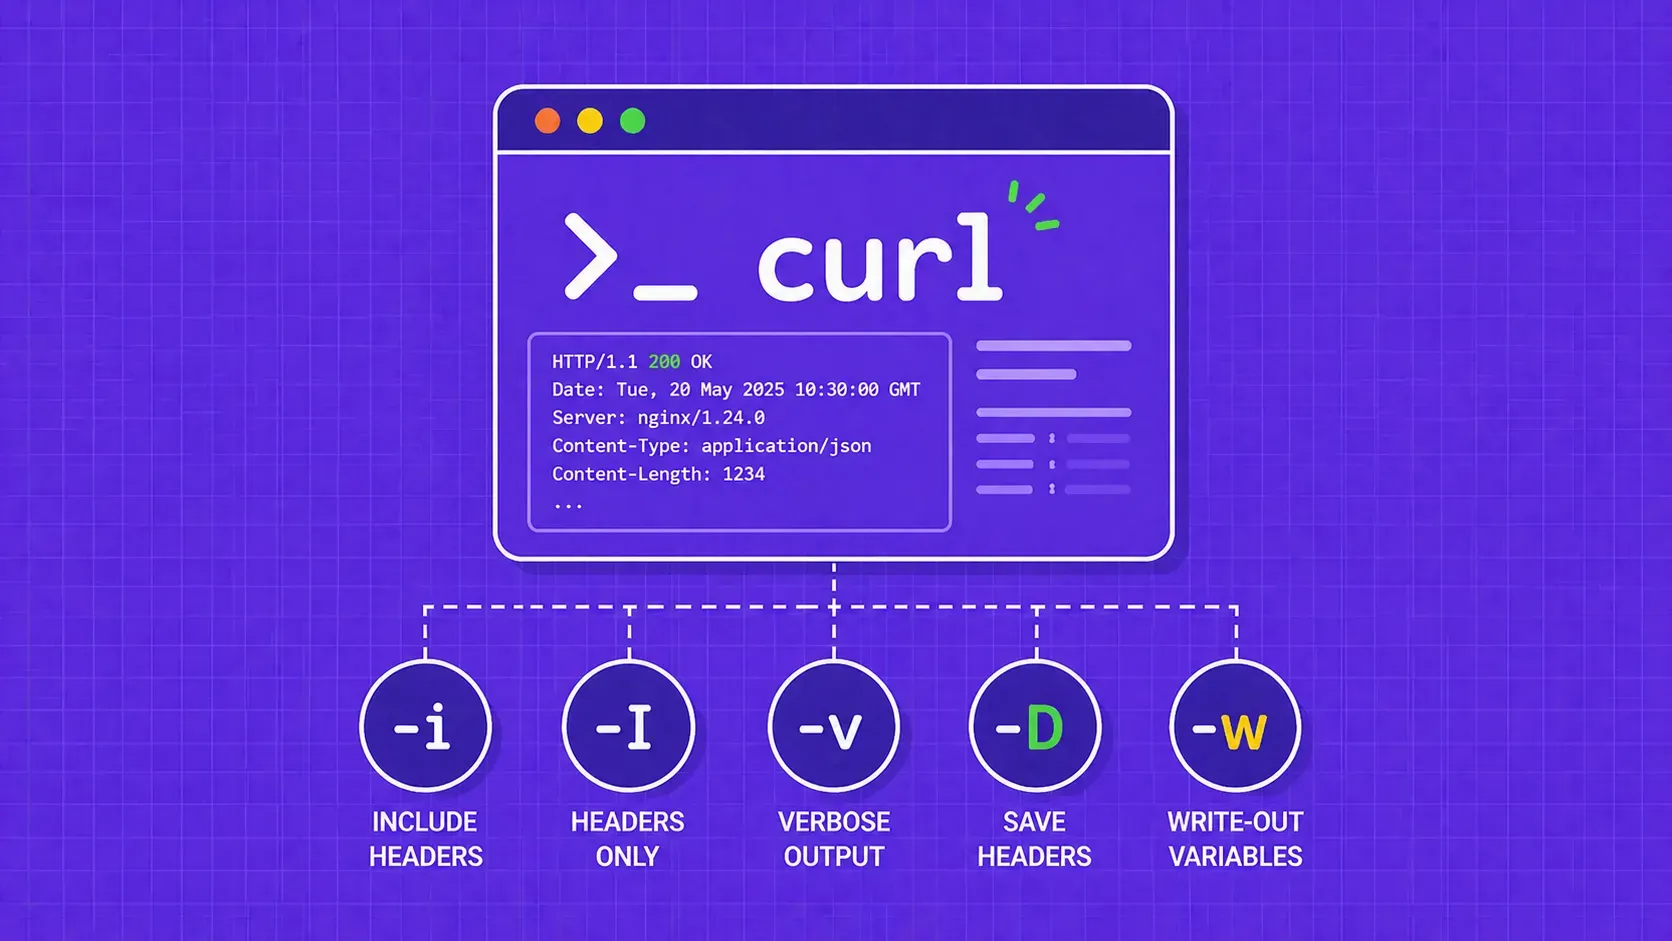
TL;DR: 简要说明:cURL 默认隐藏响应头信息。使用 -i 可以看到响应头和正文,使用 -I 可以看到 HEAD 请求只返回响应头,使用 -v 可以看到完整的请求/响应调试,使用 -D 可以将响应头保存到文件中。对于现代脚本,cURL 7.83+ 允许提取单个头信息,或使用 -w write-out 选项将所有头信息转存为 JSON 格式。

Suciu Dan3 min read
阅读文章
什么是无头浏览器?架构、用例和顶级工具
网络爬虫技术

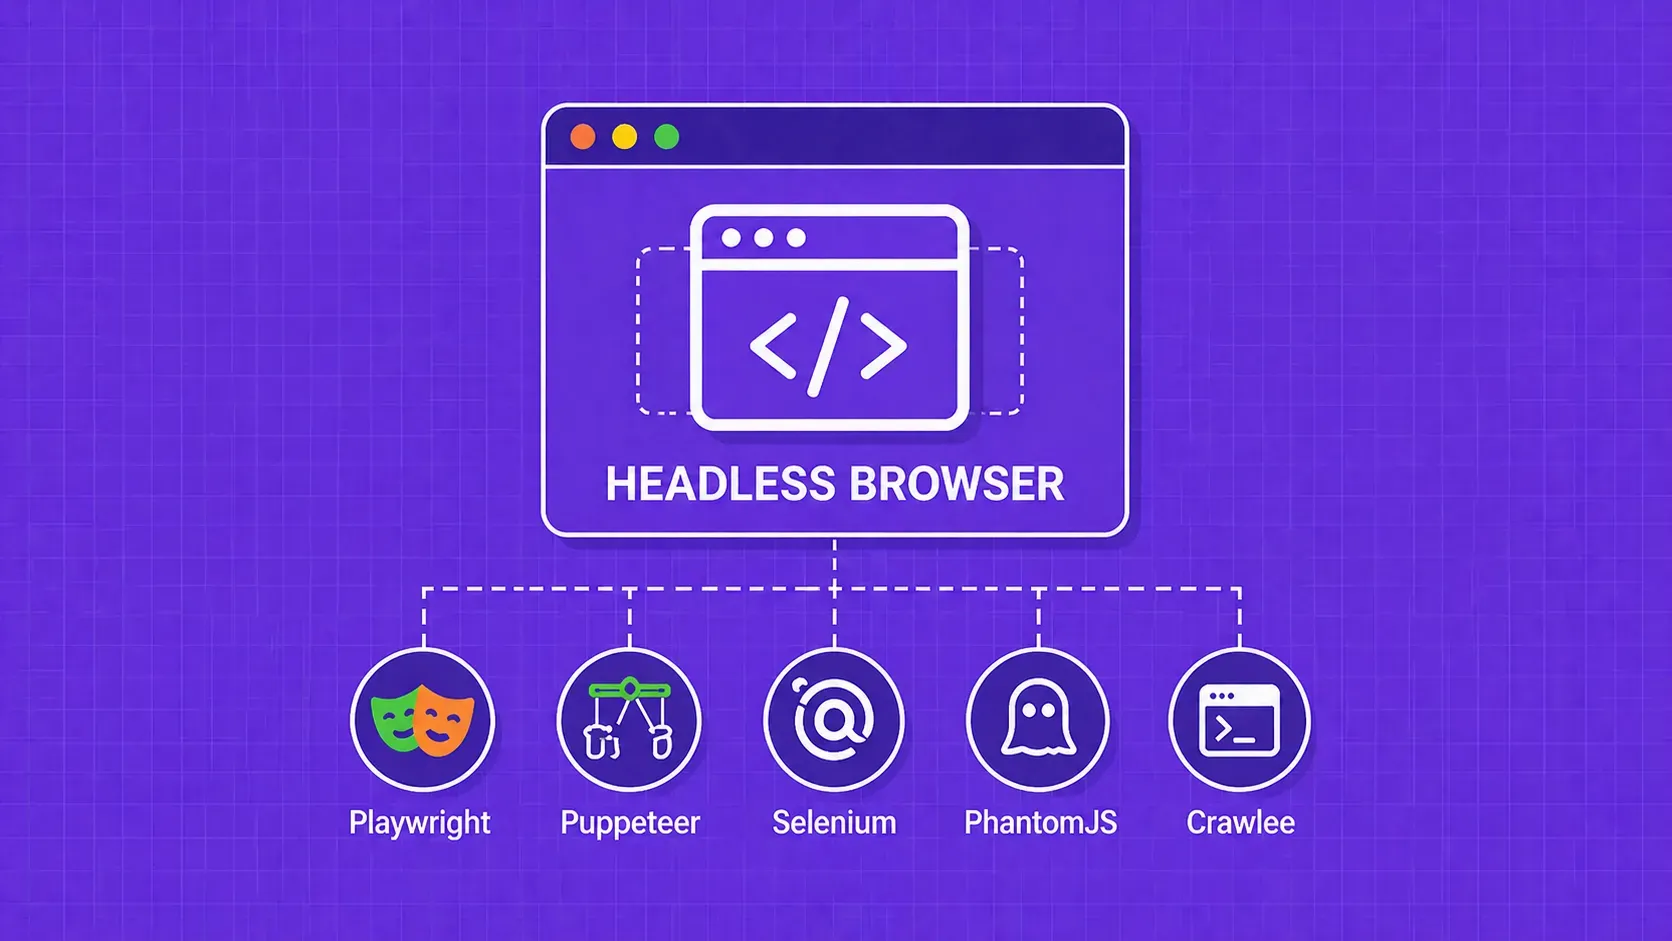
什么是无头浏览器?架构、用例和顶级工具

TL;DR: 简要说明:无头浏览器是一种网络浏览器,运行时没有可见的图形界面,完全由代码或命令行指令控制。开发人员将无头浏览器用于自动测试、网络扫描、性能监控,并越来越多地用于支持人工智能代理。本指南将介绍无头浏览器的内部工作原理、何时选择无头浏览器而非普通浏览器,以及哪些框架值得你花时间研究。

Suciu Dan2 min read
阅读文章
Scrapy 与 Selenium:谁是赢家?
网络爬虫技术

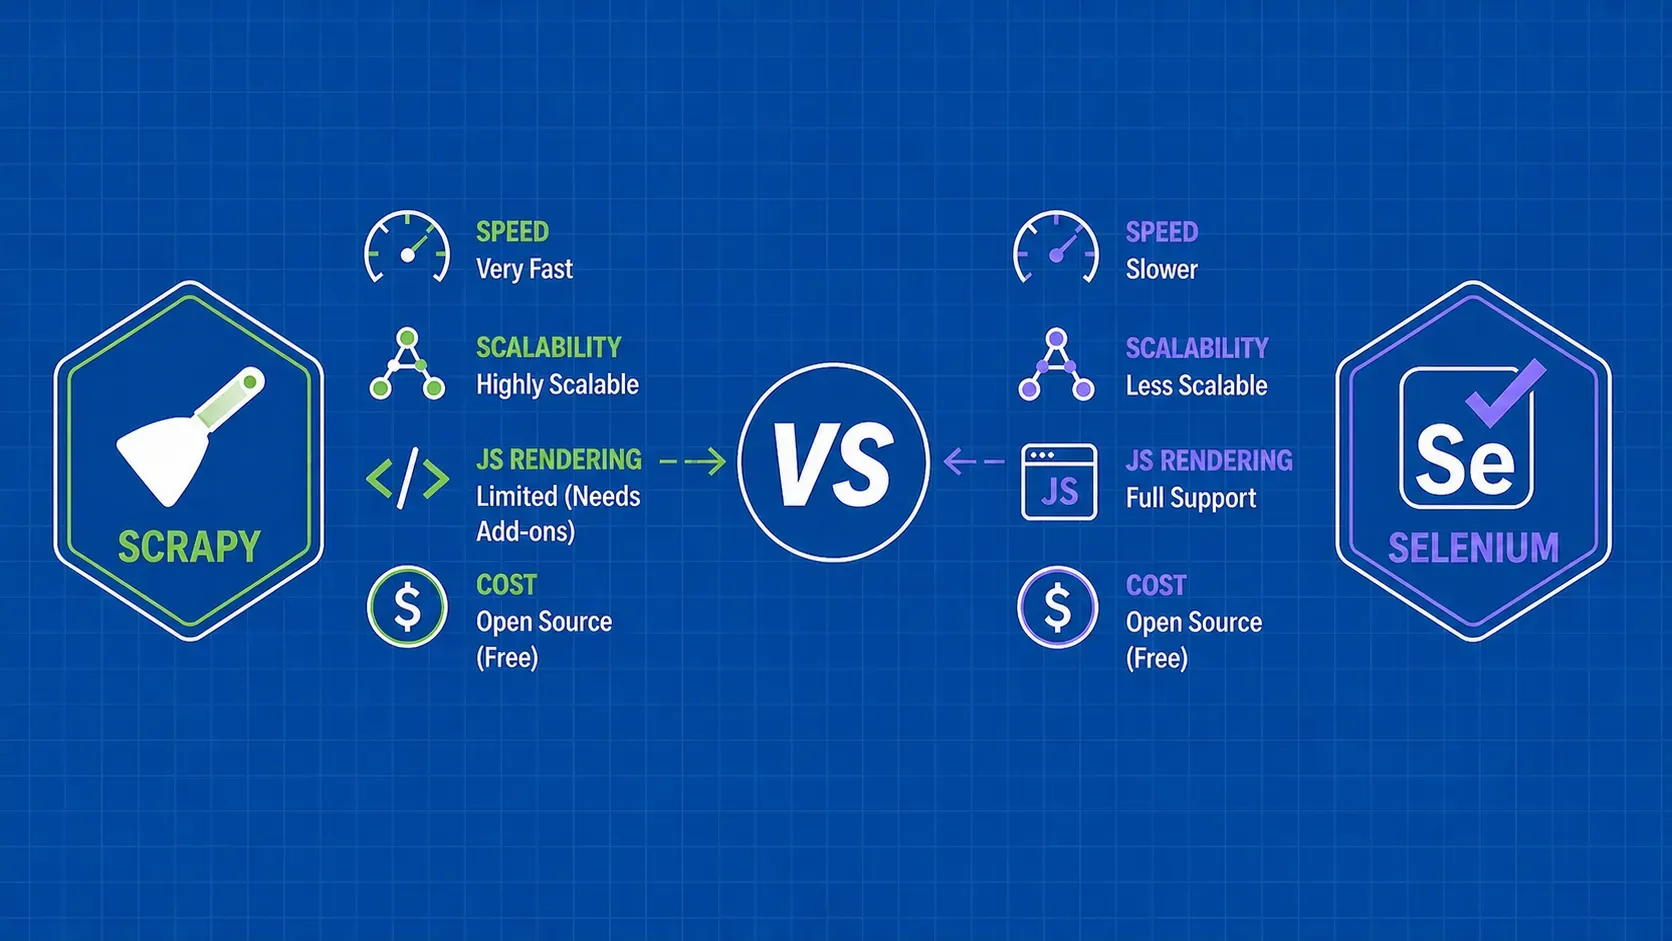
Scrapy 与 Selenium:谁是赢家?

TL;DR: 简要说明:Scrapy 是一个高速异步抓取框架,用于大规模从静态页面中提取结构化数据。Selenium 可自动运行真实浏览器并处理 JavaScript 繁重的网站,但资源成本要高得多。大多数生产型抓取项目都会受益于了解何时使用每种方法,或何时将它们结合起来使用。

Gabriel Cioci2 min read
阅读文章
数据解析详解:工具、技术和代码 (2026)
网络爬虫技术

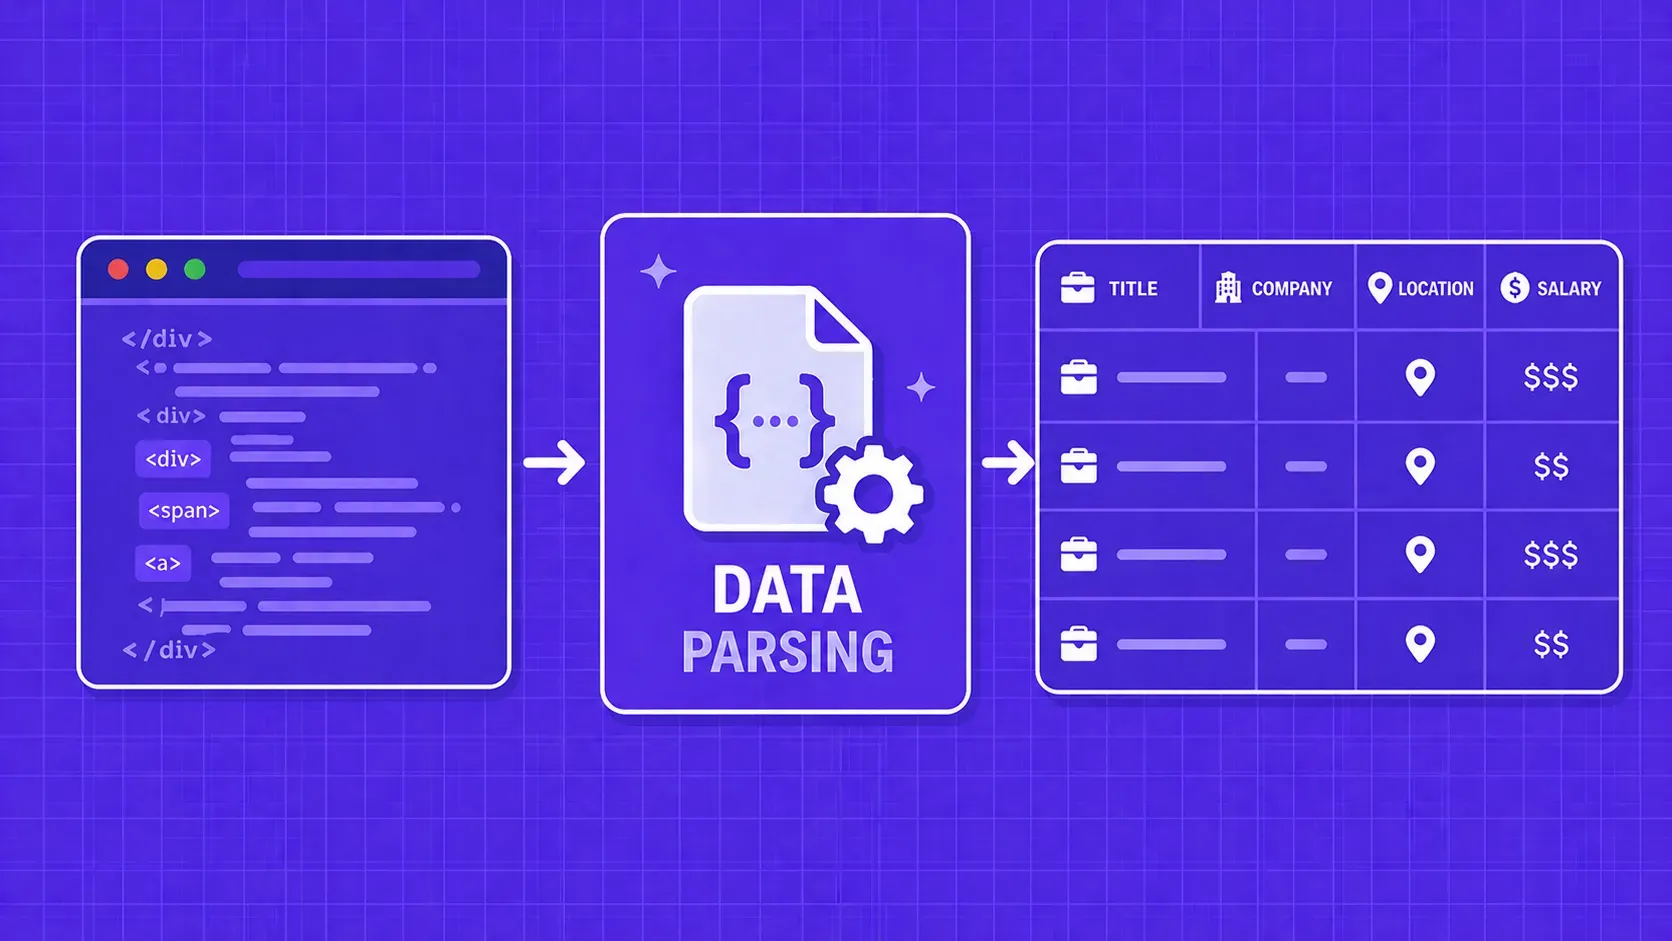
数据解析详解:工具、技术和代码 (2026)

TL;DR: 简要说明:数据解析将原始内容(HTML、JSON、XML、PDF)转换为代码可以实际使用的结构化字段。本指南将逐步介绍数据解析的工作原理,比较主要的技术和库,并为您提供一个实用的框架,帮助您决定是构建还是购买解析层。

Suciu Dan2 min read
阅读文章
什么是浏览器自动化?实用指南
网络爬虫技术

什么是浏览器自动化?实用指南

TL;DR: 简要说明:浏览器自动化是指通过代码驱动真实或无头 Web 浏览器,使其代表您点击、键入、导航和读取页面。本指南将解释什么是浏览器自动化,比较 Selenium、Playwright、Puppeteer 和 Cypress,并说明何时不需要使用完整浏览器。

Ștefan Răcilă2 min read
阅读文章
网络抓取与数据挖掘:区别、管道以及何时使用两者
网络爬虫技术

网络抓取与数据挖掘:区别、管道以及何时使用两者

TL;DR: 简要说明:网络搜刮从公共网页中收集原始数据。数据挖掘分析结构化数据,以显示模式、预测和细分。它们是同一生命周期中的不同阶段,大多数生产系统都将它们结合在一个 "先搜刮,后规范化,再挖掘 "的流程中。

Ștefan Răcilă2 min read
阅读文章
面向开发人员的最佳网络抓取课程
网络爬虫技术

面向开发人员的最佳网络抓取课程

TL;DR: 简要说明:最好的网络刮擦课程取决于你的语言、水平和目标用例。本指南比较了 Udemy、Coursera、DataCamp 和 Packt 的五种付费课程,指出了官方文档等免费补充内容,并介绍了如何从完成课程过渡到运行生产型刮擦程序。

Ștefan Răcilă2 min read
阅读文章
每个数据团队在编写抓取程序之前都应回答的 10 个抓取问题
网络爬虫技术

每个数据团队在编写抓取程序之前都应回答的 10 个抓取问题

TL;DR: 简要说明:网络搜索项目在代码失败之前,其规划早已失败。这十个刮擦问题将引导您了解合法性、API 替代方案、反僵尸防御、成本、刷新频率、数据质量和管理,以便您确定工作范围、选择正确的堆栈,并避免在生产中悄然扼杀刮擦程序的失败模式。

Mihai Maxim1 min read
阅读文章
2026 年 15 款最佳反检测浏览器:面向营销人员、搜索人员和多账户管理人员的诚实比较
网络爬虫技术

2026 年 15 款最佳反检测浏览器:面向营销人员、搜索人员和多账户管理人员的诚实比较

TL;DR: 简要说明:反侦测浏览器可让您运行多个独立的浏览器配置文件,每个配置文件都有唯一的指纹,因此平台无法链接您的账户。本指南从指纹质量、自动化支持、价格和代理集成等方面对 2026 年 15 款最佳反侦测浏览器进行了排名。我们还介绍了这些工具的实际工作原理,什么时候使用搜索 API 更明智,以及在每种使用情况下应搭配哪种代理类型。

Mihnea-Octavian Manolache4 min read
阅读文章
什么是 ISP 代理?网络抓取和自动化指南
网络爬虫技术

什么是 ISP 代理?网络抓取和自动化指南

TL;DR: 简要说明:什么是 ISP 代理?它们是托管在数据中心的静态住宅 IP。检测系统看到的是住宅 ASN,而你得到的是数据中心吞吐量。当会话、账户绑定和可预测的每个 IP 定价比原始地理覆盖范围更重要时,它们就是最佳选择。

Mihnea-Octavian Manolache1 min read
阅读文章
HTTP 标头网络抓取:停止受阻
网络爬虫技术

HTTP 标头网络抓取:停止受阻

TL;DR: 简而言之:HTTP 头信息通常是你的刮擦程序收到 403 而你的浏览器却能正常加载相同 URL 的原因。本指南介绍了反僵尸系统实际上会检查哪些标头,如何从 DevTools 中捕获真实浏览器的标头集,如何在 Python 和 Node.js 中正确发送和旋转标头,以及何时手动调整将不再奏效,而使用受管刮擦 API 才是更好的选择。

Raluca Penciuc3 min read
阅读文章
2026 年用于网络搜索的最佳旋转式住宅代理服务器
网络爬虫技术

2026 年用于网络搜索的最佳旋转式住宅代理服务器

TL;DR: 简而言之:2026 年最好的轮播住宅代理并不是拥有最大广告牌池规模的代理。它们在会话控制、地理定位、道德采购和按 GB 计算的经济性等方面都能真正匹配您搜索的目标。本指南为您提供了一个供应商中立的评估框架、11 家供应商的对比表和使用案例图,这样您就可以在使用信用卡之前筛选出两三家供应商。

Anda Miuțescu4 min read
阅读文章
使用 Node-Unblocker 进行网络抓取:实用指南
网络爬虫技术

使用 Node-Unblocker 进行网络抓取:实用指南

TL;DR: 简要说明:Node-unblocker 将 Express 应用程序变成了一个 URL 前缀 HTTP 代理,你可以在上面进行黑客攻击。这篇网络搜刮节点解锁指南介绍了如何安装、连接请求和响应中间件、轮换实例、在 Docker 或 Heroku 上部署,以及如何识别托管搜刮 API 才是更明智的选择。

Sorin-Gabriel Marica3 min read
阅读文章
什么是旋转代理?网络搜索 IP 轮换指南
网络爬虫技术

什么是旋转代理?网络搜索 IP 轮换指南

TL;DR: TL;DR:那么什么是旋转代理呢?代理服务器会为来自管理池的每个请求分配不同的 IP,这就是搜刮者如何绕过每个 IP 的速率限制、验证码和地理过滤器的原因。本指南介绍了旋转的工作原理、四种池类型、三种语言的设置代码以及如何选择提供商。

Raluca Penciuc2 min read
阅读文章
CSS 选择器速查表——网页抓取技巧与窍门
网络爬虫技术

CSS 选择器速查表——网页抓取技巧与窍门

TL;DR: 想要像专业人士一样进行网页抓取时,请使用这份 CSS 选择器速查表

Ștefan Răcilă1 min read
阅读文章
如何构建 Python 网络爬虫:从开始到扩展
网络爬虫技术

如何构建 Python 网络爬虫:从开始到扩展

TL;DR: 简要说明:python 网络爬虫可以自动完成在网站上跟踪链接以发现和收集内容的繁琐工作。本指南将指导您使用请求和 BeautifulSoup 从头开始构建爬虫,然后再使用 Scrapy 进行并发爬行、项目管道和结构化数据导出。您还将学习如何负责任地抓取、旋转代理以避免阻塞,以及如何处理 JavaScript 渲染的页面。

Suciu Dan5 min read
阅读文章
2026年优质代理列表:9家付费代理服务排名
网络爬虫技术

2026年优质代理列表:9家付费代理服务排名

TL;DR: 简而言之:对大多数抓取团队来说,Oxylabs 和 Decodo 是最强的全能型高级代理服务,Bright Data 适合企业级预算,Webshare 则是从静态列表起步最便宜的选择。如果希望 IP 在租用期内归您专用,请选择静态列表;如果每个请求或会话都应通过不同的 IP 发出,请选择轮换网关。

Gabriel Cioci6 min read
阅读文章
API 风格:对比五种实用的集成模型
网络爬虫技术

API 风格:对比五种实用的集成模型

TL;DR: 区分五种常见的 API 实现方式,同时避免将架构、协议和交付模式混为一谈。通过一个实际的目录场景,比较它们的契约。

Robert Munceanu2 min read
阅读文章
网络爬虫最佳免费代理列表排名(2026)
网络爬虫技术

网络爬虫最佳免费代理列表排名(2026)

TL;DR: 简而言之:最适合网页抓取的免费代理列表是:用于脚本的 ProxyScrape 列表、注重在线率和 ASN 筛选的 Geonode 列表,以及 GitHub 上适合纯文本管道输入的 monosans/proxy-list。请把每个列表都视为候选池,因为在任何一天只有一小部分列出的代理可用;切勿通过免费代理发送登录信息或访问支付页面。

Robert Munceanu5 min read
阅读文章
2026年最佳共享和专用数据中心代理
网络爬虫技术

2026年最佳共享和专用数据中心代理

TL;DR: 共享型、半专用型和专用型数据中心代理的定价和计费方式差异巨大,以至于标价最低的那种往往实际花费最高。 本指南对比了11家服务商的当前标价,针对不同任务各推荐一家,详细解释了按IP计费与按GB计费的区别以及合理使用政策,并附有Python脚本,可用于估算成本并验证您的IP是否真正属于专用IP。

Anda Miuțescu6 min read
阅读文章
网页抓取与网页爬取:入门指南
网络爬虫技术

网页抓取与网页爬取:入门指南

TL;DR: 了解爬虫如何查找网页,以及数据抓取工具如何提取有用数据。以一家书店为例,比较它们的输出结果,并为您的首个项目选择合适的工作流程。

Anda Miuțescu1 min read
阅读文章
2026 年最佳网页抓取移动代理:9 家服务商排名
网络爬虫技术

2026 年最佳网页抓取移动代理:9 家服务商排名

TL;DR: 按每 GB 或每端口价格、运营商与 ASN 定向、5G、粘性会话和试用条款,对比 9 家用于网页抓取的移动代理服务商(截至 2026 年 10 月)。

Sergiu Inizian6 min read
阅读文章
网络爬虫最佳实践:包含技巧和可运行代码的生命周期指南
网络爬虫技术

网络爬虫最佳实践:包含技巧和可运行代码的生命周期指南

TL;DR: 简而言之:网页抓取最佳实践,是让爬虫保持合法、礼貌、准确且运行成本低的一系列习惯。请编写数据契约,优先使用 API 或 JSON 而非 HTML,按照 RFC 9309 的定义遵守 robots.txt,控制对每个主机的请求节奏,遵守 Retry-After,并在保存前验证每条记录。本指南将这些实践应用于爬虫生命周期的每个阶段,并附有可运行的 Python 代码片段。

Anda Miuțescu6 min read
阅读文章
不被封杀的网络抓取:2026 Playbook
网络爬虫技术

不被封杀的网络抓取:2026 Playbook

TL;DR: 简而言之:现代阻塞发生在四个层面:网络、请求签名、浏览器和行为。首先使用状态代码和挑战页面对该层进行诊断,然后通过旋转式住宅代理、浏览器级标头、TLS 冒充、隐身浏览器和类人计时的正确组合进行修复。当流量或反僵尸技术的复杂性导致 DIY 不经济时,可将请求层卸载到托管 API。

Sergiu Inizian6 min read
阅读文章
网络爬虫中的IP地址段:重试前先进行诊断
网络爬虫技术

网络爬虫中的IP地址段:重试前先进行诊断

TL;DR: 在将问题归咎于IP封禁之前,应先查明导致抓取失败的根本原因。诊断速率限制、会话问题和访问拒绝情况,然后验证是否已恢复正常。

Anda Miuțescu1 min read
阅读文章
网络爬虫 API 的优势:您实际上可以将哪些工作外包出去
网络爬虫技术

网络爬虫 API 的优势:您实际上可以将哪些工作外包出去

TL;DR: 了解数据抓取 API 可以承担哪些职责,哪些职责仍需由您负责。评估渲染、结构化输出、恢复以及每条可用记录的成本。

Anda Miuțescu1 min read
阅读文章
2026 年最适合网络搜索的代理类型
网络爬虫技术

2026 年最适合网络搜索的代理类型

TL;DR: 简要说明:网络搜索代理位于你的搜索器和目标网站之间,掩盖你的 IP,让你在速率限制、地理墙和反僵尸防御系统中生存。正确的类型(数据中心、住宅、ISP 或移动)和正确的协议(HTTP/HTTPS 或 SOCKS5、IPv4 或 IPv6)取决于目标网站的防御、你的地理需求以及每个页面的重要性。本指南介绍了如何权衡利弊,最后提供了一份供应商中立的清单。

Raluca Penciuc2 min read
阅读文章
网络爬虫的代理管理:一种实用设计
网络爬虫技术

网络爬虫的代理管理:一种实用设计

TL;DR: 围绕工作需求、会话租约、分层健康检查以及全源限制来设计代理分配方案。应统计被接受的记录数量,而非地址轮换次数。

Raluca Penciuc1 min read
阅读文章
2026年最适合网络爬虫的代理:按任务类型和成本选择
网络爬虫技术

2026年最适合网络爬虫的代理:按任务类型和成本选择

TL;DR: 用于网络爬虫的最佳代理就是目标网站能够接受的、价格最低的那种。本指南将数据中心代理、ISP代理、住宅代理和移动代理与爬虫任务进行匹配,对比了九家服务商的公开定价,介绍了如何计算每次成功请求的成本,并提供了一个 Python 测试框架,供您在购买前使用自己的 URL 测试各家服务商。

Robert Munceanu5 min read
阅读文章
自定义爬虫与数据提取工具:自建还是购买?
网络爬虫技术

自定义爬虫与数据提取工具:自建还是购买?

TL;DR: 通过数据合同、所有权对比、总成本模型以及实际试点,决定是自行开发、购买还是组合使用数据抓取工具。

Sergiu Inizian1 min read
阅读文章
2026 年最佳网络抓取工具
网络爬虫技术

2026 年最佳网络抓取工具

TL;DR: 简而言之:2026 年最好的网络搜刮工具可分为三类:将代理、无头浏览器和验证码隐藏在 HTTP 调用背后的托管 API;Scrapy 和 Crawlee 等开源框架,如果你能托管它们,就能完全控制;以及面向非开发人员的无代码可视化搜刮工具。没有唯一的赢家。我们在定价模式、JavaScript 渲染、反僵尸强度和理想用例等方面比较了 22 种以上的选择,这样您就可以筛选出两到三种,与您的实际目标网站进行比较。

Gabriel Cioci8 min read
阅读文章
什么是网络抓取?开发人员实用指南
网络爬虫技术

什么是网络抓取?开发人员实用指南

TL;DR: 简要说明:网络搜刮是将公共网络数据自动提取为您可以实际使用的结构化格式,如 JSON 或电子表格。本指南从定义层面介绍了什么是网络刮削、网络刮削背后的请求-解析流水线、团队在哪里使用网络刮削、从无代码到可管理 API 的工具范围,以及如何在反僵尸防御和法律方面保持正确的立场。

Sergiu Inizian2 min read
阅读文章

开始构建

准备好扩展您的数据收集规模了吗?

加入2,000多家企业,使用WebScrapingAPI在无需任何基础设施开销的情况下,以企业级规模提取网络数据。