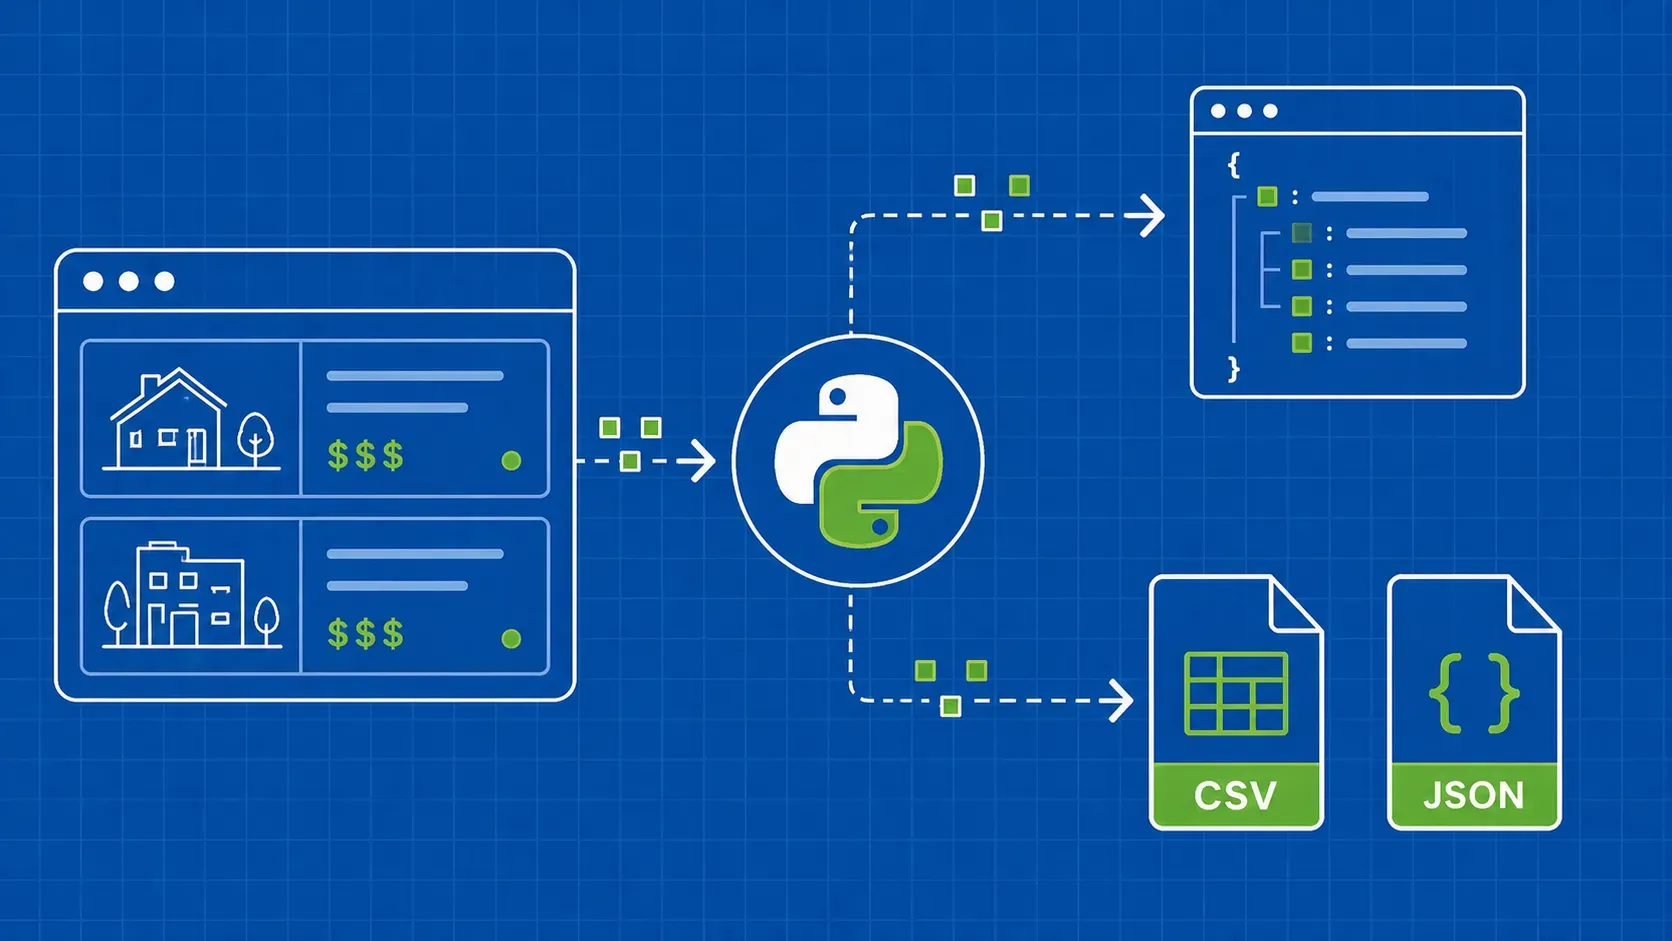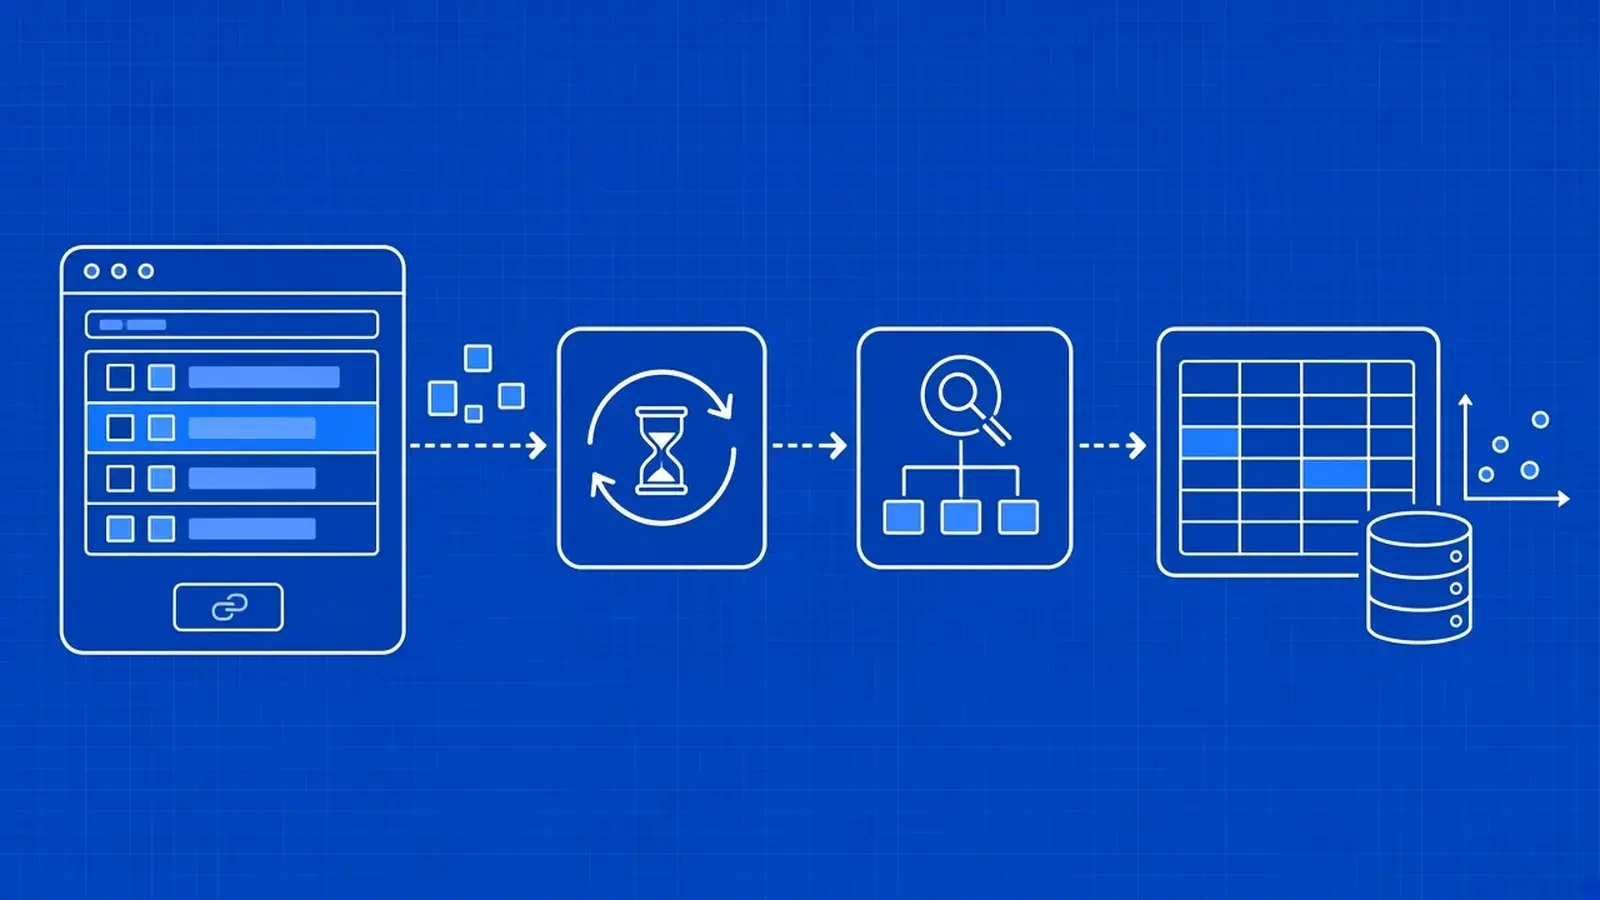
要点速览: 在 R 中做网页抓取,用 rvest 通过 CSS 选择器或 XPath 解析 HTML,用 httr2 获取页面,并处理重试和速率限制。只抓一个页面时,单用 rvest 就够了;一旦要批量爬取,就用 httr2 获取、用 rvest 解析;页面由 JavaScript 生成时,改用 read_html_live()。本指南涵盖表格、分页、script 标签中的数据、抓取 API 以及离线测试。
你需要的数据就在某个网页上,而你希望不离开 R 就把它放进一个 tibble。在 R 中做网页抓取,只需两个包,再加上你早已熟悉的 tidyverse。刚接触这个概念?可以先了解什么是网页抓取。
本指南以 Goodreads 作为贯穿全文的示例:读者评选榜单 "Best Books Ever",以及乔治·奥威尔《1984》的图书页面。你将用 rvest 解析一个页面和一张表格,用 httr2 有礼貌地爬取分页列表,提取由 JavaScript 生成的数据,在不改动解析器的前提下把被封锁的页面交给抓取 API,离线测试代码,并汇总结果。
快速上手
- 安装:
install.packages(c("rvest", "httr2")) - 用
read_html()加载,用html_elements()选择,用html_text2()或html_attr()提取 - 对由 JavaScript 生成的页面,使用
read_html_live() - 使用 R 4.1 或更高版本,以便使用原生管道符
|>