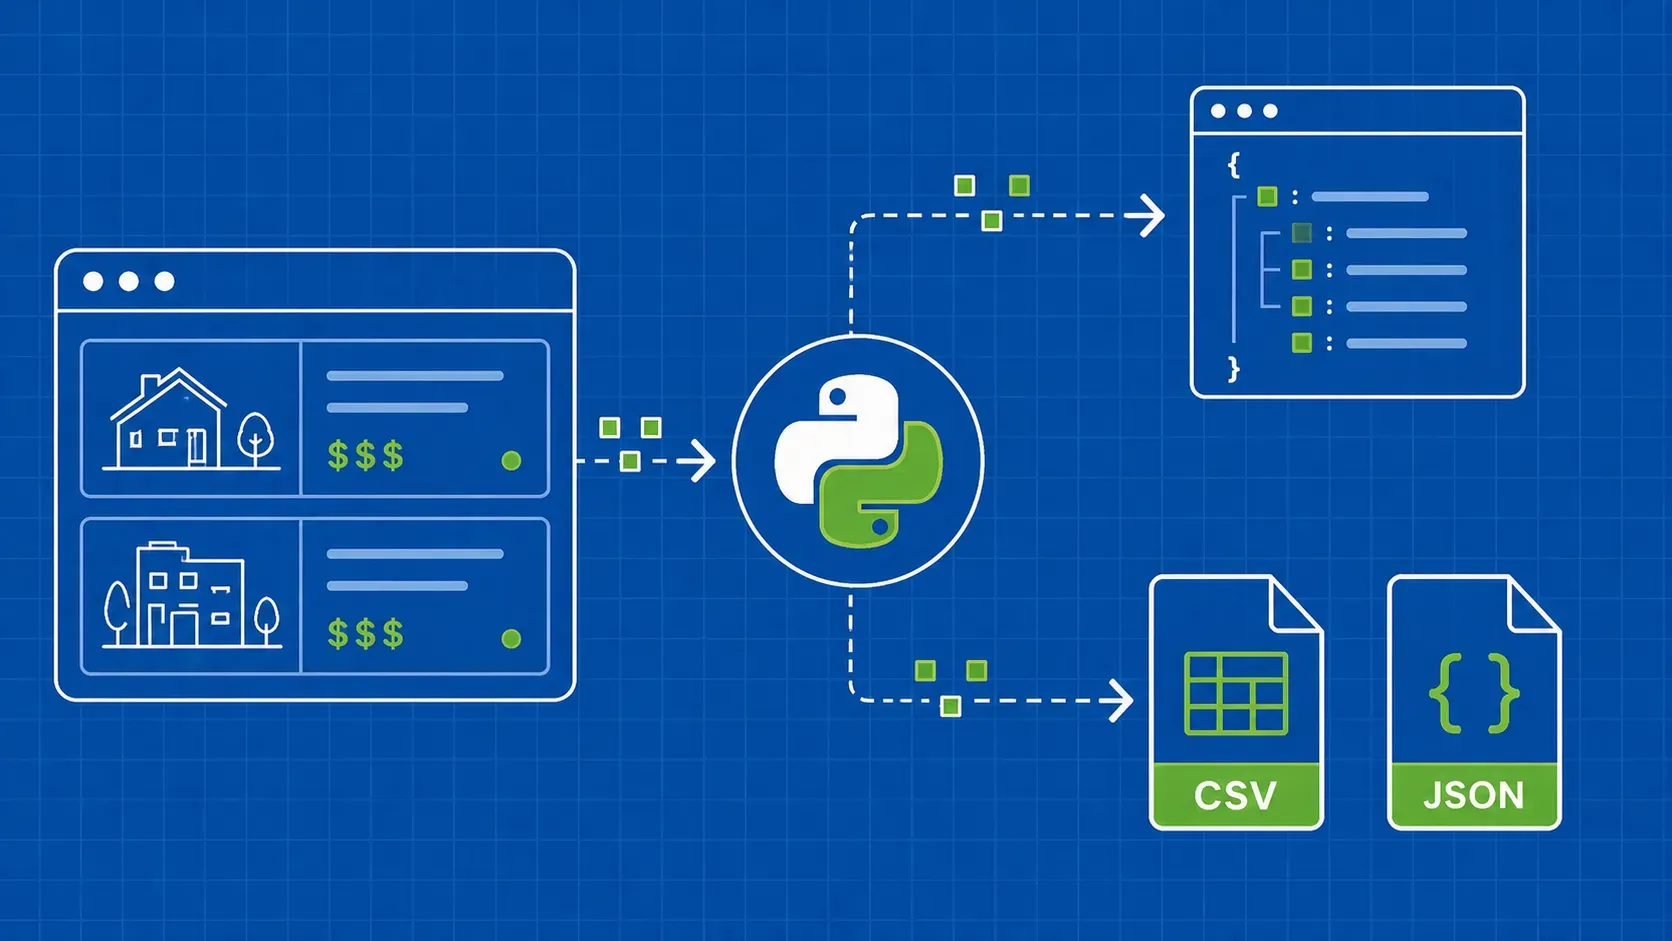
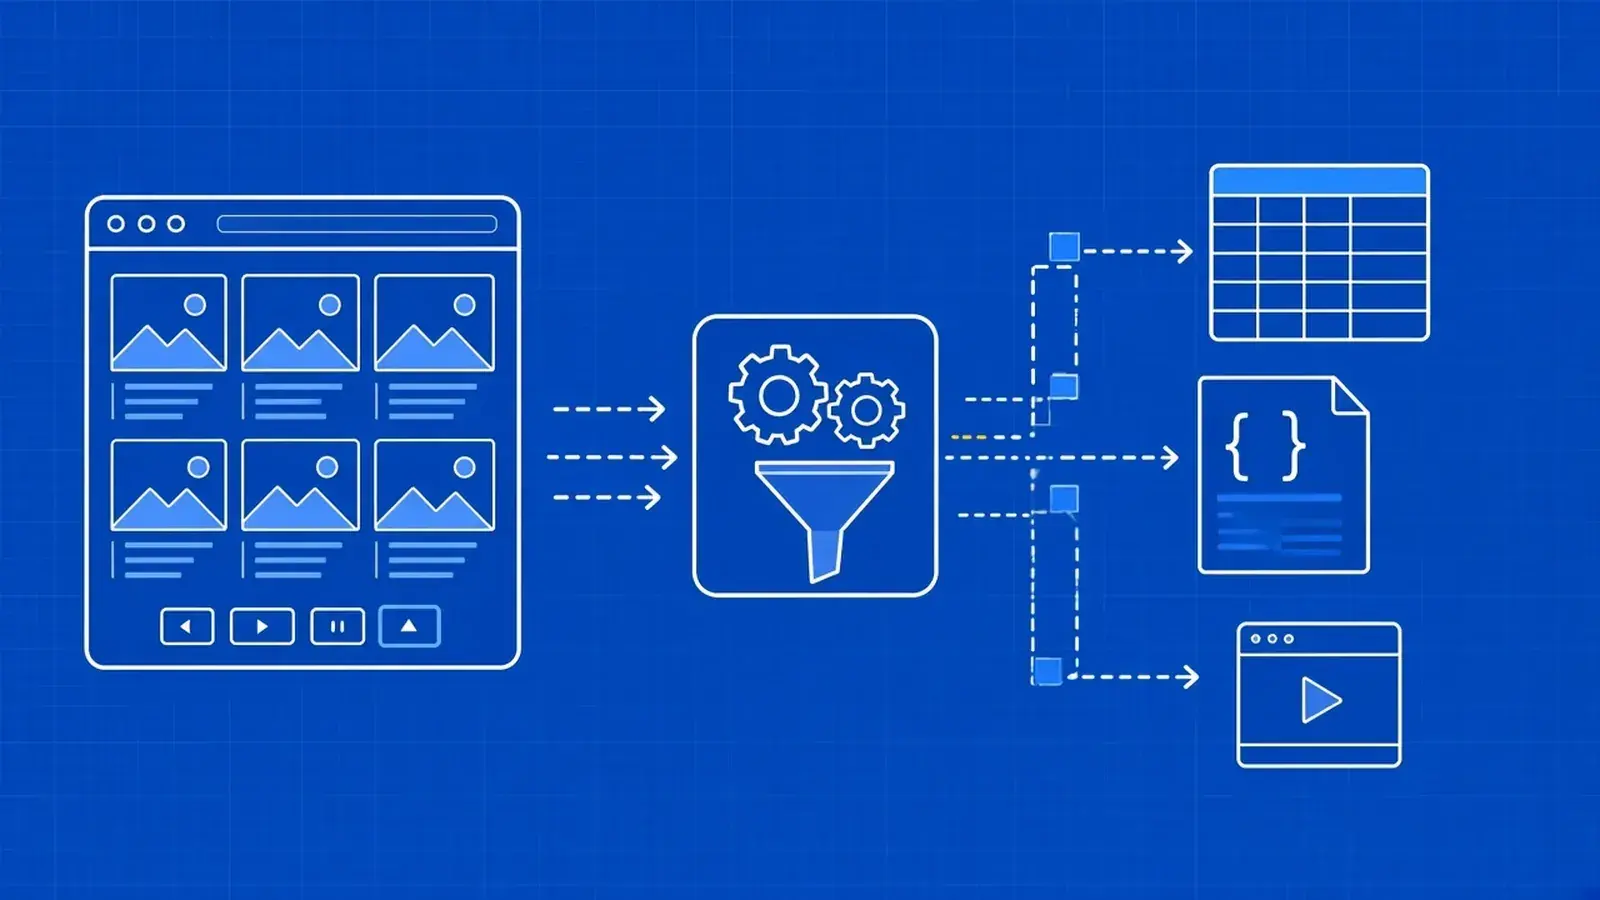
简而言之:Elixir 通过 Req 进行 HTTP 抓取,使用 Floki 解析 CSS 选择器,并 Task.async_stream 用于并发处理。本指南将构建一个爬虫,用于抓取包含 1,000 本书籍的练习目录并导出为 CSV 和 JSON 格式,同时说明在何种情况下使用 Crawly 框架更为划算,并处理那些通过 JavaScript 渲染内容的页面。Elixir 的网页抓取主要由三个部分组成:Req 用于获取页面,Floki 通过 CSS 选择器解析 HTML,以及 Task.async_stream 并能根据您设定的限制同时抓取多页。在本指南中,您将从头到尾构建一个爬虫。它将从公开的练习目录 books.toscrape.com 收集所有书籍,跟随分页逻辑,并行处理页面,礼貌地重试失败的请求,并将结果写入 CSV 和 JSON 文件。 随后,您将通过读取嵌入的 JSON、在无头 Chrome 中渲染页面,以及从相同的 Req 代码中调用爬取 API,来爬取一个由 JavaScript 渲染的页面(quotes.toscrape.com/js/)。
该代码针对下表中的包版本,包括 Floki 0.38 的变更——该变更悄然导致许多旧教程无法正常运行。