跳至内容
免费开始
返回博客

网页抓取与网页爬取:入门指南

Anda Miuțescu最后更新于 1 min read
网页抓取与网页爬取:入门指南

开始提取

免费试用 WebScrapingAPI

领取 1,000 个免费 API 积分。无需信用卡。

开始使用
简而言之:网页爬行用于发现并访问相关页面;网页抓取则从这些页面的内容中提取有用信息。如果你已经掌握了URL,可以直接从数据提取开始。如果你需要先查找页面再收集数据,则应将这两项任务结合起来,并分别检查输出结果。

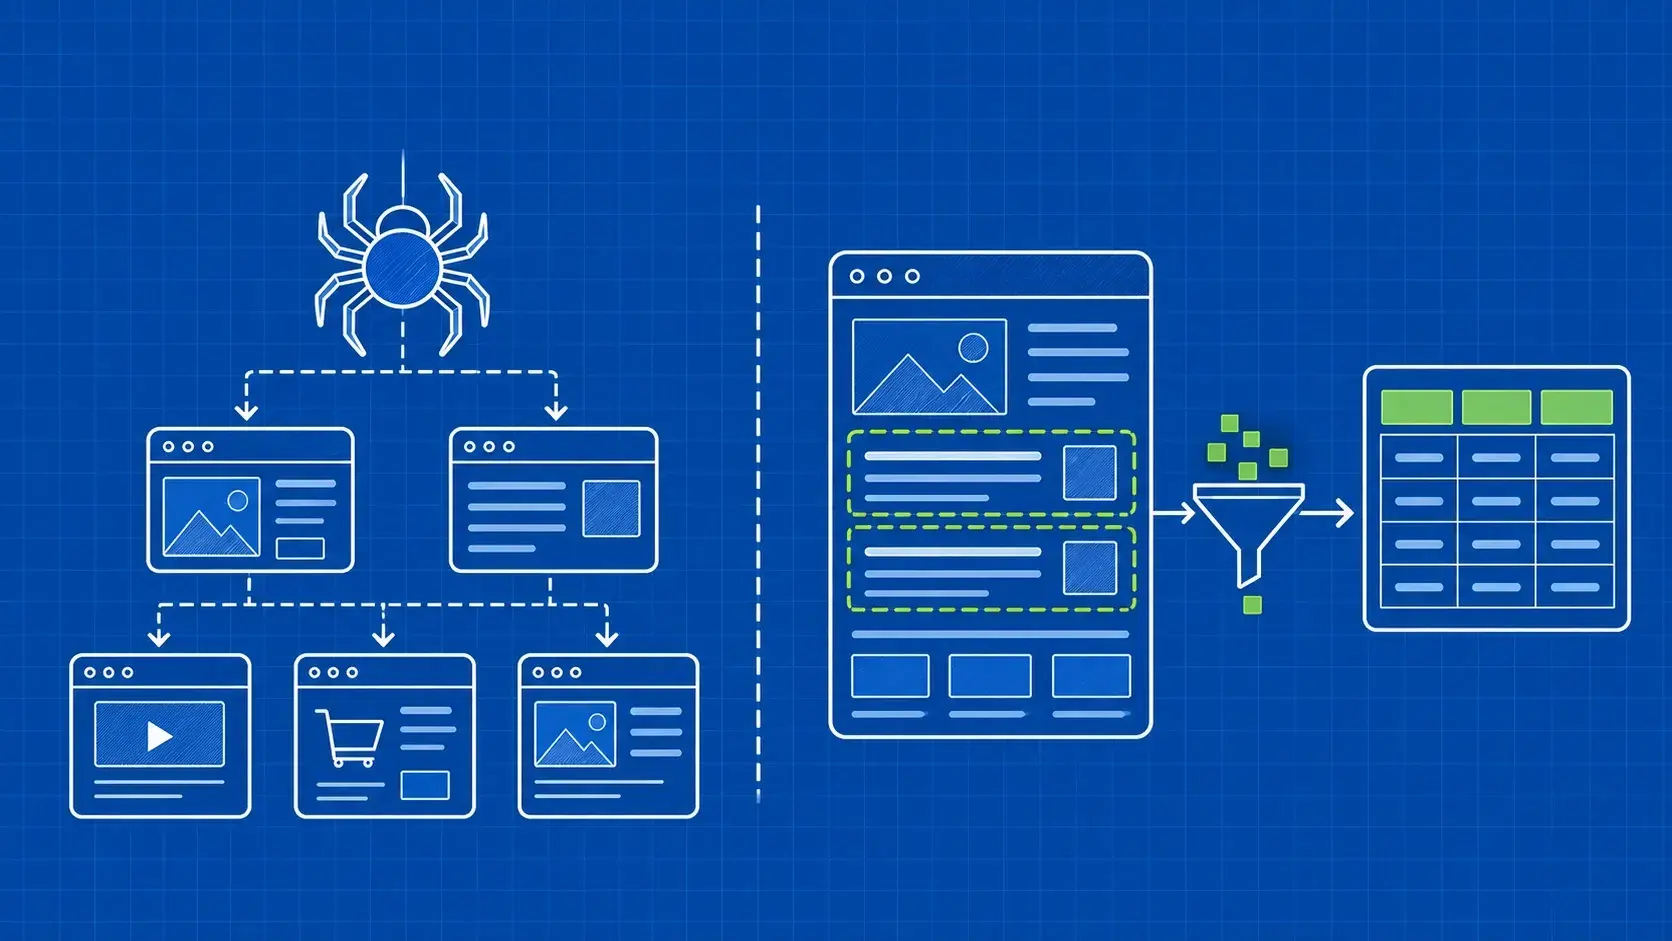
网页抓取与网页爬取的区别,在于从网页中提取信息与发现哪些页面需要访问之间的差异。你使用抓取来收集书名和价格等值;而使用爬取则是为了找到包含这些信息的页面。

假设你需要一份某网店销售的编程书籍电子表格。分类页面为你提供了起点,但它可能链接到多个结果页面。查找书籍链接是一个任务,从每个书籍页面读取正确的作者和价格则是另一个任务。

了解两者的区别有助于你避免两种令人沮丧的结果:要么得到一长串链接却没有可用数据,要么仅从少数页面获取了准确数据,而目录中的其余部分却被忽略。这也有助于你理解,当某款工具自称是“抓取工具”、“爬虫”、“蜘蛛”或“数据提取服务”时,它实际上究竟能做什么。

本指南将对比各种工具的输出结果,阐释其工作原理,并以一家虚构的书店为例,展示从发现到验证记录的全过程。这样,您就能掌握一种实用的方法,先选择工作流并在小批量数据上进行测试,然后再将其扩展应用。

网页抓取与网页爬取:输出结果对比

网络爬虫负责发现网页并决定访问哪些页面;网络抓取工具则从页面内容中提取信息。两者均能获取网页内容,且都能处理大量页面,但它们在数据采集任务中承担着不同的环节。

比较要点

网页爬取

网页抓取

主要目的

查找并访问相关页面

收集所需的字段或文本

典型输入

起始地址和导航规则

页面地址或内容及提取规则

有用的输出

URL、下载的页面及访问信息

结构化数据,例如标题、价格和日期

主要质量问题

任务是否成功访问了目标页面?

是否提取了正确的值?

常见故障

遗漏页面或跟随了无关链接

字段缺失或读取了错误的元素

例如,发现某家商店的产品页面是一项爬取任务,而提取每件产品的价格则是一项数据抓取任务。一个需要监控不断更新的商品目录的项目,必须能够同时处理这两类任务。

两者的区别并不在于“单个页面与多个页面”。你可以抓取一份包含数千个地址的预先提供的列表,而无需发现新的链接;你也可以爬取某个网站中一个明确界定的较小区域。

在比较网页抓取与网页爬取工具时,应关注工具返回的结果。一串链接列表并不包含你所需的商品价格。反之,从一个已知页面获取的正确价格也并不能证明你已找到商品目录的其余部分。请根据最终输出结果所需的功能来选择工具。

Web 爬虫如何发现页面

首先从种子 URL 开始,即爬虫开始探索的起始地址。在一家书店网站上,种子 URL 可以是“编程”分类页面。爬虫获取该页面,识别符合条件的链接,并将新地址放入队列中——该队列本质上就是一份等待访问的页面列表。

有限范围的爬取遵循可重复的顺序:

  1. 从队列中获取一个地址。
  2. 从返回的页面中读取链接。
  3. 根据该页面的地址解析相对链接。
  4. 保留符合域名和路径规则的地址。
  5. 将未访问过的地址添加到队列中。
  6. 重复此过程,直到队列清空或达到停止阈值。

分页是这很重要的一点原因。某个分类的首页可能只显示其商品目录的一部分。点击符合条件的下一页链接可以显示更多产品,而页面限制则使测试保持在可控范围内。

抓取与索引是两个独立的过程。谷歌在解释搜索工作原理时,将下载页面与分析并将其内容存储在索引中区分开来。发现或检索并不保证会被纳入搜索结果。您自己的爬虫可能只需生成一份清单,而不涉及搜索索引。

对于网络抓取与网页爬虫项目,请确保该清单可供检查。 保存已发现的地址以及足够的访问信息,以便排查故障。我们的 GoSpider 爬取指南展示了专用发现工具如何融入更庞大的数据收集工作流中。爬虫的任务是在爬取完您定义范围内的页面时即告完成,而非在探索完遇到的每个链接之后。

网络爬虫如何提取有用字段

产品页面包含的内容远不止价格。它可能包含导航、相关产品、客户评论以及不同版本的多种价格。数据抓取工具需要制定规则,将您所需的字段与其他内容区分开来。

该过程始于解析,即读取页面结构以便定位相关元素。CSS 选择器可通过元素类型、类名或其他属性来识别元素。例如,浏览器的 querySelector 方法会返回第一个匹配的元素;若无匹配项,则返回空结果。正是由于这种行为,爬虫才需要显式处理字段缺失的情况。

典型的数据提取任务包括以下步骤:

  1. 检索页面内容。
  2. 定位包含所需字段的元素。
  3. 读取其值。
  4. 将这些值规范化为所选格式。
  5. 在保存记录前对其进行验证。

例如,显示的价格 €18.50,例如,可以转换为 18.50 ,并 EUR 在单独的货币字段中则变为。在构建提取规则之前,请先确定您需要当前价格、原价,还是两者兼有。

CSS 选择器是一种选择;XPath 网络抓取则提供了另一种定位文档结构内内容的方法。这两种方法都无法替代对目标数据是否实际获取的检查。如果页面通过 JavaScript 添加字段,在提取前使用无头浏览器进行渲染可能会很有帮助。

这就是网络抓取与网络爬虫在数据质量方面的区别。地址可能正确,下载也可能成功,但提取的价格可能缺失或属于另一版本。请验证数据值,而不仅仅是请求结果。

书店示例:从链接到记录

假设您想要获取一个关于编程书籍的小型数据集。以下域名 books.example、书名及下文中的数值均为虚构。它们仅用于说明工作流程,并非暗示我们曾执行过实际的数据采集任务。

发现相关地址

向爬虫提供类别地址 https://books.example/category/programming。允许该分类在同一域名下存在分页和商品页面。请将无关分类排除在此练习之外,并在开始前设置较小的页面限制。

发现阶段可能会生成以下网址:

https://books.example/book/python-foundations
https://books.example/book/practical-web-data

这些 URL 是向提取阶段的交接信息。它们告诉您查找位置,但尚未说明具体哪本书的价格是多少。

提取并验证每条记录

在此练习中,定义五个字段:来源 URL、书名、作者、价格和货币。一个示例性的提取记录可能如下所示:

{
  "url": "https://books.example/book/python-foundations",
  "title": "Python Foundations",
  "author": "Taylor Reed",
  "price": 18.5,
  "currency": "EUR"
}

请将缺失值与有效值区分开来。如果未显示价格,请将该记录标记为待审核,而不是保存为零。如果两个版本的书名相同,请保留其唯一标识的URL,而不是仅凭书名将其合并。一个有用的规则是存储足够的上下文信息,以便再次找到确切的来源条目。

合并任务但不要混淆

一个程序可以同时处理这两项任务。Scrapy 教程演示了在同一个蜘蛛中提取数据并跟随下一页链接。是否使用独立的应用程序是可选的;职责划分明确才能使问题更容易排查。

对于这个书店练习,请分别审查地址清单和记录。缺失的书籍可能表明检索存在问题;存在但价格错误的书籍则暗示数据提取存在问题。网络抓取与网络爬虫的区别在实践中至关重要,因为这两类故障需要不同的解决方法。

选择工作流并测试小批量数据

选择能够产生预期结果的最简单工作流。如果已知确切的页面地址,通常就无需单独进行发现步骤。

起始情况

有用的第一步方法

你拥有一份固定的商品URL列表

检索并抓取这些页面

您需要定位某个类别中的页面

在明确界定的范围内进行爬取

你需要从不断变化的产品目录中获取记录

将发现与提取相结合

您需要一份页面清单以供审计之用

爬取并保留相关的访问信息

提供合适的导出功能或已文档化的 API

在收集页面内容前评估该接口

在决定采用网络爬取还是网络抓取时,还应考虑您能够轻松维护的范围。解析器需要字段选择规则,爬虫则需要导航和停止规则。框架可以整合这些功能,而托管服务则可以负责工作中的特定部分。

请从您控制的网站或专用于抓取的测试环境开始。在运行任何操作之前,先选择一个页面并记录下预期的字段。将提取的记录与源数据进行对比,然后扩展到一个您仍能手动审查的小批量数据。

用具体标准定义该批次的成功:成功访问了预期页面、必填字段完整,且抽样价格与目标产品相符。这比单纯统计成功请求的数量更有参考价值。

一旦该批次运行正常,请逐一调整某个维度,例如页面数量或涵盖的类别。这样更容易将意外结果与导致该结果的变更联系起来。

避免常见的爬取和数据抓取错误

广泛的链接发现可能会超出您预期的任务范围。过滤器、日历和重复导航可能会生成大量网址。在扩大覆盖范围之前,请设定边界和停止条件。

重复项的处理也需谨慎。有些 URL 参数仅用于跟踪访问记录;有些则用于选择不同的产品版本或地区。在移除参数之前,请先确认该参数会改变什么内容。同样,标题相同并不意味着两条记录描述的是同一件商品。

请遵守网站的爬取规范。《机器人排除协议》标准明确指出: robots.txt 规则不等同于访问授权。被允许的路径不应被视为访问或重复使用其内容的 blanket permission。请将数据采集限制在您获授权的范围内。

除了提取的数据外,还应关注响应信号。HTTP 429 表示客户端在一定时间内发送了过多的请求。 Retry-After 请求头可能指示何时应重试。请遵守该信号,而非在紧凑循环中立即重复相同请求。

最后,对可比工作进行衡量。对已知页面的单次请求与爬取过程中发现的数百个页面,属于性质不同的任务。渲染要求、页面数量、数据提取复杂度以及请求节律都会影响所需的时间和资源。在网页抓取与网页爬取之间,并不存在普遍意义上的速度赢家。 请分别跟踪发现的 URL、检索到的页面和有效记录,以便您了解时间消耗的具体环节以及任务中需要重点关注的部分。

关键要点

  • 从所需结果出发。页面清单需要发现;价格表则需要字段提取。
  • 通过允许的域名、相关路径和明确的停止限制来控制爬取范围。在扩大覆盖范围之前,请先审查已发现的 URL。
  • 在进行抓取前定义必需字段。将缺失的值视为需要检查的问题,而不是用看似合理的默认值来替换它。
  • 分别验证发现、检索和提取环节。请求成功并不意味着生成了正确的记录。
  • 逐步扩展经过验证的小批量数据,以便理解结果变化的原因。

常见问题

我可以从保存在计算机上的 HTML 文件中提取数据吗?

可以。只要文件包含您需要的字段,您无需再次加载页面即可解析已保存的 HTML。请同时保留原始 URL 和下载时间,以便对提取的值进行追溯。如果文件是在 JavaScript 添加相关内容之前保存的,那么仅凭后续解析该文件,相关内容并不会自动出现。

爬虫能否发现没有入站链接的页面?

爬虫需要该地址的其他来源,例如网站地图或明确的种子列表。 仅靠跟随链接无法发现那些未被任何已访问页面指向的页面。当完整性至关重要时,请将发现结果与可访问的权威页面清单进行比对。队列为空仅表示当前可探索的页面已探索完毕,并不证明所有页面均已被发现。

我应该多久重新访问一次页面?

请根据数据集所需的新鲜度以及数据源的运行限制来设置重访计划。一次性存档和每日价格报告的需求各不相同。记录采集时间,并观察各字段在两次访问之间是否确实发生了变化。利用这些观察结果来优化计划,而不是假设更频繁的采集总能产生更有用的数据。

开始之前需要学习 Python 吗?

不需要。爬取和数据抓取是具体任务,而非某种编程语言的专属功能。你可以使用自己已掌握的其他语言,或使用通过可视化界面提供所需工作流的工具。你仍然需要定义所需的页面和字段,检查生成的记录,并了解工具为你处理了流程中的哪些部分。

结论:构建能产生有用数据的最小工作流

数据采集项目的有效成果是您能够理解并验证的数据。“网页抓取”与“网页爬取”分别描述了帮助您实现这一目标的两项职责:查找相关页面,并从中提取所需信息。

如果您已经拥有网址,请先对一个页面进行提取测试;如果网址缺失,请先定义一个范围有限的发现任务。无论哪种情况,在扩大处理规模之前,都应先确定有效记录的标准。书店案例之所以可行,是因为输出字段和预期的页面范围足够清晰,便于检查。

随着项目规模扩大,请确保交接过程保持透明。记录哪些页面已被发现、哪些已被检索,以及哪些产生了有效数据。这些证据有助于您区分导航问题、字段缺失或请求失败,并为您提供具体的修复起点。

如果页面检索成为您需要帮助操作的部分,请探索 WebScrapingAPI 提供的 Scraper API。它可以处理检索层,同时您仍可明确指定数据收集范围和数据校验规则。从一个具有代表性的页面开始,并根据项目实际需要的字段来评估结果。

关于作者

Anda Miuțescu, 技术内容撰稿人 @ WebScrapingAPI

Anda Miuțescu

技术内容撰稿人

安达·米乌特斯库是 WebScrapingAPI 的技术内容撰稿人,负责创作清晰、实用的内容,帮助开发者了解该产品及其功能。

Nodriver Python 教程:隐身浏览器爬取——从第一个脚本到投入生产
网络爬虫技术

Nodriver Python 教程:隐身浏览器爬取——从第一个脚本到投入生产

TL;DR: 简而言之:Nodriver 是一个异步 Python 库,通过 Chrome DevTools Protocol 驱动 Chromium,无需 Selenium 或 chromedriver 二进制文件。当一个更接近真实 Chrome 会话的自托管隐身浏览器比 WebDriver 技术栈更合适时,请使用它;但要知道,它本身并不能消除 IP、TLS 或行为层面的风险。本教程从第一个脚本讲到容器化生产部署以及托管的 Browser API。

Suciu Dan5 min read
阅读文章
如何在搜索结果页面(SERP)抓取工具中处理 Google /goto 重定向 URL 和 CAES 令牌
网络爬虫技术

如何在搜索结果页面(SERP)抓取工具中处理 Google /goto 重定向 URL 和 CAES 令牌

TL;DR: Google 搜索会在搜索结果页面(SERP)中的结果与目标页面之间插入一个不透明的重定向。href 属性中可能不会直接显示 URL,而是显示包含 CAES 令牌的 google.com/goto——或者较旧的 /url 包装形式。了解如何在生产环境的 SERP 抓取工具中,无需解密 CAES 即可对这些重定向进行分类、去重和解析。

Suciu Dan4 min read
阅读文章
cURL 中的 HTTP 响应头:每个标记、技巧和脚本配方
网络爬虫技术

cURL 中的 HTTP 响应头:每个标记、技巧和脚本配方

TL;DR: 简要说明:cURL 默认隐藏响应头信息。使用 -i 可以看到响应头和正文,使用 -I 可以看到 HEAD 请求只返回响应头,使用 -v 可以看到完整的请求/响应调试,使用 -D 可以将响应头保存到文件中。对于现代脚本,cURL 7.83+ 允许提取单个头信息,或使用 -w write-out 选项将所有头信息转存为 JSON 格式。

Suciu Dan3 min read
阅读文章

开始构建

准备好扩展您的数据收集规模了吗?

加入2,000多家企业,使用WebScrapingAPI在无需任何基础设施开销的情况下,以企业级规模提取网络数据。