

用例
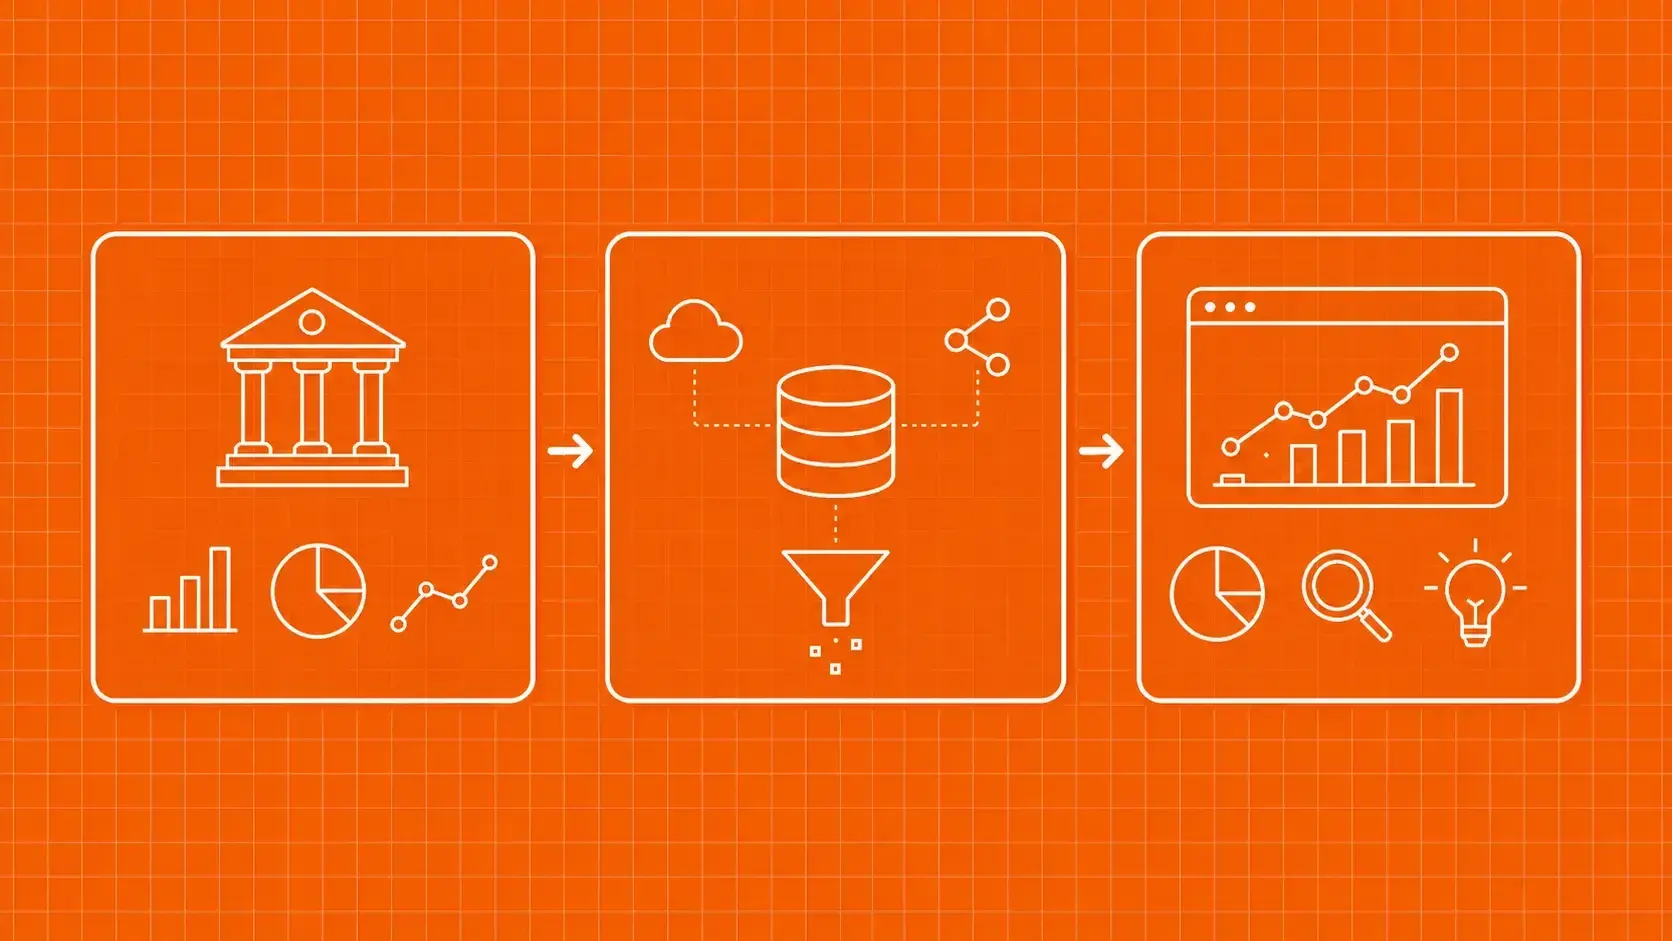
另类金融数据挖掘:网络数据如何为投资者带来优势
TL;DR: 简要说明:另类数据挖掘使用网络收集技术来收集非传统数据集(产品定价、情绪、招聘信息、监管文件),这些数据集在财报中出现之前就能揭示市场信号。本指南将向您介绍价值最高的数据源、如何建立金融级管道、数据质量验证以及您需要遵守的合规准则。
Mihnea-Octavian Manolache1 min read
阅读文章Blog · 文章
实际应用案例、客户故事以及行业特定用例,展示了团队如何大规模利用网络数据。
已发表的文章
13
文章
13 文章
TL;DR: 简要说明:另类数据挖掘使用网络收集技术来收集非传统数据集(产品定价、情绪、招聘信息、监管文件),这些数据集在财报中出现之前就能揭示市场信号。本指南将向您介绍价值最高的数据源、如何建立金融级管道、数据质量验证以及您需要遵守的合规准则。

TL;DR: 简要说明:财务数据是量化记录(收入、支出、资产、负债、现金流)的集合,组织和个人利用这些数据做出明智的经济决策。本指南分解了四种核心财务报表,比较了传统数据源和替代数据源,介绍了现代收集方法,并涵盖了专业人士赖以进行分析的工具。

TL;DR: 简要说明:XPath 和 CSS 选择器都能定位 DOM 元素,但它们解决的问题不同。CSS 选择器更快、更易读,适合直接选择。当你需要从任意方向遍历 DOM、匹配文本内容或处理复杂的条件逻辑时,XPath 就会胜出。大多数生产项目都能从这两种策略中获益。
TL;DR: 简而言之:使用 -x 或 --proxy 参数通过代理运行 cURL,然后在构建自动化流程之前,对比直接连接和通过代理连接时获得的公共 IP 结果。本指南涵盖身份验证、HTTP 和 SOCKS 模式、持久化设置、绕过策略、IP 轮换、安全凭据处理、平台配置以及基于症状的故障排除。
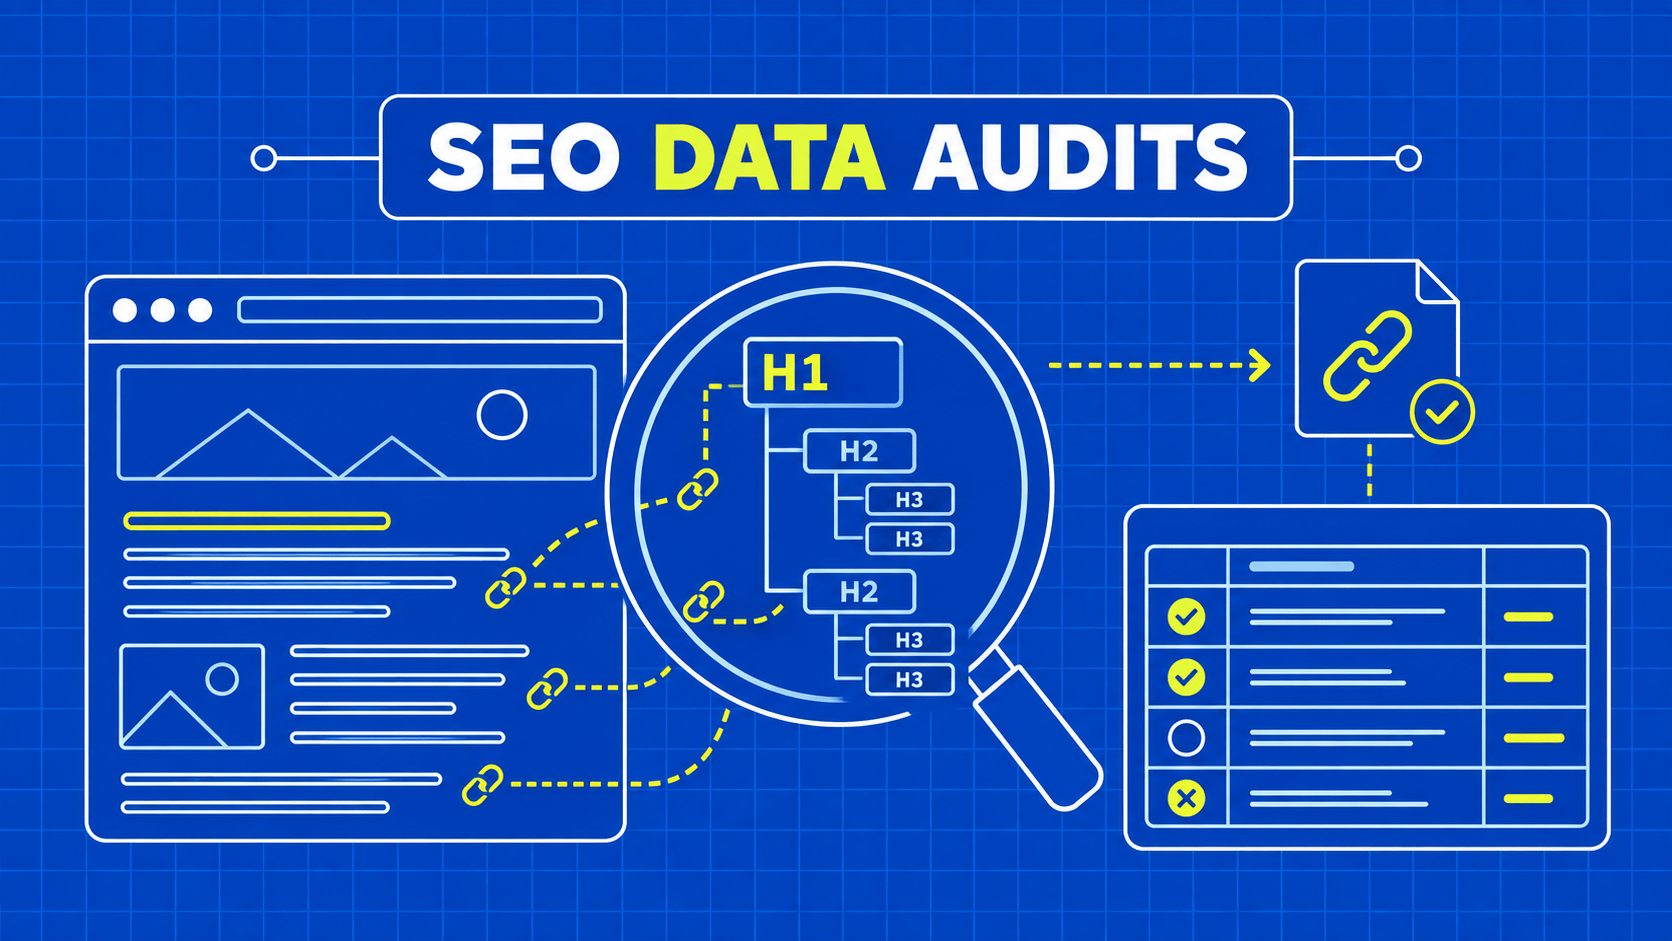
TL;DR: 构建一份权威的SEO审计报告,将观察到的页面证据与搜索引擎结果区分开来。对比页面渲染、规范链接信号、指令以及模板缺陷。

TL;DR: 有没有一种简单快捷的方法可以从Airbnb提取数据?有的,这就是网络爬虫大显身手的时候了。让我们通过WebScrapingAPI向您展示具体操作方法。
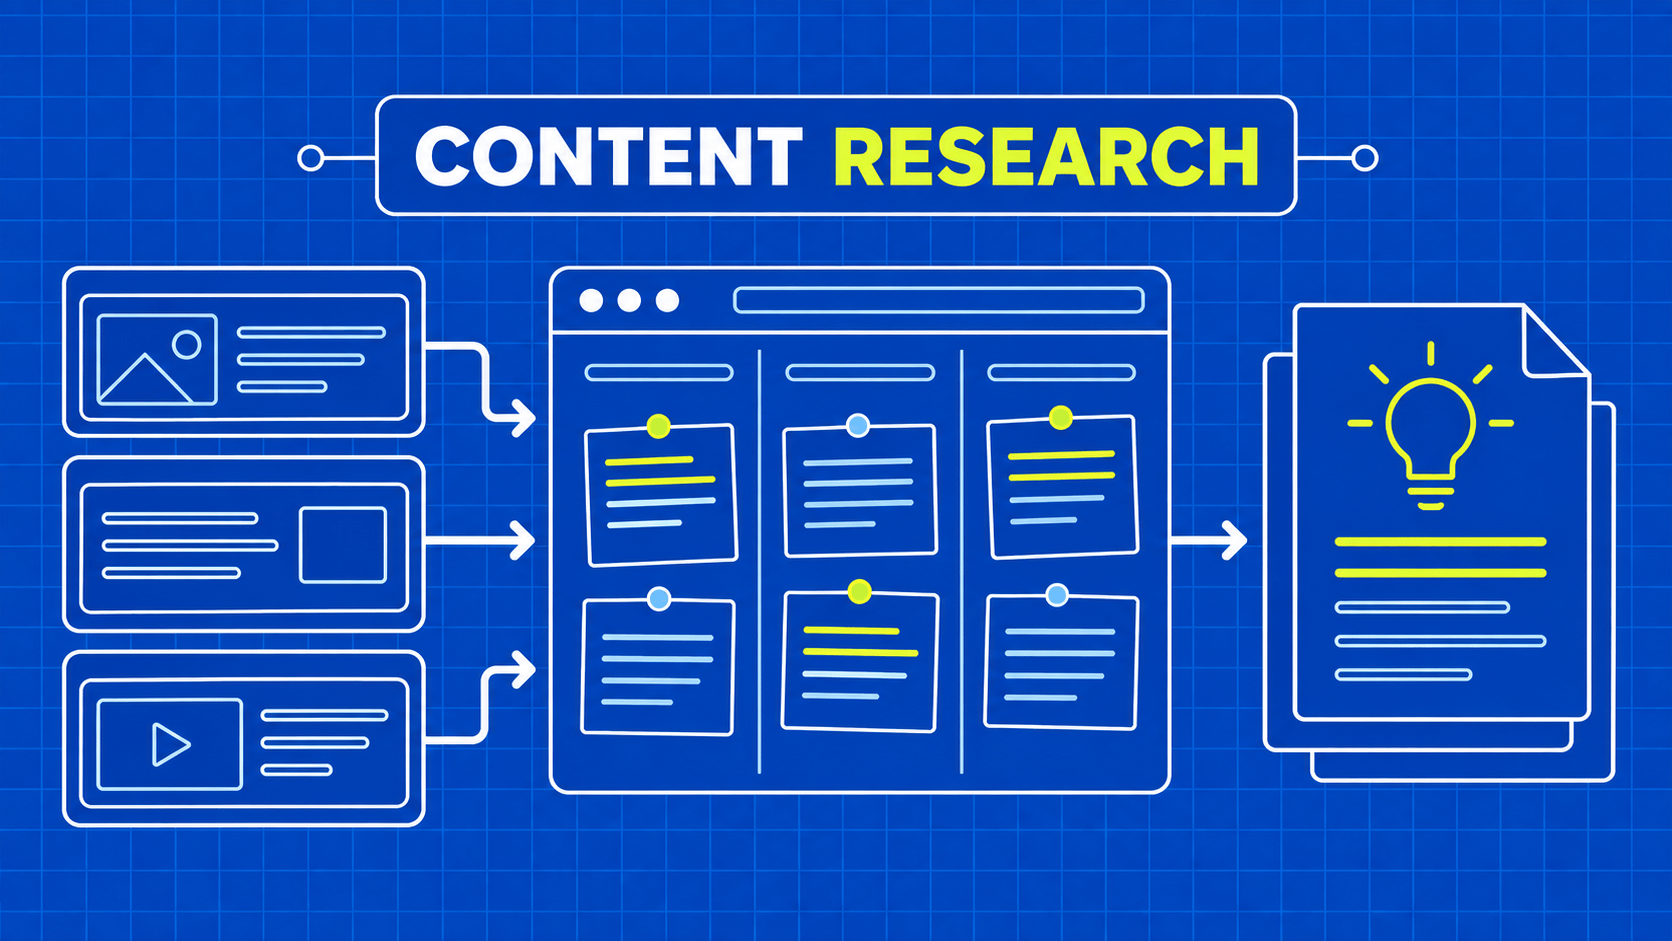
TL;DR: 建立证据清单,识别读者与任务之间的差距,并将经过审查的观察结果转化为原创内容。保留来源、不确定性,并提供清晰的视觉解释。
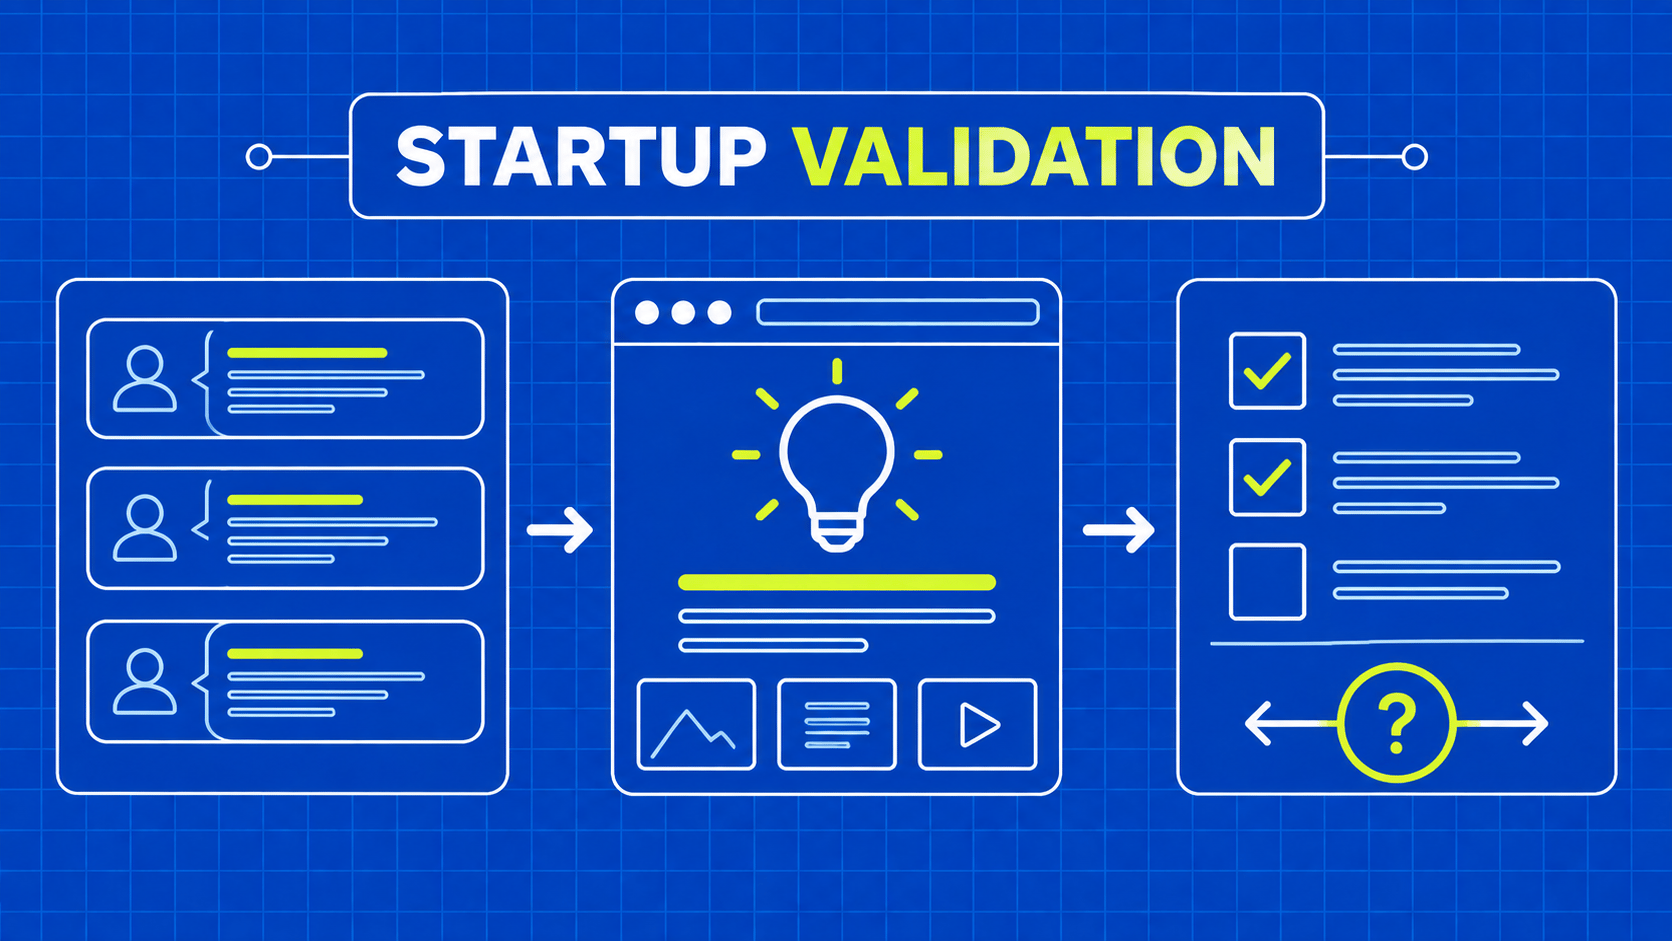
TL;DR: 利用一个范围有限且经过审核的数据集,对初创企业的上线假设进行验证。将数据采集质量与用户研究相结合,并设置一个能够缩小项目范围或终止项目的上线门槛。

TL;DR: 企业在哪些情况下最常使用网页抓取技术?了解网页抓取技术在哪些应用场景中表现尤为出色。
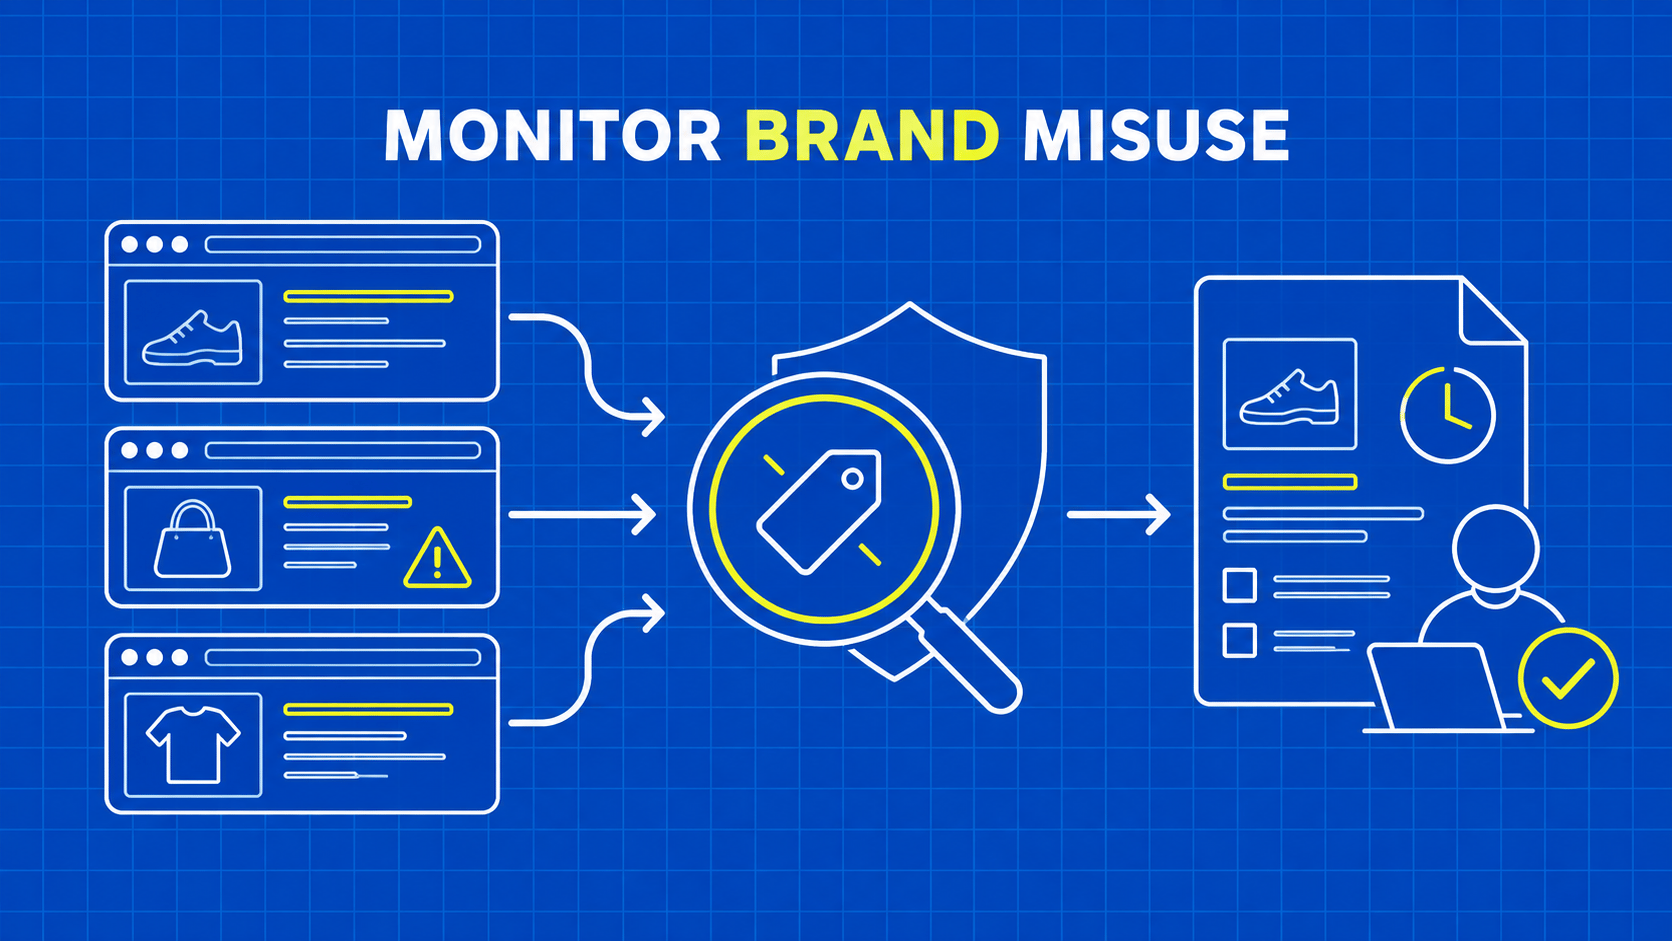
TL;DR: 用网页抓取搭建品牌保护监测流水线:发现可疑商品链接、保存证据、减少误报,并为人工审核提供支持。
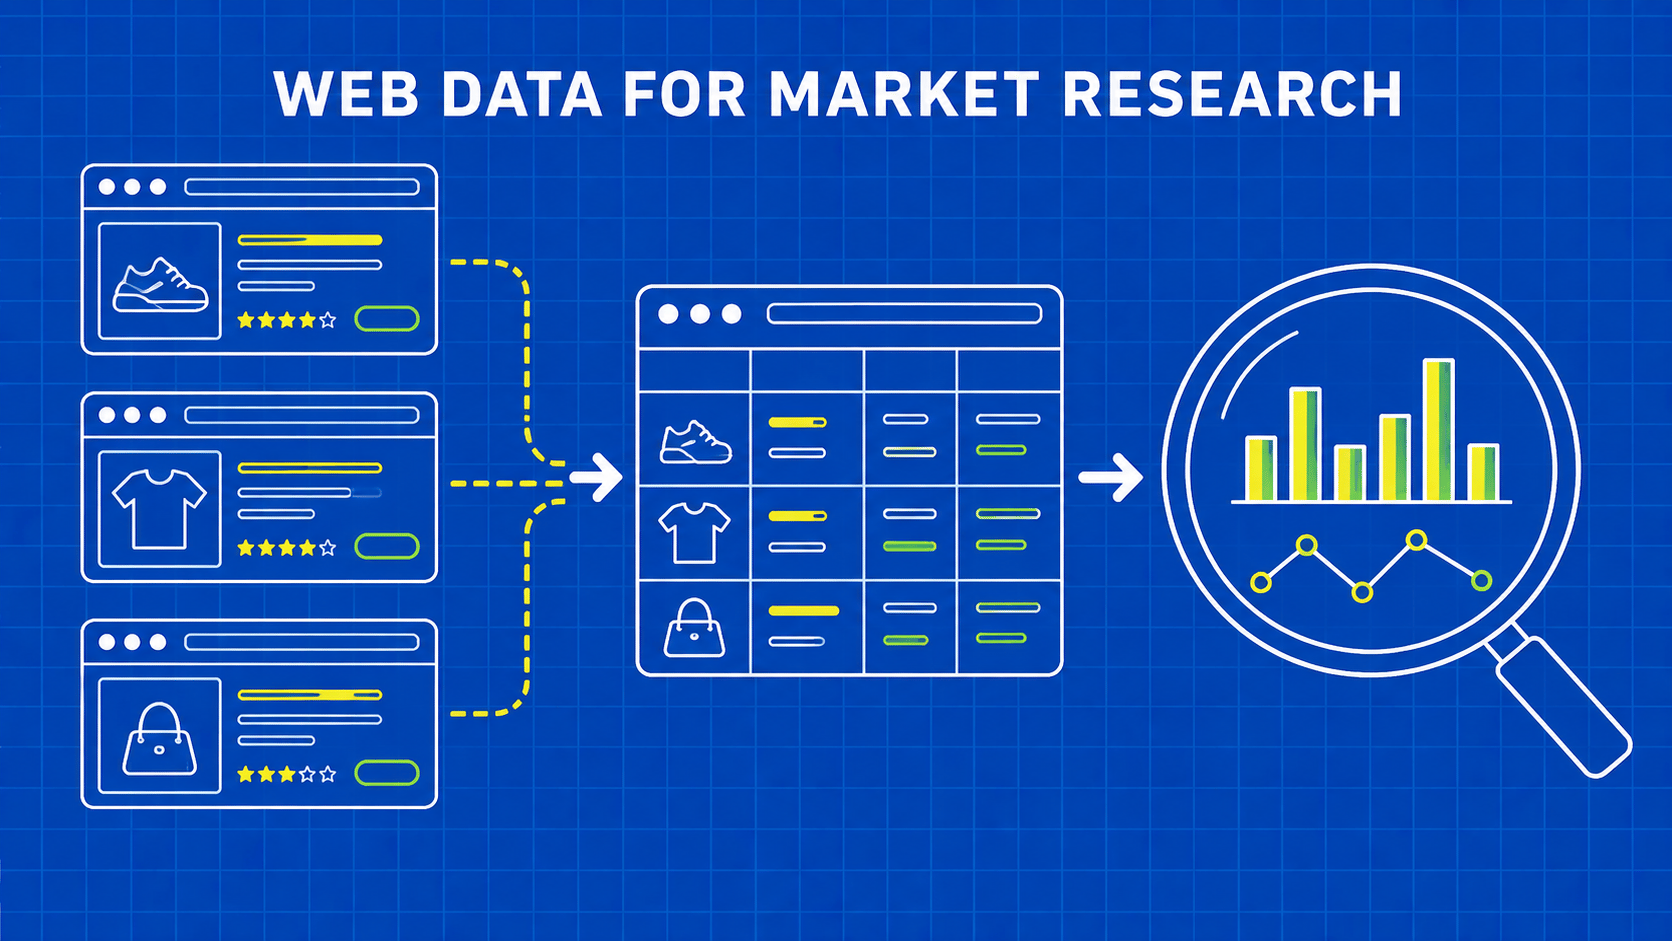
TL;DR: 构建值得信赖的竞争对手数据集:定义样本、匹配产品、验证价格,并在报告市场观察结果时避免夸大证据。
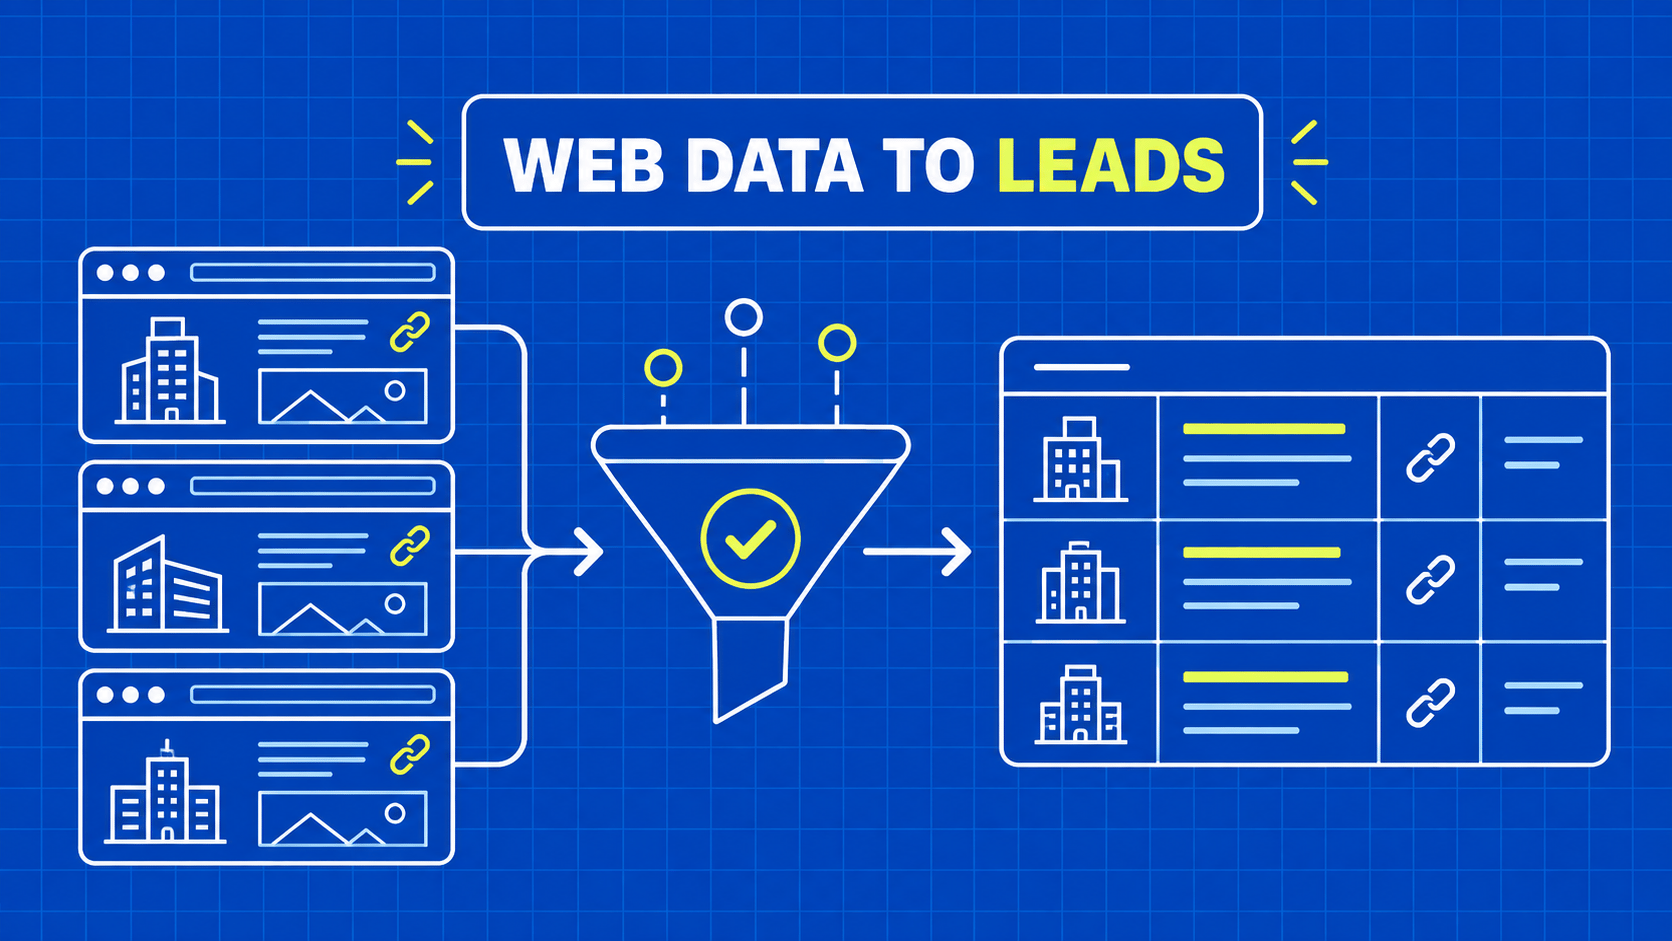
TL;DR: 用网页抓取搭建 B2B 销售线索管道:选择数据源、规范化企业数据、去重、对客户进行资格评估,并安全同步到 CRM。
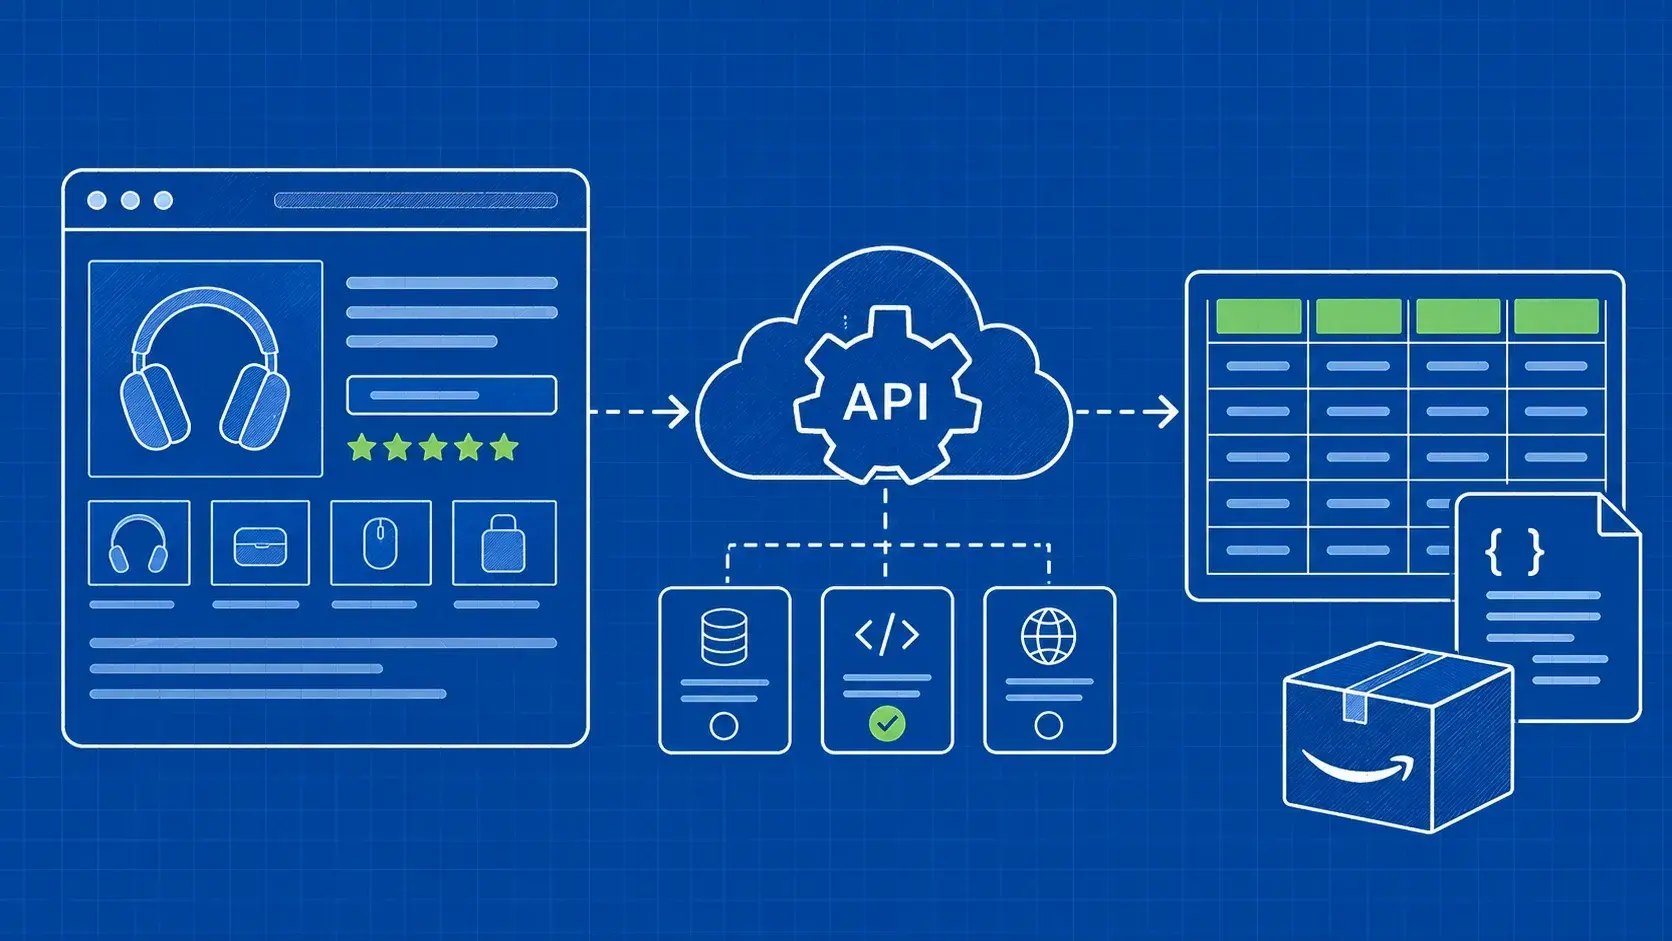
TL;DR: 根据输出结果、位置控制和工作流适配性,对比五种亚马逊数据抓取API方案。通过实际测试和成本核算,为您的项目选择合适的方案。