
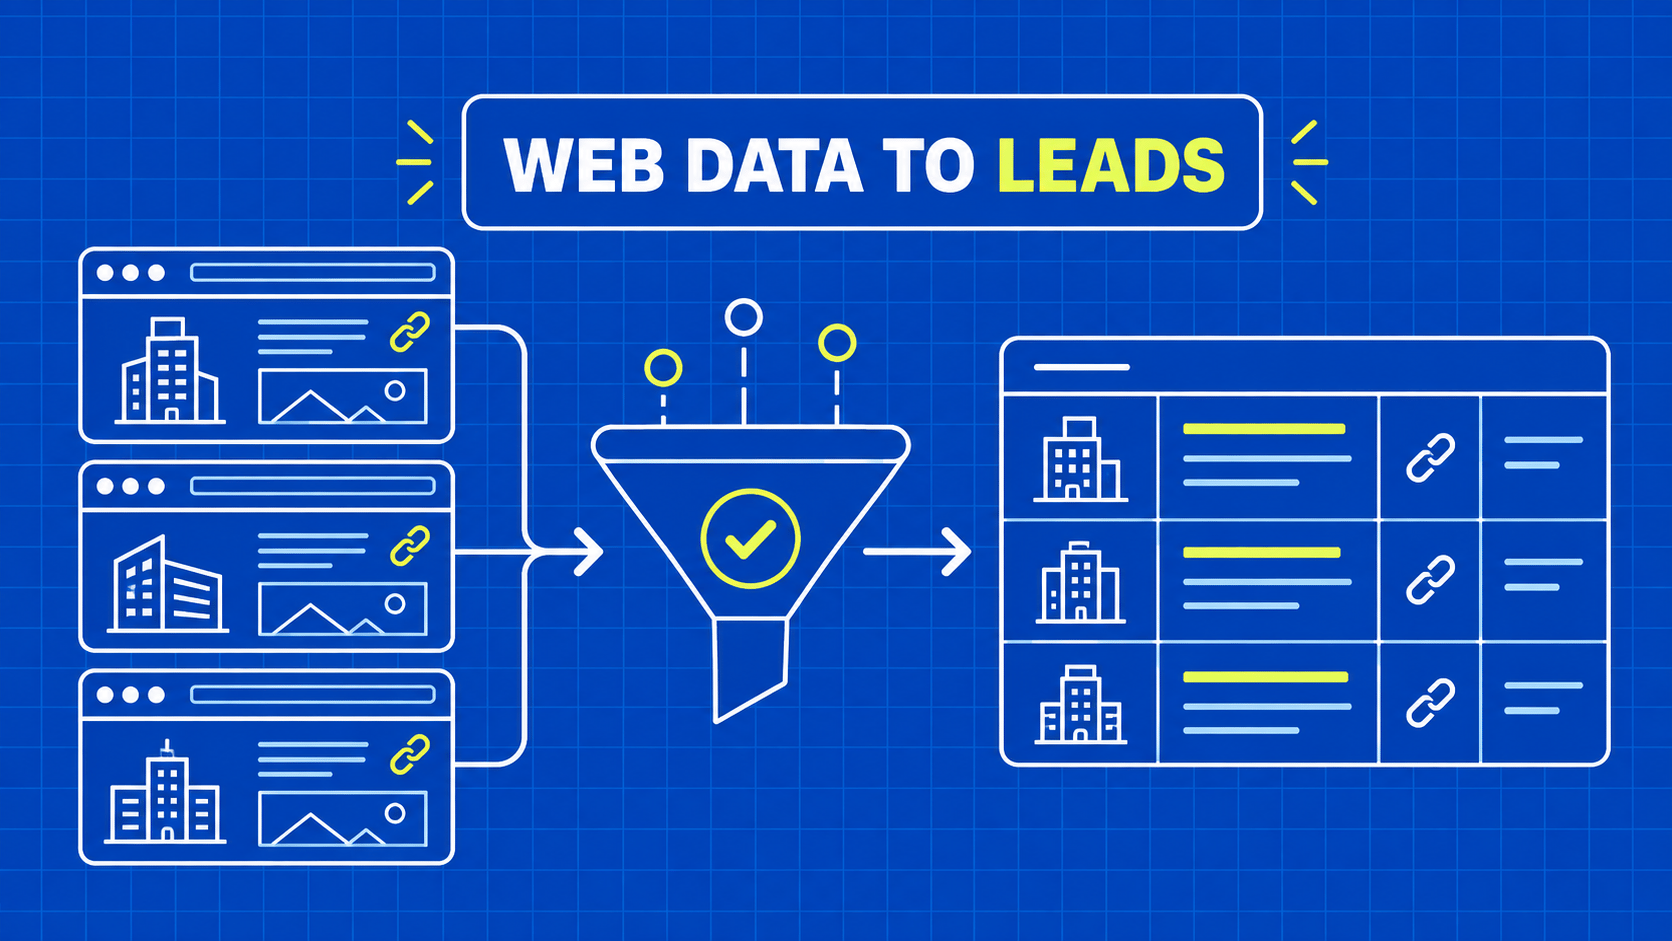
要点速览:面向线索获取的网页抓取,会把经过许可的企业网站和行业名录转化为结构化的客户(account)数据。整套流程应围绕企业身份、来源证据、数据新鲜度和 CRM 匹配来搭建。是否可以联系某个人,是一个独立的决策,与采集企业记录本身无关。
面向线索获取的网页抓取,是指自动采集网站信息,用于发现和评估潜在的企业客户。一个有用的结果是一条企业记录:它带有经过验证的域名、相关的业务属性,以及能说明它为何应进入你的销售管道的证据。
与线索获取并列的网页抓取商业用例还包括市场调研、竞品分析和品牌监测。
设想两份导出结果。第一份包含数千个公司名称,以及一列标为“已合格”的字段。第二份的客户数量更少,但每一行都写明了官方网站、该公司提供的服务、这一事实被观察到的时间,以及资格判定所依据的来源。开发人员能够调试第二份导出,销售运营团队能够审核它,两个团队都不必去相信一个来路不明的分数。
本指南的目标就是第二种结果。你将定义所需的客户、选择数据源、提取一个刻意精简的模式(schema)、规范化身份信息,并把经过审核的记录交给 CRM。示例聚焦于组织及其公开的业务活动,而不是大量收集个人联系方式。无论你是从一个获准使用的行业名录起步,还是从一份自己已在维护的企业网站列表起步,这套架构都同样适用。
LinkedIn 上的公司主页就是这样一种数据源,我们的用 Python 抓取 LinkedIn 指南介绍了无需登录即可获取哪些公司字段。


