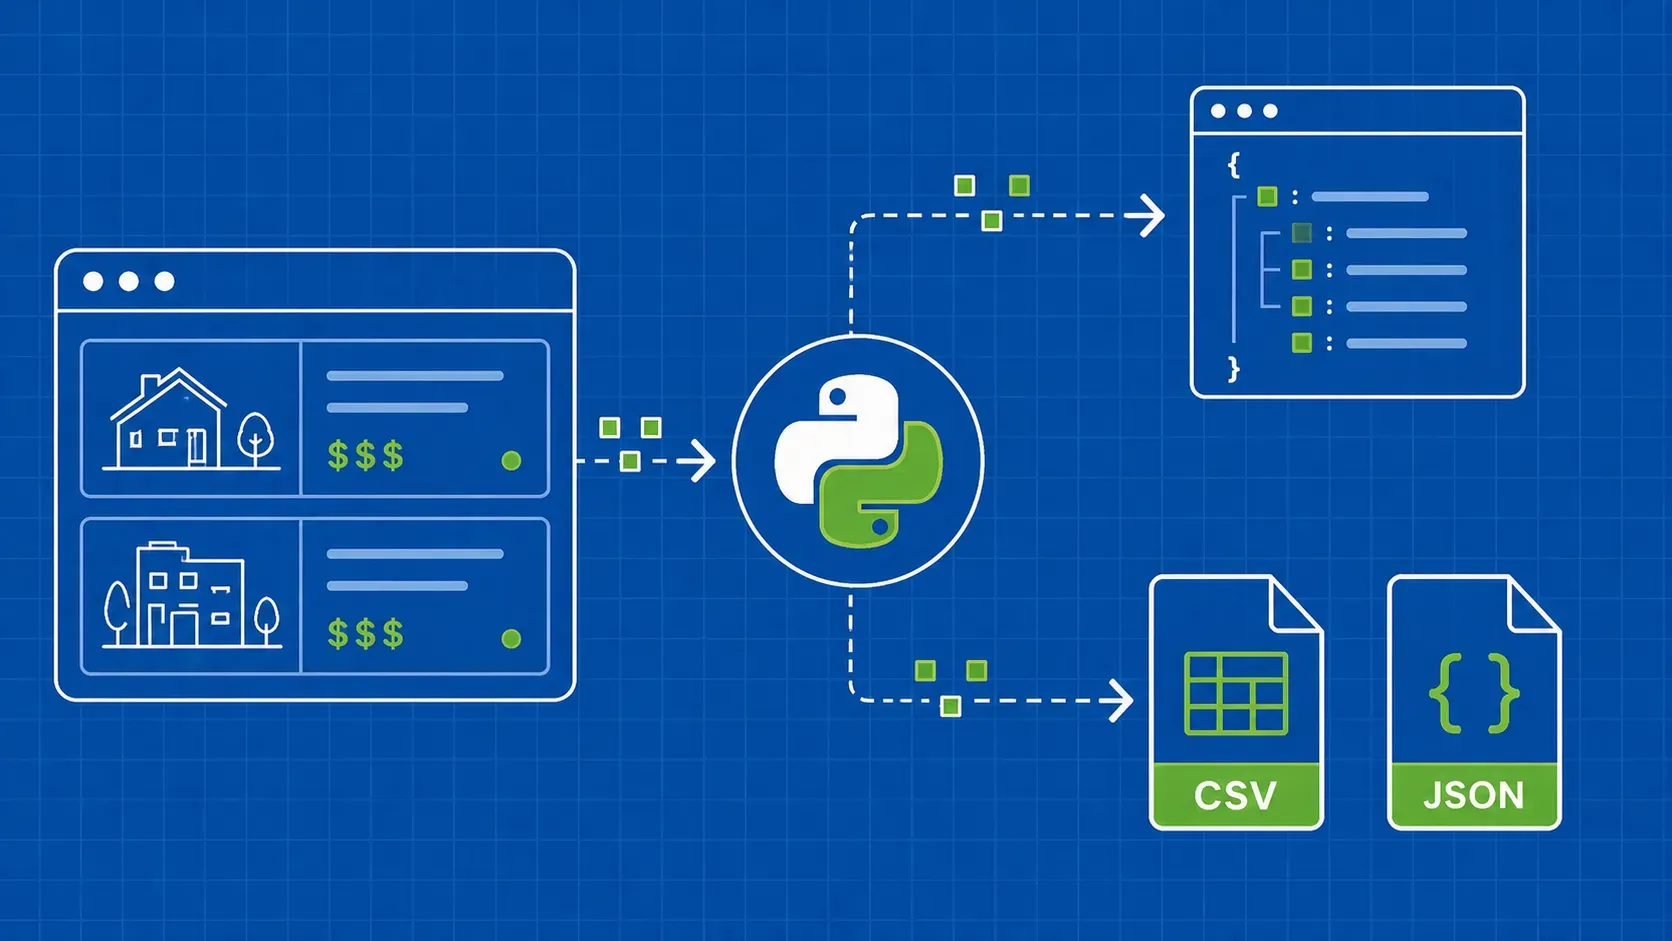
简而言之:开始使用 Ruby 进行网页抓取时,先找出数据所在的位置,然后选择能够获取该数据且功能最精简的工具。 对于响应中已存在的 HTML,使用 Faraday 和 Nokogiri 进行处理,将经过验证的记录模式导出为 CSV 文件,并仅在需要渲染或交互时才配合 Capybara 使用 Selenium。最终得到的爬虫,其请求层即使发生变化,也不会影响解析、验证或导出功能。
使用 Ruby 进行网页抓取,是指请求网页内容,在 HTML 或浏览器渲染的文档中定位有用值,并使用 Ruby 代码将这些值转换为结构化记录的过程。最易于维护的方法是使用能够可靠访问数据的最轻量级技术栈。
这通常意味着使用 Faraday 进行 HTTP 传输,使用 Nokogiri 进行解析。它们启动迅速、测试简单,只要服务器响应中包含目标字段,就能满足需求。 如果内容由 JavaScript 生成,或者允许的工作流需要交互操作,Selenium 和 Capybara 可以提供浏览器备用方案,但它们也会增加资源消耗,并带来更多可能导致失败的因素。
本教程将围绕一个稳定的本地目录数据集,构建一个渐进式的 Ruby 网络爬取工作流。您将通过显式设置超时和响应检查来获取 HTML,提取一致的记录结构,规范化 URL 和价格,验证行数据,并导出确定性的 CSV 文件。 随后,您将添加有限重试、速率控制、选择器测试、基于浏览器的等待、受保护的凭据以及并发限制。目标并非构建一个依赖框架的爬虫,而是一个小型 Ruby 网页抓取工具——即使目标、网络或访问方式发生变化,其行为依然清晰可理解。
最终, output/products.csv 将生成可预测的请求头,且每行对应一个经过验证的产品。该提取器既可处理下载的标记,也可处理浏览器渲染的标记,这使得工具的选择具有可逆性。当 gem、浏览器、打包方式或法律细节发生变化时,请对照当前的官方文档进行验证。这样既能确保本教程的可重现性,又能让你根据已批准的目标调整选择器。