跳至内容
免费开始
返回博客

从 API 中提取数据:一个可靠的第一条数据处理管道

Gabriel Cioci最后更新于 1 min read
从 API 中提取数据:一个可靠的第一条数据处理管道

开始提取

免费试用 WebScrapingAPI

领取 1,000 个免费 API 积分。无需信用卡。

开始使用
简而言之:API数据提取是一个从文档化请求到经过验证的记录的处理流程。首先定义一个简单的输出规范,在本地测试分页和错误情况,然后添加真实的客户端、持久化检查点,并明确报告数据收集是否完成。

一个请求返回产品列表,你的脚本解析 JSON,终端打印出一行数据。这虽是一个有用的初步验证,但从 API 中提取数据远不止于接收单次响应。一个可靠的提取器必须能够判断哪些记录有效、如何继续处理,以及当仅收到部分预期数据时应如何报告。

本指南以一个虚构的产品目录为例,阐述这些决策。该练习使用本地 Python 测试环境而非网络服务,因此您无需凭证或外部流量即可测试续传、重复数据处理以及被拒绝的记录。一旦这些规则运行正常,真实的 HTTP 客户端即可通过相同的接口提供页面数据。

本文侧重于实现而非术语。如果您对方法、请求头和响应状态码仍不熟悉,请参阅《API 入门指南》了解这些基础知识。本指南的目标是构建一个小型数据提取方案,其中包含可观察的成功和失败条件。您将能够明确哪些数据被接受、哪些被拒绝,以及是否达到了源文档中规定的结束条件。
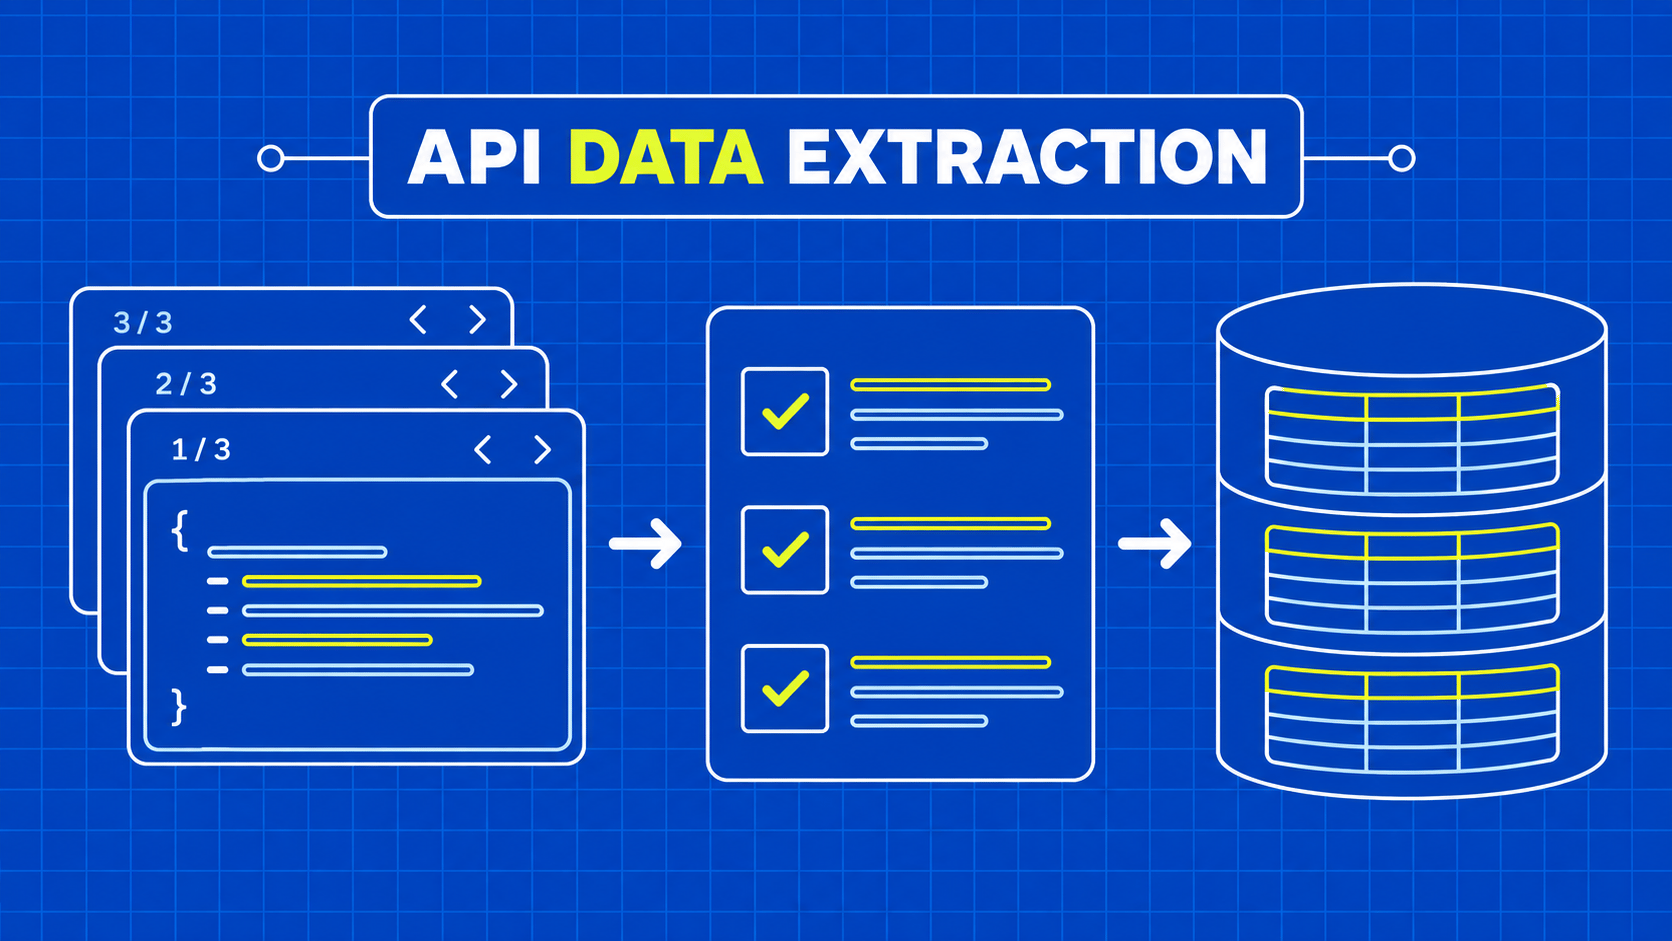
围绕输出契约规划 API 数据提取

在构建循环之前,先写下你打算返回的行。对于这个虚构的目录,每行被接受的数据都需要一个稳定的产品 ID、一个非空的名称、一个以美分为单位的非负整数价格,以及欧元 (EUR) 作为货币。这些是针对本练习的特定规则,并非适用于所有提供商的假设。

将源合同与目标模式区分开来。源数据可能将货币表示为十进制文本、整数或格式化的显示值。在映射到目标时,请明确保留该含义。名为 price 的字段本身并不能说明其单位、税务处理方式或货币。

决策

示例规则

未能避免

标识

保留源产品ID

将数组索引视为产品键

必填文本

名称必须包含非空格文本

将空白字段作为完整记录发布

数值含义

本设备合同下的整数分

根据数值推测单位

重复项处理政策

本练习中保留首次出现的结果

静默合并冲突的观测值

补全

在记录的空游标处停止

将页面预算停止标记为已完成

来源

保留请求范围和采集时间

丢失了选择这些记录的上下文

重复项处理策略需要明确选择。本示例保留了第一个有效记录,因为其测试数据重复了完全相同的产品。而实际的动态目录可能需要通过比较时间戳或生成冲突记录来处理。去重处理应实现所选策略,而非掩盖不同观察结果之间的不一致。

从 API 提取数据时,应区分被拒绝的记录与失败的页面。根据您的策略,一个无效项可能被隔离,而其他项仍可继续使用。无法识别的页面封装可能会导致您无法信任其中的项及续页值,因此盲目继续操作将带来另一种风险。

最后,需明确数据采集范围。应记录相关账户、过滤条件、时间段及端点版本。即使在该范围之外的记录准确无误,对于当前任务而言仍属错误输出。

将检索、解码和记录接受分离

在实现中使用三个边界。检索从提供商处获取响应;解码对表示形式进行解析;接受则对业务记录进行验证和映射。每个边界都应返回有用的结果或分类明确的失败信息,而不是默默地用空集合来掩盖问题。

检索层负责处理已记录的请求、凭据、传输超时以及 HTTP 响应状态。它应提供足够的经过清理的证据以供诊断故障。不要让记录验证器承担推测 HTML 错误页面是由于超时还是登录要求而产生的责任。

解码层负责检查预期的格式和封装。JSON 解析仅能确认文本符合 JSON 语法,但无法证明结果就是产品页面。JSON 规范定义了值和结构,而字段的含义则由应用程序契约决定。

在此练习中,一个页面包含一个 items 列表和一个 next 值,该值要么为 null,要么为非空字符串。若封装格式异常,则视为页面失败。随后,每个项目在进入接受输出之前,都会根据产品规则进行独立验证。

这些边界使得从 API 中提取数据的测试更加容易。本地测试数据可以替代数据检索,同时仍可执行生产环境中的解码和接受逻辑。您可以重现格式错误的行或重复的光标,而无需依赖提供商按需生成该条件。

在添加真实客户端时,请将其职责范围限定得尽可能窄。Python HTTP 客户端的对比有助于评估请求控制,但没有任何客户端库能够推断出您对有效产品的定义。请将该定义放在一个单独且可供审查的函数中。

此外,请避免捕获所有异常并返回 []。这种模式会导致不可用的基础设施与有效的空目录无法区分。调用方应能够判断提供方是未返回匹配记录,还是提取器无法生成有效结果。

进行本地分页和验证练习

将以下内容保存为 extract_fixture.py 并使用 Python 3 运行。该代码仅使用标准库,不进行任何网络请求。模拟的分页数据包含两个有效产品、一个无效价格以及一个完全相同的重复项。最后的断言还验证了重复的续行游标会明显失败。

from copy import deepcopy

PAGES = {
    None: {"items": [
        {"id": "p1", "name": "Lamp", "price_minor": 2400,
         "currency": "EUR"},
        {"id": "bad", "name": "Chair", "price_minor": True,
         "currency": "EUR"},
    ], "next": "page-b"},
    "page-b": {"items": [
        {"id": "p1", "name": "Lamp", "price_minor": 2400,
         "currency": "EUR"},
        {"id": "p2", "name": "Book", "price_minor": 650,
         "currency": "EUR"},
    ], "next": None},
}

def valid_record(row):
    return (
        isinstance(row, dict)
        and isinstance(row.get("id"), str) and bool(row["id"].strip())
        and isinstance(row.get("name"), str) and bool(row["name"].strip())
        and type(row.get("price_minor")) is int
        and row["price_minor"] >= 0
        and row.get("currency") == "EUR"
    )

def collect(fetch_page, max_pages=5):
    cursor, visited, accepted = None, set(), {}
    rejected = duplicates = 0
    for _ in range(max_pages):
        if cursor in visited:
            raise ValueError("pagination cursor repeated")
        visited = visited | {cursor}
        page = fetch_page(cursor)
        if not isinstance(page, dict) or not isinstance(page.get("items"), list):
            raise ValueError("invalid page envelope")
        if "next" not in page or not (
            page["next"] is None
            or isinstance(page["next"], str) and bool(page["next"])
        ):
            raise ValueError("invalid continuation")
        for row in page["items"]:
            if not valid_record(row):
                rejected += 1
            elif row["id"] in accepted:
                duplicates += 1
            else:
                accepted = {**accepted, row["id"]: dict(row)}
        cursor = page["next"]
        if cursor is None:
            return list(accepted.values()), rejected, duplicates
    raise ValueError("page budget exhausted before completion")

rows, rejected, duplicates = collect(lambda cursor: deepcopy(PAGES[cursor]))
assert [row["id"] for row in rows] == ["p1", "p2"]
assert (rejected, duplicates) == (1, 1)
assert not valid_record({"id": "x", "name": "X",
                         "price_minor": True, "currency": "EUR"})
try:
    collect(lambda cursor: {"items": [], "next": "same"})
except ValueError as error:
    assert str(error) == "pagination cursor repeated"
else:
    raise AssertionError("repeated cursor was accepted")
print("2 accepted, 1 rejected, 1 duplicate; cycle check passed")

该模拟传输返回的是副本,因此提取操作不会修改数据集。收集器在处理行之前会验证封装,将游标与商品标识分开跟踪,并且只接受符合声明规则的记录。重复的页面和重复的商品是两种不同的情况。

请注意数值类型的检查。在 Python 中,布尔值是整数的子类,因此宽泛的整数实例检查会将 True 作为价格。该测试用例通过精确类型比较刻意排除了这种情况。其他语言和模式工具也需要对类型转换和允许的类型给予同等关注。

页面配额是一种保护性限制,而非完整性保证。如果它在空延续出现之前到期,该操作将引发错误。它绝不会仅仅因为循环达到了配置的最大值就返回正常的完成结果。

这是一个教学用的数据提取器,而非生产环境中的存储系统。它将已接受的记录累积在内存中,并在页面失败时触发异常,而非持久化地保留部分进度。在从 API 大规模提取数据之前,请使用能够保留已接受工作的接收器和运行记录来替代上述限制。

接下来的本地测试应反映您的契约:缺失的延续键、非列表 items 字段,以及冲突的重复项。请明确预期结果。目标是测试真实数据源可能强加的决策,而非构建一个仅仅重复实现逻辑的庞大测试套件。

明确分页完成条件和检查点

本练习使用游标值,但不同提供商发布的分页契约各不相同。有些返回链接,有些使用偏移量,还有些需要页码或延续令牌。GitHub 的分页文档展示了该服务基于链接的延续机制;这仅是一个示例,并非通用的 API 格式。

请完全按照提供商的要求保留不透明的续传值。将相关的过滤器和账户上下文保留在工作项中。为某个请求范围生成的令牌不应被视为适用于任何后续查询的独立指令。

在跟随基于 URL 的续传链接之前,请对其进行验证。响应中提供的下一页链接应位于您的集成被授权访问的目标范围内,重定向也需要进行相同的边界检查。切勿仅仅因为响应中包含某个 URL,就将凭据转发给无关的主机。

从 API 提取数据并写入持久化存储时,应在推进检查点之前先提交已接收的数据。如果检查点先移动而存储失败,重启时可能会跳过某些记录。如果先存储数据而检查点更新失败,下次尝试可能会重放一页数据,这可以通过有意的重复数据处理策略来处理。

当接收端和检查点共享同一存储系统时,原子事务可发挥作用。若未共享,请记录重放和对账的运作机制。切勿仅因正常路径下每个源标识符存储一行数据,就声称实现了“仅处理一次”的处理模式。

记录结束原因。源提供的最终页面、页面配额、截止时间以及被拒绝的响应属于不同的结果。仅包含已接受条目计数的报告无法说明该作业是否覆盖了预期范围。

同时需验证提供方对数据变化的假设。基于偏移量的列表在遍历过程中可能发生位移,且光标可能在后续重启前过期。记录采集窗口,当任务所需的一致性强度高于实时遍历所能提供的水平时,应使用已记录的快照或增量机制。

处理重试时,切勿掩盖数据缺失或重复

重试是对操作的再次尝试,而非对其输入的修正。使用无效凭据或格式错误的参数重复请求,通常只会重蹈覆辙。首先应分类故障,并确定在再次尝试前是否存在可调整的因素。

对于 HTTP,RFC 9110 中的方法语义有助于区分安全的检索操作与重复执行可能产生业务影响的操作。即使是读取操作,也应限制尝试次数,并遵守提供商文档中规定的行为规范。在未确认重试功能将针对哪些错误和操作进行重试之前,请勿启用通用重试功能。

速率限制需要关注聚合负载。一个 429 响应表明已达到限流阈值;计数范围由服务定义,响应中可能包含延迟指导信息。RFC 6585 定义了状态码。多个共享凭据的工作进程可能会消耗相同的配额。

指定重试负责人。如果客户端、中间件和作业运行器都在后台进行重试,一次预期的请求可能会产生超过收集器记录范围的流量。应确保尝试次数和作业耗时足够透明,以便调查这种流量叠加现象。

从 API 提取数据时,应为部分收集维护独立的状态。如果前三页已成功接收,而第四页失败,则应按照策略保留已接收的数据,并记录缺失的范围。切勿人为生成“最后一页”标记,也不要提供未经验证的“完整”数据集。

保护故障报告本身。存储经过脱敏处理的请求标识符、响应类别和模式错误。避免仅仅因为出现故障,就将凭据、完整的账户记录或无限制的请求体转储到通用日志中。

最后,区分重复检索与重复交付。如果数据收集成功后下游导出失败,从存储的记录中重试导出可保留原始观测结果。而再次从源头获取数据则会生成一个新的运行,其数值和完整性可能有所不同。

提供带有溯源信息和变更校验的记录

一条被接受的记录应包含足够的上下文信息,以说明其来源。根据任务的不同,这包括源标识、采集时间、请求范围、端点版本和转换版本。请将源数据修改时间与采集器观察到该记录的时间区分开来。

除验证源响应外,还需验证交付边界。一个正确的整数在导出过程中可能变成文本,一个空值可能变成空单元格,或者消费者可能将时间戳解释为不同时区的时间。在发布整个运行之前,请定义输出模式并检查一个具有代表性的文件或消息。

对于按计划从 API 提取数据的情况,请添加一个微小变更监控器。将拒绝计数、必填字段的存在情况以及完成行为与该源的预期值进行对比。已接受记录的突然下降值得调查,但这并不一定就是提取故障;源过滤器或库存可能已发生合理变更。

保留一个经批准的测试用例以备维护之需。当提供商更改可选字段时,测试应验证您的映射是否能安全地忽略该字段,还是需要进行更新。当必填字段的含义发生变化时,应修订合同,而不是添加一个会产生看似合理输出的宽泛后备方案。

《自动化网页抓取指南》将这些验收和交付边界与更广泛的任务生命周期联系起来。无论输入来自有文档记录的 API 还是解析后的网页,都应遵循相同的运维规范。

在完成首次实施时,应生成一份他人可用的运行报告:包含“已接受”、“已拒绝”、“重复”和“页面失败”的计数;失败原因;以及经过验证的输出位置。该报告将可运行的脚本转化为一个流程集合,其局限性始终清晰可见。

关键要点

  • 在循环从 API 中提取数据之前,先定义字段含义、标识、重复项处理规则和完成条件。
  • 将检索、解码和业务验证分开处理,以防止传输故障导致空的成功结果。
  • 在将提取器连接到实时数据提供方之前,请在本地测试循环游标、无效行和页面配额。
  • 在推进检查点之前,应持久化已接受的数据,并确保重启行为与有意重放兼容。
  • 保留部分运行记录,并对最终交付格式进行与源响应同样严格的验证。

常见问题

采集和转换是否应使用相同的计划?

不一定。收集源观测值和转换存储数据是不同的任务。将它们分离可以让你在无需再次向源系统发起请求的情况下修正映射。请决定原始观测值应保留多长时间,以及消费者需要哪些转换版本,然后根据这些要求为每个步骤安排计划。

API 收集器应如何处理新的可选字段?

遵循您为数据源选择的兼容性策略。忽略未知可选字段的采集器可以保持不变,而保留完整原始文档的采集器则可保留这些字段以供后续审查。在未核查其含义及访问影响之前,请勿自动将每个新字段暴露给下游用户。

CSV 导出能否保留所有 API 值?

若无明确的映射规则则无法做到。CSV 本身不会保留嵌套对象、数组,或“null”与“空文本”之间的区别。应有意识地将这些值扁平化或编码,记录相关约定,并测试消费者的解读结果。若后续处理可能需要表格中省略的信息,请保留更丰富的源数据表示形式。

结论

从 API 中提取数据时,应以小范围的契约和具备故障感知能力的循环开始。本示例演示了关键决策:仅接受已定义的记录,将重复的产品与重复的游标区分对待,并要求设置真正的结束条件。真实的 HTTP 客户端会引入传输方面的考量,但这些规则依然适用。

在安排任务之前,为已接受的数据指定一个持久化存储位置,确保检查点可安全重放,并生成一份能区分完整运行和部分运行的报告。这些控制措施使您能够扩大处理范围,同时不会增加识别缺失数据的难度。

如果某些必填字段只能通过网页获取,请考虑将 WebScrapingAPI 的 Scraper API 作为额外输入源。针对这些数据保持相同的接受、来源和交付协议,这样即使采集方法不同,数据管道也能保持一致性。

关于作者

Gabriel Cioci, 全栈开发工程师 @ WebScrapingAPI

Gabriel Cioci

全栈开发工程师

加布里埃尔·乔奇(Gabriel Cioci)是 WebScrapingAPI 的全栈开发工程师,负责构建和维护该平台的网站、用户面板以及面向用户的核心功能模块。

开始构建

准备好扩展您的数据收集规模了吗?

加入2,000多家企业,使用WebScrapingAPI在无需任何基础设施开销的情况下,以企业级规模提取网络数据。