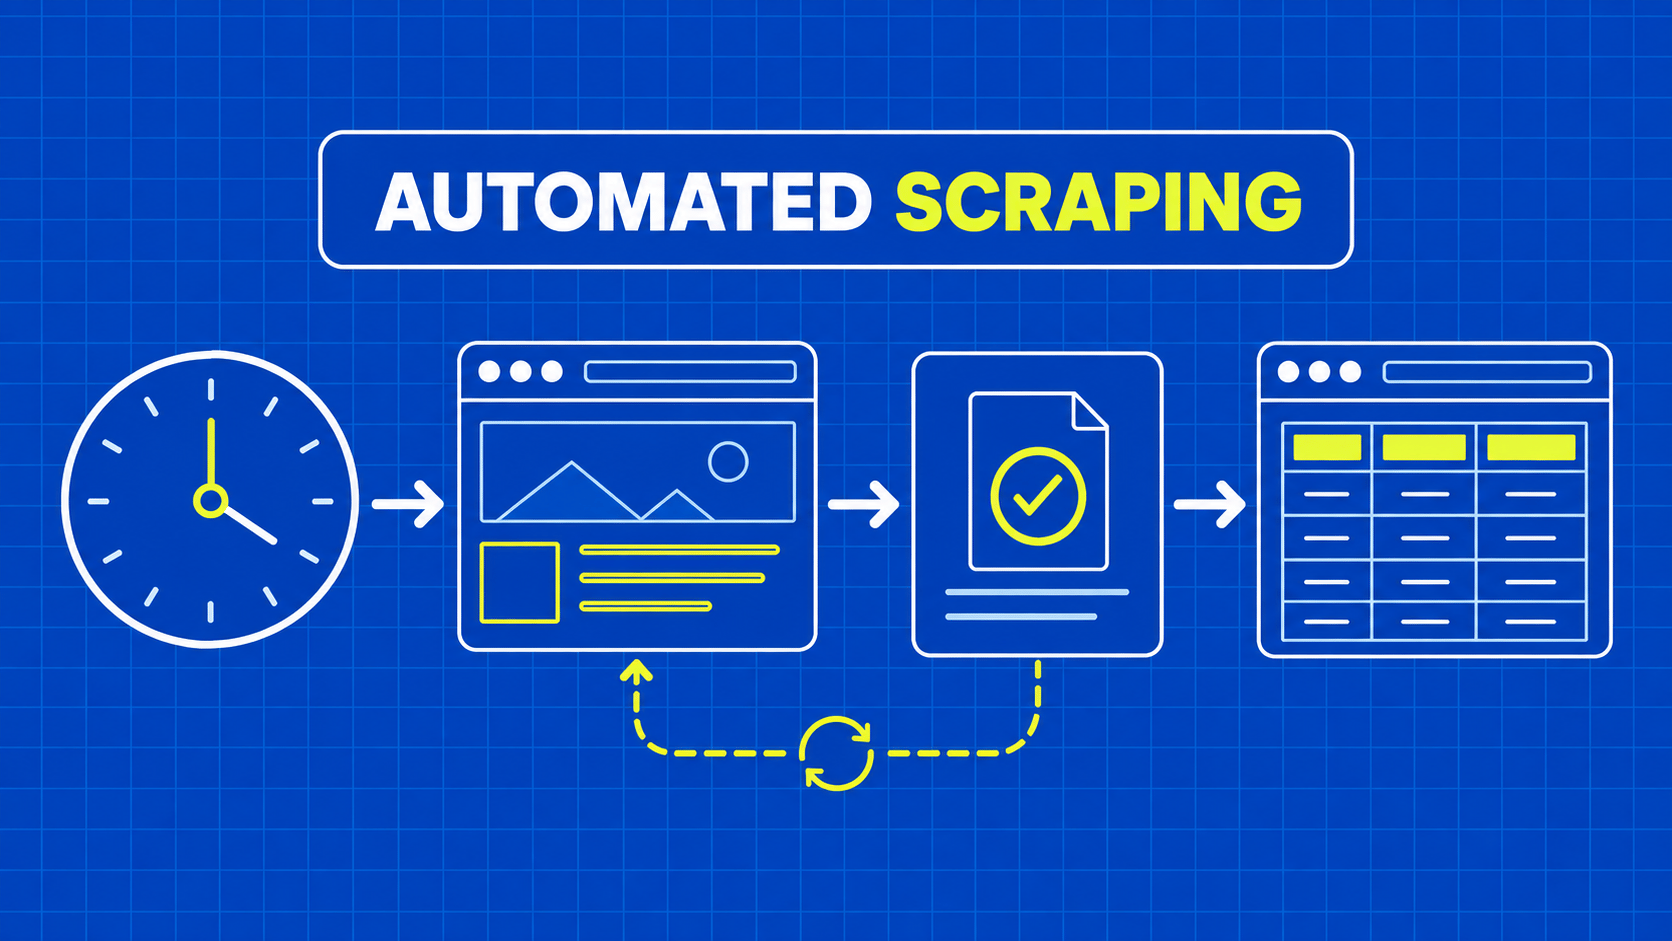
简而言之:自动化网页抓取不仅需要为脚本设置定时器。应将调度、采集、验证和交付分开处理;为每次运行分配唯一标识;并设计重试机制,以防止故障导致记录被无声复制或覆盖范围丢失。应衡量可用数据和数据时效性,而不仅仅是成功请求的数量。
一个按计划运行的采集器虽然没有抛出异常就完成了任务,但其导出的数据却包含的是昨天的数据,且产品数量仅为预期的一半。脚本确实运行了,但数据任务却失败了。在添加更多数据源或提高并发度之前,这一区别应当成为系统设计的基础。
自动化网页抓取是指通过定义好的、无人值守的工作流,对网站数据进行反复采集和转换。生产任务还需具备识别不完整结果、恢复中断工作以及说明交付内容的能力。否则,自动化只会让同样的不确定性按计划周期性地重演。
对于开发人员而言,最有用的起点是“运行契约”:范围涵盖哪些数据源、什么算作有效观测、结果存储位置,以及哪些故障应停止交付。相比于仅以退出代码作为成功信号的大型爬虫,具有这些边界条件的采集器更易于操作。
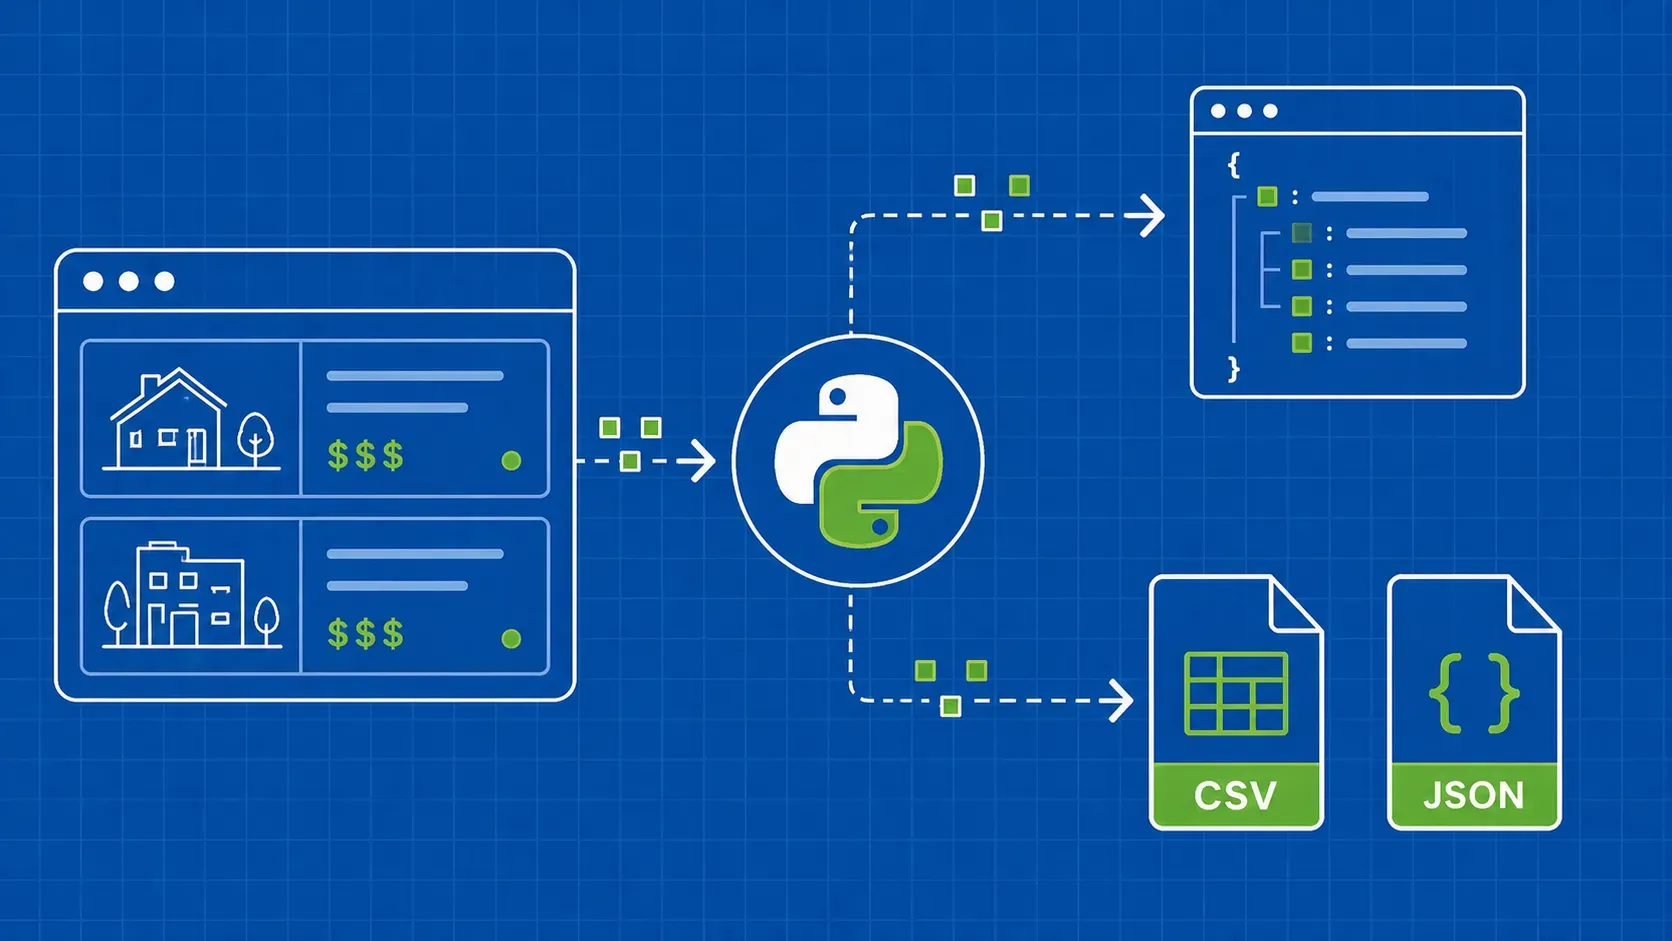
本指南以周期性目录收集为例,详细阐述了该架构。这些模式同样适用于公共目录、职位列表以及变更监控数据集。重点在于调度与恢复机制,而非承诺任何网站都能被自动抓取,也并非意味着自动化能完全取代人工审核。