
网络爬虫技术
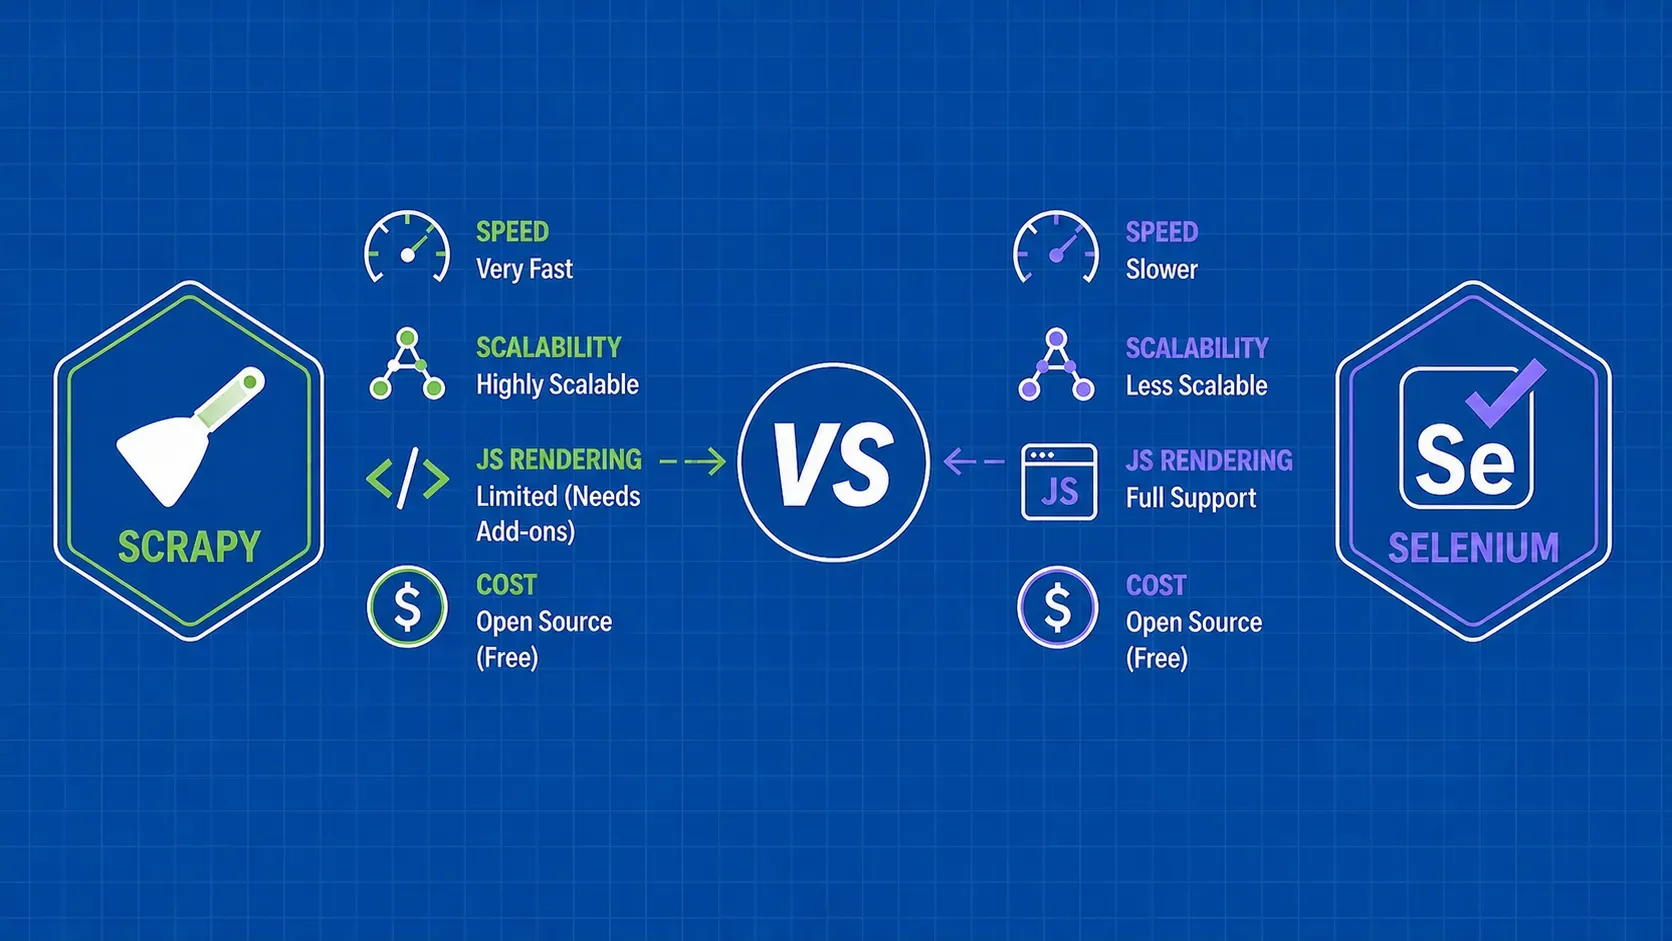
Scrapy 与 Selenium:谁是赢家?
TL;DR: 简要说明:Scrapy 是一个高速异步抓取框架,用于大规模从静态页面中提取结构化数据。Selenium 可自动运行真实浏览器并处理 JavaScript 繁重的网站,但资源成本要高得多。大多数生产型抓取项目都会受益于了解何时使用每种方法,或何时将它们结合起来使用。
Gabriel Cioci2 min read
阅读文章作者简介
加布里埃尔·乔奇(Gabriel Cioci)是 WebScrapingAPI 的全栈开发工程师,负责构建和维护该平台的网站、用户面板以及面向用户的核心功能模块。
已发表的文章
12 文章
TL;DR: 简要说明:Scrapy 是一个高速异步抓取框架,用于大规模从静态页面中提取结构化数据。Selenium 可自动运行真实浏览器并处理 JavaScript 繁重的网站,但资源成本要高得多。大多数生产型抓取项目都会受益于了解何时使用每种方法,或何时将它们结合起来使用。

TL;DR: 简要说明:职位搜索工具包括轻量级 API 服务和开源浏览器自动化,以及人工智能驱动的提取器和可视化无代码平台。本指南比较了 Google Jobs、Indeed、Monster、Upwork 和自由职业者市场上的最佳工作搜索工具,然后指导您通过重复数据删除、调度和反僵尸处理来构建可靠的管道,从而开始大规模收集干净的工作数据。

TL;DR: 学习用 urllib、requests 和 aiohttp 在 Python 中下载文件:流式下载、进度条、并行与异步下载、重试以及身份验证。
TL;DR: 简而言之:对大多数抓取团队来说,Oxylabs 和 Decodo 是最强的全能型高级代理服务,Bright Data 适合企业级预算,Webshare 则是从静态列表起步最便宜的选择。如果希望 IP 在租用期内归您专用,请选择静态列表;如果每个请求或会话都应通过不同的 IP 发出,请选择轮换网关。
TL;DR: 了解 Cookie 存储、浏览器策略和会话所有权如何影响抓取到的响应。学习如何在不泄露凭据的情况下诊断身份验证失败。
TL;DR: 根据保留工作量对 Web Scraper、Browse AI、Apify 和 Scrapy 进行比较。在替换 Octoparse 之前,应进行受控的可修复性测试,并验证交付成果是否完整。

TL;DR: 对于新产品来说,定价往往令人头疼。不过,有一个解决办法:从电商巨头那里抓取数据,并根据清晰的数据来定价。
TL;DR: 简要说明:Puppeteer 可让你在 Node.js 中完全控制一个无头 Chrome 浏览器实例,使其成为刮削 JavaScript 渲染页面的首选工具。本指南将指导你完成安装、基于选择器的提取、无限滚动、表单登录、请求拦截、隐身插件、结构化数据导出和 Docker 部署,这样你就可以从一个玩具脚本变成一个生产级的搜刮器。
TL;DR: 构建一份权威的SEO审计报告,将观察到的页面证据与搜索引擎结果区分开来。对比页面渲染、规范链接信号、指令以及模板缺陷。
TL;DR: 根据实际合同、安全配置、工具以及恢复行为来选择集成方案。将REST架构与SOAP消息传递区分开来,并破除常见的误区。
TL;DR: 构建一个 API 提取工作流,该工作流需对记录进行验证、跟踪延续令牌,并报告未完成的运行。在使用正式服务之前,请先使用本地测试环境进行练习。
TL;DR: 简而言之:2026 年最好的网络搜刮工具可分为三类:将代理、无头浏览器和验证码隐藏在 HTTP 调用背后的托管 API;Scrapy 和 Crawlee 等开源框架,如果你能托管它们,就能完全控制;以及面向非开发人员的无代码可视化搜刮工具。没有唯一的赢家。我们在定价模式、JavaScript 渲染、反僵尸强度和理想用例等方面比较了 22 种以上的选择,这样您就可以筛选出两到三种,与您的实际目标网站进行比较。