跳至内容
免费开始
返回博客

用 Python 下载文件:实战手册

Gabriel Cioci最后更新于 4 min read
用 Python 下载文件:实战手册
要点速览: 本指南介绍如何用 Python 下载文件,从一行代码起步,一直到带身份验证、可断点续传、并行和异步的下载流水线。你将了解何时该用 urllib、requests、ThreadPoolExecutor 或 aiohttp,如何流式处理大文件、添加真正可用的 tqdm 进度条、带退避地重试,以及如何用校验和与 Content-Length 验证文件完整性。

如果你写过备份脚本、抓取过数据集,或者搭建过数据流水线,就会知道用 Python 下载文件这件事看似简单,一到生产环境就会暴露问题。两行代码的 urlretrieve 调用,在笔记本上下载一个 100 KB 的 CSV 毫无问题。可一旦你需要通过不稳定的 VPN 下载 5 GB 的压缩包、续传一个只完成一半的传输,或者在登录之后批量拉取上千张商品图片,它就撑不住了。

这篇文章是我第一次写需要连续运行一周的下载脚本时,最希望手边能有的那本手册。我们会从最简单的代码片段开始,然后逐步加入流式下载、进度条、断点续传、多线程、异步 I/O、身份验证、完整性校验和重试。每一节都是可以直接运行的示例,你可以把它粘贴到 Python 3.9 或更高版本的 virtualenv 中运行。

读完之后,你应该能够看到一个 URL 就预判它可能出现的故障,选出合适的工具,并复制一段能应对这些故障的代码。
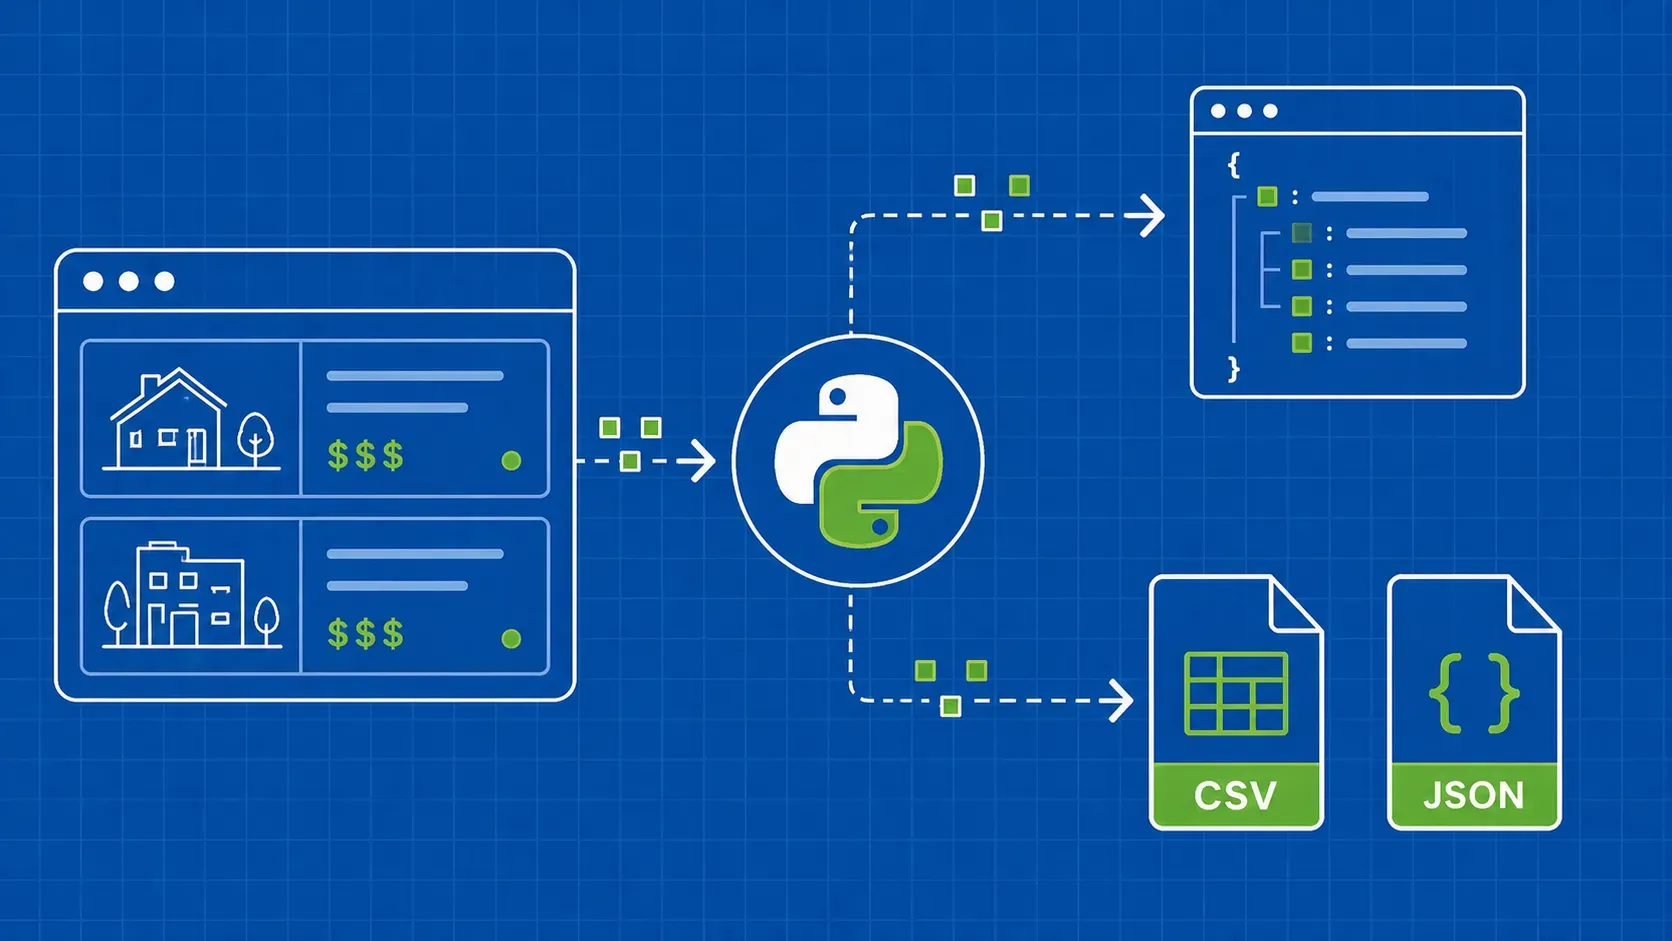
为什么要学习用 Python 下载文件(以及什么时候不该用)

curl 和 wget 非常适合临时下载。那为什么还要学习用 Python 下载文件呢?原因有三:可编程性、可移植性和可集成性。一旦下载逻辑写进 Python 脚本,你就可以把它和 pandas 串起来,加上重试逻辑,解析 Content-Disposition 头,把结果存进 S3,而且同一份代码无需改动一行,就能在 macOS、Linux 和 Windows 上运行。

Python 并不总是正确答案。如果只是在 shell 流水线里做一次性传输,curl --fail --retry 5 敲的字更少。如果要在两台服务器之间传输数百 GB 的数据,aria2c 或 rclone 能更高效地跑满带宽。当流水线的下一步同样用 Python 实现,或者“下载”实际上意味着“获取、校验、转换并分发”时,Python 才是更好的选择。

跟着本文操作,你需要 Python 3.9+、pip 和一个 virtualenv。requests、aiohttp 和 tqdm 会在用到时再安装。

最快的方法:用 urllib.request.urlretrieve() 一行代码完成下载

学习用 Python 下载文件,最快的方式是从标准库入手。每个 Python 安装都自带 urllib,所以不需要用 pip install 安装任何东西。它最高层的辅助函数是 urlretrieve,可以把一个 URL 直接复制到本地路径:

from urllib.request import urlretrieve

url = "https://example.com/reports/q3.csv"
filename, headers = urlretrieve(url, "q3.csv")
print(filename, headers["Content-Type"])

该函数返回一个 (filename, HTTPMessage) 元组。HTTPMessage 是一个类似字典的容器,存放响应头。如果你想查看 Content-Type、Content-Length 或 Last-Modified,又不想再发一次请求,它就很方便。

如果省略第二个参数,Python 会写入一个临时文件(在 Unix 上通常位于 /tmp/,在 Windows 上位于用户临时目录),并返回自动生成的路径。这在一次性脚本里很方便,在生产环境中却很危险,因为临时文件会在无法预测的时间被清理掉。

你需要了解的取舍:

  • 不支持流式下载。 urlretrieve 会先把整个响应体读进内存,再写入磁盘。文件一旦超过几百 MB,就会出问题。
  • 错误模型薄弱。 404 会抛出 urllib.error.HTTPError,但超时会以更宽泛的 URLError 形式出现,而且没有内置重试。
  • 无法复用会话。 每次调用都会新建一个 TCP 连接。

对于很小的一次性下载,urlretrieve 就够了。只要需求稍微复杂一些,你就应该改用 requests。

用 requests 库下载,获得更多控制

requests 是 Python 事实上的标准 HTTP 客户端,API 比 urllib 丰富得多。先安装一次:

pip install requests

最基本的下载模式只需三行:

import requests

resp = requests.get("https://example.com/files/sample.pdf", timeout=30)
resp.raise_for_status()
with open("sample.pdf", "wb") as f:
    f.write(resp.content)

这里有三点很重要。第一,始终传入 timeout,否则遇到响应缓慢的服务器,你的 worker 可能会无限期挂起。第二,raise_for_status() 会把任何 4xx 或 5xx 响应转换为异常,避免你在不知情的情况下把一个 HTML 错误页写到磁盘上。第三,resp.content 返回原始字节,处理任何二进制内容时你需要的正是它。只有当响应体是文本、并且你想用响应的字符集来解码时,才使用 resp.text。只有当服务器返回 JSON 时,才使用 resp.json()。

检查状态码、响应头和 Content-Type

在写入任何一个字节之前,先检查响应。200 表示成功,3xx 应该已经被 requests 自动跟随,而任何 4xx 或 5xx 要么是 bug,要么是暂时性故障。读取 resp.headers["Content-Type"],确认拿到的是你预期的 MIME 类型,再读取 resp.headers.get("Content-Length"),了解文件大小。如果存在 Content-Disposition 头,就解析它(使用 requests.utils.parse_header_links 或一个简单的正则表达式),取得服务器建议的文件名,而不是从 URL 路径去猜。

保存响应:文本、JSON、CSV 和二进制文件

写入模式要和内容类型匹配。模式不匹配是最常见的原因:下载下来的文件在十六进制转储里看起来一切正常,却怎么也打不开。

# Binary (PDF, ZIP, image, executable): always 'wb'
with open("report.pdf", "wb") as f:
    f.write(resp.content)

# Plain text: 'w' with an explicit encoding
with open("README.md", "w", encoding="utf-8") as f:
    f.write(resp.text)

# JSON: parse, then dump with indentation for diff-friendly storage
import json
with open("payload.json", "w", encoding="utf-8") as f:
    json.dump(resp.json(), f, indent=2, ensure_ascii=False)

# CSV from a remote URL: stream into the csv module
import csv, io
reader = csv.reader(io.StringIO(resp.text))
with open("rows.csv", "w", newline="", encoding="utf-8") as f:
    csv.writer(f).writerows(reader)

有两个编码陷阱需要注意。requests 会根据响应头猜测响应编码,而这个猜测有时是错的。如果看到乱码(mojibake),就在读取 resp.text 之前显式设置 resp.encoding = "utf-8"。另外,在 Windows 上打开文本文件时如果不加 newline="",CSV 文件会被损坏,因为 csv 模块本身已经会输出 \r\n 换行符。

用 requests 分块流式下载大文件

resp.content 会把整个响应加载进内存。对 200 KB 的 JSON 文档来说没问题,对几个 GB 的压缩包来说却是灾难。解决办法是开启流式模式并逐块迭代。这是在真实规模下用 Python 下载文件的主力模式:

import requests
from pathlib import Path

def download(url: str, dest: Path, chunk_size: int = 1024 * 64) -> Path:
    with requests.get(url, stream=True, timeout=(5, 30)) as resp:
        resp.raise_for_status()
        with dest.open("wb") as f:
            for chunk in resp.iter_content(chunk_size=chunk_size):
                if chunk:                # skip keep-alive empties
                    f.write(chunk)
    return dest

传入 stream=True 后有什么变化?requests 发出 GET 请求,只读取响应头,并保持连接打开。随后 iter_content 以 chunk_size 大小的缓冲区从 socket 中读取字节。无论文件多大,内存占用都保持平稳,而且你可以在数据到达时就开始处理,而不必等待全部内容下载完毕。

几点实用建议:

  • 块大小选在 32 KB 到 1 MB 之间。 太小的块(1 KB)会让 Python 层面的循环开销白白消耗 CPU,几 MB 的块则失去了流式下载的意义。64 KB 是稳妥的默认值,在高速链路上,256 KB 到 1 MB 会更快。
  • 使用上下文管理器。 with requests.get(...) 的写法可以保证即使写入循环抛出异常,底层连接也会被释放回连接池。
  • 不要混用 iter_content 和 resp.content。 流式读取之后再读 .content,会把剩余内容全部缓冲进内存,前面节省的内存就白费了。
  • 使用元组形式的超时。 (connect, read) 既能在主机宕机时快速失败,又能容忍传输缓慢的数据块。

如果不需要逐块处理,shutil.copyfileobj(resp.raw, f) 写起来更简洁,但你必须传入 stream=True,并先调用 resp.raw.read = functools.partial(resp.raw.read, decode_content=True),否则经过 gzip 编码的响应写到磁盘上时仍是压缩状态。正因如此,大多数团队还是坚持使用 iter_content。

用 tqdm 添加进度条

没有任何反馈的流式下载,即使在正常运行,看起来也像卡住了。tqdm 只需多写三行就能解决这个问题。诀窍是用服务器返回的 Content-Length 头确定进度条总长度,再按每个数据块的大小更新进度:

import requests
from tqdm import tqdm

def download_with_bar(url: str, dest: str) -> None:
    with requests.get(url, stream=True, timeout=(5, 30)) as resp:
        resp.raise_for_status()
        total = int(resp.headers.get("Content-Length", 0)) or None
        with open(dest, "wb") as f, tqdm(
            total=total, unit="B", unit_scale=True, unit_divisor=1024,
            desc=dest,
        ) as bar:
            for chunk in resp.iter_content(chunk_size=64 * 1024):
                f.write(chunk)
                bar.update(len(chunk))

有两个细节容易让人踩坑。第一,Content-Length 并不是必需的。使用分块传输编码(chunked transfer encoding)的服务器,或者会重新编码响应体的代理,经常不返回这个头。上面的 or None 会让 tqdm 显示一个不确定进度的指示器,而不是崩溃或一直显示 0%。第二,unit_divisor=1024 让进度条以 KiB 和 MiB 为单位显示。如果你更喜欢 SI 单位,可以去掉它。在锁定版本之前,请对照项目文档确认 tqdm 的确切关键字参数名,因为这些 kwargs 在不同版本之间有过变化。

用 HTTP Range 请求实现断点续传

断点续传是悄悄把业余脚本和生产级工具区分开来的功能。HTTP 规范定义了一种 Range 请求机制,允许客户端只请求从第 N 个字节开始的内容,而不是整个资源。如果服务器支持,它会返回 206 Partial Content 和所请求的片段。如果不支持,你会收到 200 和完整的响应体,这就意味着你需要从头开始。

import os, requests
from pathlib import Path

def download_resumable(url: str, dest: Path, chunk_size: int = 256 * 1024) -> Path:
    # Probe the server first
    head = requests.head(url, timeout=10, allow_redirects=True)
    head.raise_for_status()
    accepts_ranges = head.headers.get("Accept-Ranges", "").lower() == "bytes"
    total = int(head.headers.get("Content-Length", 0)) or None

    existing = dest.stat().st_size if dest.exists() else 0
    if total and existing == total:
        return dest                       # already complete
    if existing and not accepts_ranges:
        existing = 0                      # server cannot resume; restart
        dest.unlink(missing_ok=True)

    headers = {"Range": f"bytes={existing}-"} if existing else {}
    mode = "ab" if existing else "wb"

    with requests.get(url, headers=headers, stream=True, timeout=(5, 60)) as resp:
        if existing and resp.status_code != 206:
            raise RuntimeError("Server ignored Range header; restart from zero.")
        resp.raise_for_status()
        with dest.open(mode) as f:
            for chunk in resp.iter_content(chunk_size=chunk_size):
                f.write(chunk)
    return dest

续传时要以二进制追加模式("ab")打开文件,并确认服务器确实返回了 206,因为有些配置不当的 CDN 会忽略 Range 头,悄无声息地从头开始传输。每次尝试使用的续传 URL 必须逐字节一致:不同的查询字符串、重新签发的预签名 URL,或者被重定向的目标,都可能破坏幂等性。对于关键任务,请保存原始响应中最终文件的 ETag,并在续传时重新校验,以免服务器端的变化损坏你下载了一半的文件。

用 ThreadPoolExecutor 和 requests 并行下载

当你有一批 URL,而瓶颈在网络延迟而不是 CPU 时,多线程几乎可以白白带来提速。下载属于 I/O 密集型任务,线程几乎所有时间都阻塞在 socket 上等待数据。尽管 Python 有全局解释器锁(GIL),但其他线程恰好可以在这段空闲时间里运行,因此 ThreadPoolExecutor 搭配 requests 可以同时下载几十个文件。

from concurrent.futures import ThreadPoolExecutor, as_completed
import requests
from pathlib import Path

def fetch(url: str, out_dir: Path) -> Path:
    dest = out_dir / Path(url).name
    with requests.get(url, stream=True, timeout=(5, 30)) as r:
        r.raise_for_status()
        with dest.open("wb") as f:
            for chunk in r.iter_content(64 * 1024):
                f.write(chunk)
    return dest

def fetch_many(urls, out_dir, max_workers=8):
    out_dir.mkdir(parents=True, exist_ok=True)
    with ThreadPoolExecutor(max_workers=max_workers) as ex:
        futures = {ex.submit(fetch, u, out_dir): u for u in urls}
        for fut in as_completed(futures):
            try:
                yield fut.result()
            except Exception as e:
                print(f"[fail] {futures[fut]}: {e}")

max_workers 应根据目标服务器来调整,而不是根据你的 CPU 核心数。对大多数公共 API 来说,8 到 16 是合理的默认值。超过这个数量,很多服务器就会开始限流。如果每个文件都很小(小于约 50 KB),每次请求的固定开销会占主导,多线程带来的收益也会比预期少。

避开常见的多线程陷阱

大多数团队都会踩到三个坑。第一,两个线程写入同一路径会损坏文件,所以目标路径应基于 URL 的哈希值生成,而不只是文件名。第二,在线程之间共享同一个 requests.Session 以复用 TCP 连接,但绝不要共享同一个已打开的文件句柄。第三,重试逻辑应放在 worker 函数内部,而不是包在 executor.map 外面,这样单个不稳定的 URL 就不会拖垮整批任务。

用 aiohttp 和 asyncio 异步下载

线程可以轻松支撑几十个并发传输。一旦同时进行的连接超过大约 100 个,每个线程的内存占用和上下文切换开销就会开始拖累性能,这时就该改用 asyncio 加 aiohttp。aiohttp 构建在 asyncio 之上,使用单个事件循环和协作式协程,因此同时发起 500 个下载几乎不需要额外开销。

import asyncio, aiohttp
from pathlib import Path

async def fetch(session: aiohttp.ClientSession, url: str, out_dir: Path) -> Path:
    dest = out_dir / Path(url).name
    async with session.get(url, timeout=aiohttp.ClientTimeout(total=120)) as resp:
        resp.raise_for_status()
        with dest.open("wb") as f:
            async for chunk in resp.content.iter_chunked(64 * 1024):
                f.write(chunk)
    return dest

async def download_all(urls, out_dir: Path, concurrency: int = 32):
    out_dir.mkdir(parents=True, exist_ok=True)
    sem = asyncio.Semaphore(concurrency)
    connector = aiohttp.TCPConnector(limit=concurrency)
    async with aiohttp.ClientSession(connector=connector) as session:
        async def bound_fetch(u):
            async with sem:
                return await fetch(session, u, out_dir)
        return await asyncio.gather(*(bound_fetch(u) for u in urls),
                                    return_exceptions=True)

# asyncio.run(download_all(urls, Path("downloads")))

几条经验法则。整批任务复用同一个 ClientSession。为每个 URL 创建一个会话会泄漏连接、严重拖慢性能。把 asyncio.Semaphore 和 TCPConnector(limit=...) 搭配使用,让合理的并发上限同时在应用层和传输层生效。return_exceptions=True 可以让单个失败的 URL 以返回值的形式交回,而不是让整个 gather 崩溃。

异步什么时候才真正胜过线程?粗略来说:并发下载少于 50 个时,线程更简单,速度也一样快。在 50 到几百个之间,两种方式都可行,异步通常更省内存。再往上,异步就是唯一现实的选择。请根据你安装的 aiohttp 版本确认 iter_chunked 和超时参数的写法,因为两者在各个小版本之间都有变化。

现实中很多下载都需要身份验证。要正确地用 Python 从需要认证的端点下载文件,可以从三个层面来考虑:凭据如何附加到请求上,会话如何在多次请求之间保持,以及需要应对哪种令牌过期机制。

Bearer 令牌最简单。大多数现代 API 会给你一个令牌,并要求你在 Authorization 头中发送它:

import requests
session = requests.Session()
session.headers["Authorization"] = f"Bearer {os.environ['API_TOKEN']}"
session.headers["User-Agent"] = "my-downloader/1.0"
resp = session.get("https://api.example.com/exports/123/data.csv", stream=True, timeout=30)

HTTP Basic 认证一行代码就能搞定:requests.get(url, auth=("user", "password"))。凭据应从环境变量或密钥管理服务中读取,绝不要以字符串字面量的形式写进会提交到代码仓库的代码里。

基于 Cookie 的登录需要一个 Session 来记住登录响应设置的 Cookie。先用 POST 提交登录表单,再用同一个会话访问受保护的 URL:

session = requests.Session()
session.post(LOGIN_URL, data={"user": user, "pass": pw}, timeout=15)
resp = session.get(FILE_URL, stream=True, timeout=30)

预签名 URL(例如 AWS S3 或 Google Cloud Storage 生成的那种)把凭据编码在查询字符串里,并在固定时间窗口后过期(通常是 15 分钟到 1 小时)。要把它们当作临时凭据对待:在下载前一刻重新申请新的 URL,不要缓存,也绝不要写进日志,因为签名本身就授予了临时访问权限。如果你还需要通过代理访问或轮换 IP(这在需要登录的抓取场景中很常见),设置 session.proxies 即可。如果需要入门介绍,可以阅读我们关于在 requests 模块中使用代理服务器的详细指南。

校验下载结果:校验和、文件大小和 Content-Type

文件下载完成,并不等于文件下载正确。三项低成本的检查就能发现大多数损坏问题。

import hashlib

def sha256_of(path, chunk=1024 * 1024):
    h = hashlib.sha256()
    with open(path, "rb") as f:
        for buf in iter(lambda: f.read(chunk), b""):
            h.update(buf)
    return h.hexdigest()

# 1. Checksum match (gold standard if the publisher provides one)
assert sha256_of("data.zip") == published_sha256

# 2. Size match (fast sanity check against Content-Length)
declared = int(resp.headers["Content-Length"])
actual = Path("data.zip").stat().st_size
assert declared == actual, f"size mismatch: {declared} vs {actual}"

# 3. MIME or magic-number sniffing
import mimetypes, magic   # python-magic; pip install python-magic
assert magic.from_file("data.zip", mime=True) == "application/zip"

分层使用这些检查。Content-Length 可以发现被截断的传输,而且几乎没有成本,因为你通常本来就拿到了这个头。MIME 嗅探可以发现服务器以 200 状态码返回 HTML 错误页的情况,这在配置不当的 CDN 上出奇地常见。SHA-256 是唯一能发现传输过程中被篡改或磁盘静默损坏的检查。只要发布方随文件提供了校验和文件,这项检查就是必做的。

稳健的错误处理、超时和自动重试

生产环境中的下载需要基础代码片段所缺少的三样东西:明确的超时、带退避的自动重试,以及合理的异常模型。只要正确组装,requests 加上 urllib3 就能提供这一切:

import requests
from requests.adapters import HTTPAdapter
from urllib3.util.retry import Retry

def make_session() -> requests.Session:
    s = requests.Session()
    retry = Retry(
        total=5,
        connect=3,
        read=3,
        backoff_factor=1.5,                       # 0, 1.5, 3, 6, 12 seconds
        status_forcelist=(429, 500, 502, 503, 504),
        allowed_methods=frozenset(["GET", "HEAD"]),
        raise_on_status=False,
    )
    adapter = HTTPAdapter(max_retries=retry, pool_connections=20, pool_maxsize=20)
    s.mount("https://", adapter)
    s.mount("http://", adapter)
    return s

session = make_session()
try:
    resp = session.get(url, stream=True, timeout=(5, 60))
    resp.raise_for_status()
except requests.exceptions.SSLError as e:
    log.error("SSL handshake failed: %s", e)
except requests.exceptions.ConnectionError as e:    # DNS, refused, dropped
    log.error("network unreachable: %s", e)
except requests.exceptions.HTTPError as e:
    log.error("HTTP %s on %s", resp.status_code, url)

请对照你所安装版本的 urllib3.Retry 和 HTTPAdapter 文档确认参数名:allowed_methods 已取代旧的 method_whitelist,部分默认值也有调整。元组形式的超时 (connect, read) 是整段代码中投入产出比最高的一行:连接超时能在主机宕机时快速失败,读取超时则能防止服务器建立连接后迟迟不发送任何字节。

用 Python 下载文件:如何在 urllib、requests、aiohttp 和 wget 之间选择

对于“我该用哪个库”这个问题,诚实的回答是“取决于五个因素”。下面是我贴在便利贴上的决策矩阵:

场景

最佳工具

原因

单个文件、一次性脚本、不允许使用 pip

urllib.request.urlretrieve

标准库,无需安装,代码极简。

一个到几个文件,需要超时和重试

requests + Session + Retry

API 最简洁,生态成熟。

单个文件 >500 MB

requests 配合 stream=True + tqdm + Range 续传

内存占用恒定,传输可恢复。

10 到约 100 个 URL 并行

ThreadPoolExecutor + requests

I/O 密集型,线程足够,代码保持同步。

数百到数千个 URL 并行

aiohttp + asyncio

每个连接内存占用更低,尾部延迟更好。

需要认证、基于 Cookie、多步骤

requests.Session(或 aiohttp.ClientSession)

原生支持会话和 Cookie jar。

在 shell 流水线中调用

wget 或 curl,而不是 Python

如果 Python 不能带来额外价值,就别用它。

封装 wget 的 Python 包

python-wget

适合 CLI 风格的可续传下载,功能比 requests 少。

还有几条通用规则。把块大小固定在 32 KB 到 1 MB 之间,基本就不用再调整。始终设置 timeout。始终把 Content-Length 和实际写入的字节数进行比对。对同一主机的请求复用会话。另外,除非真的有数百个并发传输,否则不要急着上异步。线程更简单、更容易调试,而且几乎总是够快。

如果瓶颈不在库本身,而在于目标网站用验证码、IP 封禁或浏览器指纹识别进行反制,那么问题就不再是如何用 Python 下载文件了。你需要做的是通过住宅 IP 路由请求、轮换 User-Agent,并在调用 iter_content 之前先解除页面封锁。这是另一个问题,我们在专注于抓取的指南中有详细介绍。

关键要点

  • 对于很小的一次性文件,urllib.request.urlretrieve 一行代码即可,且没有任何依赖。其他情况都应使用 requests。
  • 大文件一律用 stream=True 加 iter_content 流式下载,块大小选在 32 KB 到 1 MB 之间,并将写入的字节数与 Content-Length 比对。
  • 断点续传需要 HTTP Range 头、二进制追加模式,并检查服务器是否真的返回了 206 Partial Content。
  • 对于 I/O 密集型并行任务,线程可以覆盖到约 100 个 URL,超过这个阈值,就改用 aiohttp 和 asyncio。
  • 生产环境的下载必须包含元组形式的 timeout、带退避的 urllib3 Retry,以及一项完整性检查(SHA-256、文件大小或 MIME)。

FAQ

如何在不安装任何第三方库的情况下用 Python 下载文件?

使用标准库中的 urllib.request。urlretrieve(url, path) 是最简短的写法,而 urlopen(url) 加上 shutil.copyfileobj 写入循环则是适合流式下载的等价方案。在受限环境、AWS Lambda layer 或短生命周期的容器中,这一点很重要,因为在那里引入 requests 要么大材小用,要么根本做不到。

如何在 Python 中续传下载了一部分的文件?

如果服务器不支持 Range 请求,严格意义上就无法续传。退而求其次的办法是分段下载:预先把文件切分成 N 个字节区间,每段分别下载到一个 .partN 文件中,待所有分段完成后再拼接起来。如果这也行不通,就保存原始的 ETag,只在它发生变化时才重新下载;否则保留已有的内容。

如何下载需要登录或 API 令牌的文件?

除了附加凭据之外,还要为令牌轮换做好准备。把认证头封装在一个可调用对象中,在收到 401 Unauthorized 时重新获取新令牌;把刷新令牌保存在操作系统的密钥链中,而不是普通文件里;如果使用 OAuth,请把令牌的 scope 限制在下载所需的最小范围内。对于长时间运行的批量任务,应在令牌过期前主动刷新,而不是等出错后再处理。

如何验证下载的文件没有损坏?

除了校验和之外,还要做针对文件格式的合理性检查。用 zipfile.ZipFile.testzip() 打开 ZIP 文件,用 json.loads 验证 JSON,用 pdfminer 或 pypdf 确认 PDF 具有可解析的 trailer。这些检查可以发现两类情况:字节虽然与参考校验和一致,但参考校验和本身就是错的;或者发布方悄悄重新上传了一个损坏的文件。

下载大文件应该用 requests、aiohttp 还是 wget?

“大”取决于数量,而不只是体积。对于单个大文件,带流式下载和 Range 续传的 requests 更胜一筹,因为它更容易调试。对于大量并行下载的大文件,aiohttp 能让内存占用保持平稳。只有当你明确需要 wget 的镜像模式或递归下载时,才值得从 Python 中调用它;否则就直接在 shell 脚本里调用 wget,省去子进程的开销。

总结与下一步

用好 Python 下载文件,关键在于让库与工作负载相匹配,并且不跳过那些枯燥的环节:超时、重试、完整性校验和断点续传。原型阶段从 urlretrieve 开始,一旦需要更多控制就换成 requests,超过几百 MB 的文件一律流式下载,只有在真正遇到并发问题时才使用 aiohttp。

一个不错的后续练习项目:编写一个小型 CLI,接收一组 URL,通过 ThreadPoolExecutor 分发下载任务,边下载边写入 SHA-256 清单,并在重启时根据清单续传。这一个脚本几乎能用到本指南的所有内容,并会成为你之后编写的每条下载流水线的骨架。

如果任务需要 HTTP/2、并行传输或断点续传,我们整理的 wget 替代工具对比比较了 curl、aria2、HTTPie 等同类工具。

如果阻碍下载的不是你自己的代码,而是验证码、激进的限流或地域限制,那么就到了托管式解封层体现价值的时候。WebScrapingAPI 的 Scraper API 通过单一端点处理代理轮换、反爬虫验证和重试,因此你可以保留本文中的 Python 下载模式,在需要时只替换请求获取这一层。选择真正能用的最轻量工具,然后随着流量和数据需求的增长,逐步增强稳健性。

关于作者

Gabriel Cioci, 全栈开发工程师 @ WebScrapingAPI

Gabriel Cioci

全栈开发工程师

加布里埃尔·乔奇(Gabriel Cioci)是 WebScrapingAPI 的全栈开发工程师,负责构建和维护该平台的网站、用户面板以及面向用户的核心功能模块。

开始构建

准备好扩展您的数据收集规模了吗?

加入2,000多家企业,使用WebScrapingAPI在无需任何基础设施开销的情况下,以企业级规模提取网络数据。