简而言之:若需简单的同步脚本,请选择 Requests;若需同时支持同步和异步接口(并可选配 HTTP/2),请选择 HTTPX;若需基于 asyncio 且具有显式连接控制的爬虫,请选择 aiohttp。 若需更底层的连接池和重试功能,可考虑使用 urllib3;若需模拟浏览器传输,可选用 curl_cffi;若需更广泛的 HTTP 协议支持,则可选用 Niquests。会话复用、并发限制以及对返回数据的检查,比单纯的速度排名更为重要。
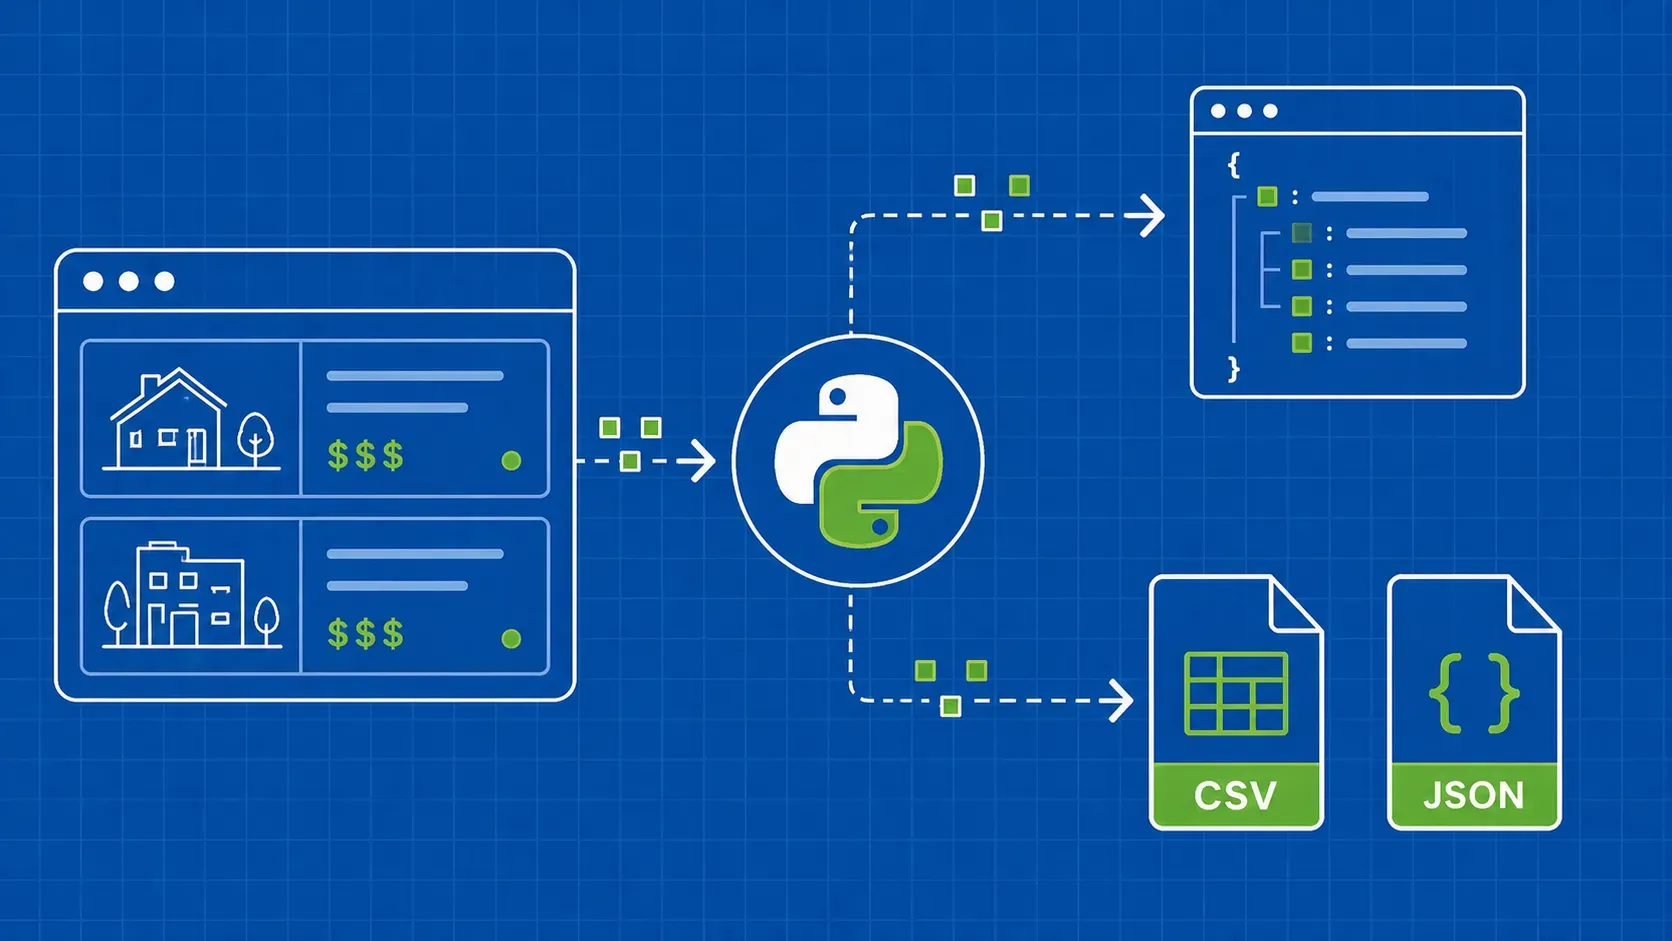
Python HTTP 客户端向服务器发送请求,并使您的代码能够访问响应状态、头部和正文。在网页抓取中,它负责数据获取环节;HTML 解析器负责提取字段,而当工作流依赖于执行 JavaScript 或与页面交互时,则需要使用浏览器。
最适合网络爬虫的 Python HTTP 客户端能解决不同的问题。一个小型定时脚本可能需要可读性强的代码和可靠的错误处理;而一个需要抓取大量独立页面的爬虫则可能需要异步请求和反压机制。如果目标网站使用较新的协议,可能需要采用不同的传输方式,但这种变更并不能自动解决数据缺失或请求被拒的问题。
本指南根据工作负载适配性对比了六种客户端,并演示了如何配置三种最常见的入门方案。示例代码从一个练习网站中提取页面标题,使用显式超时设置,并关闭会话。您还将了解到重试机制的适用场景、如何避免误导性基准测试来比较客户端,以及在何种情况下更换库并非正确的解决方案。
相关建议基于已记录的功能,并非声称某一个库在所有网站上都最快。请在部署前检查所选版本,并使用具有代表性的响应进行测试。