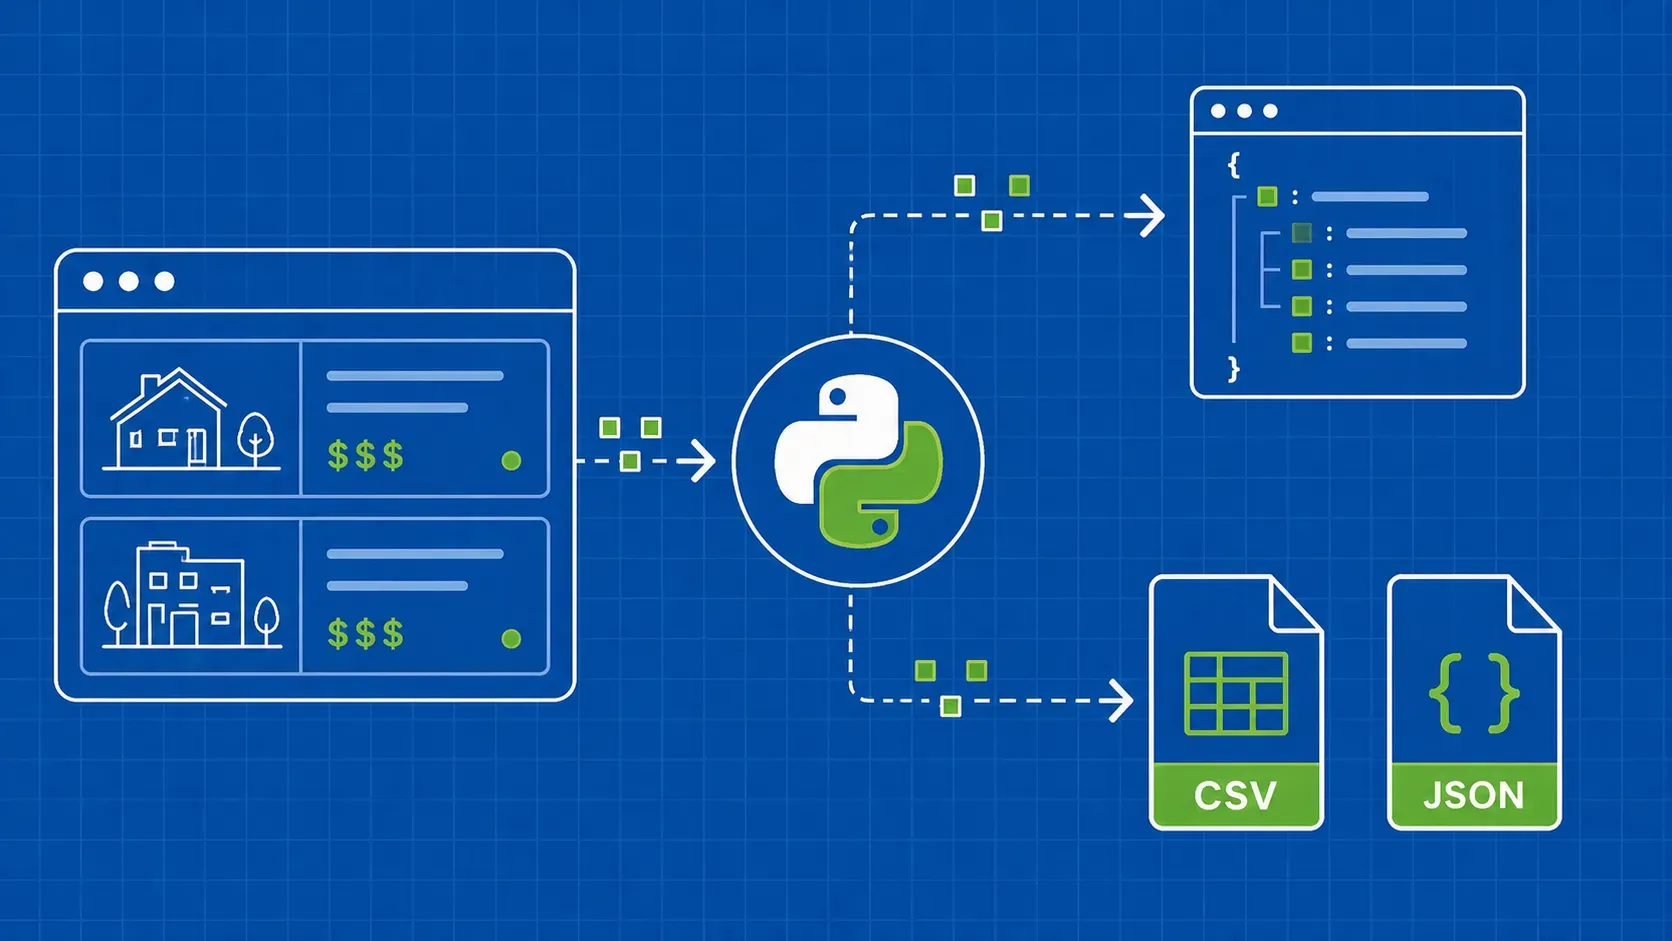
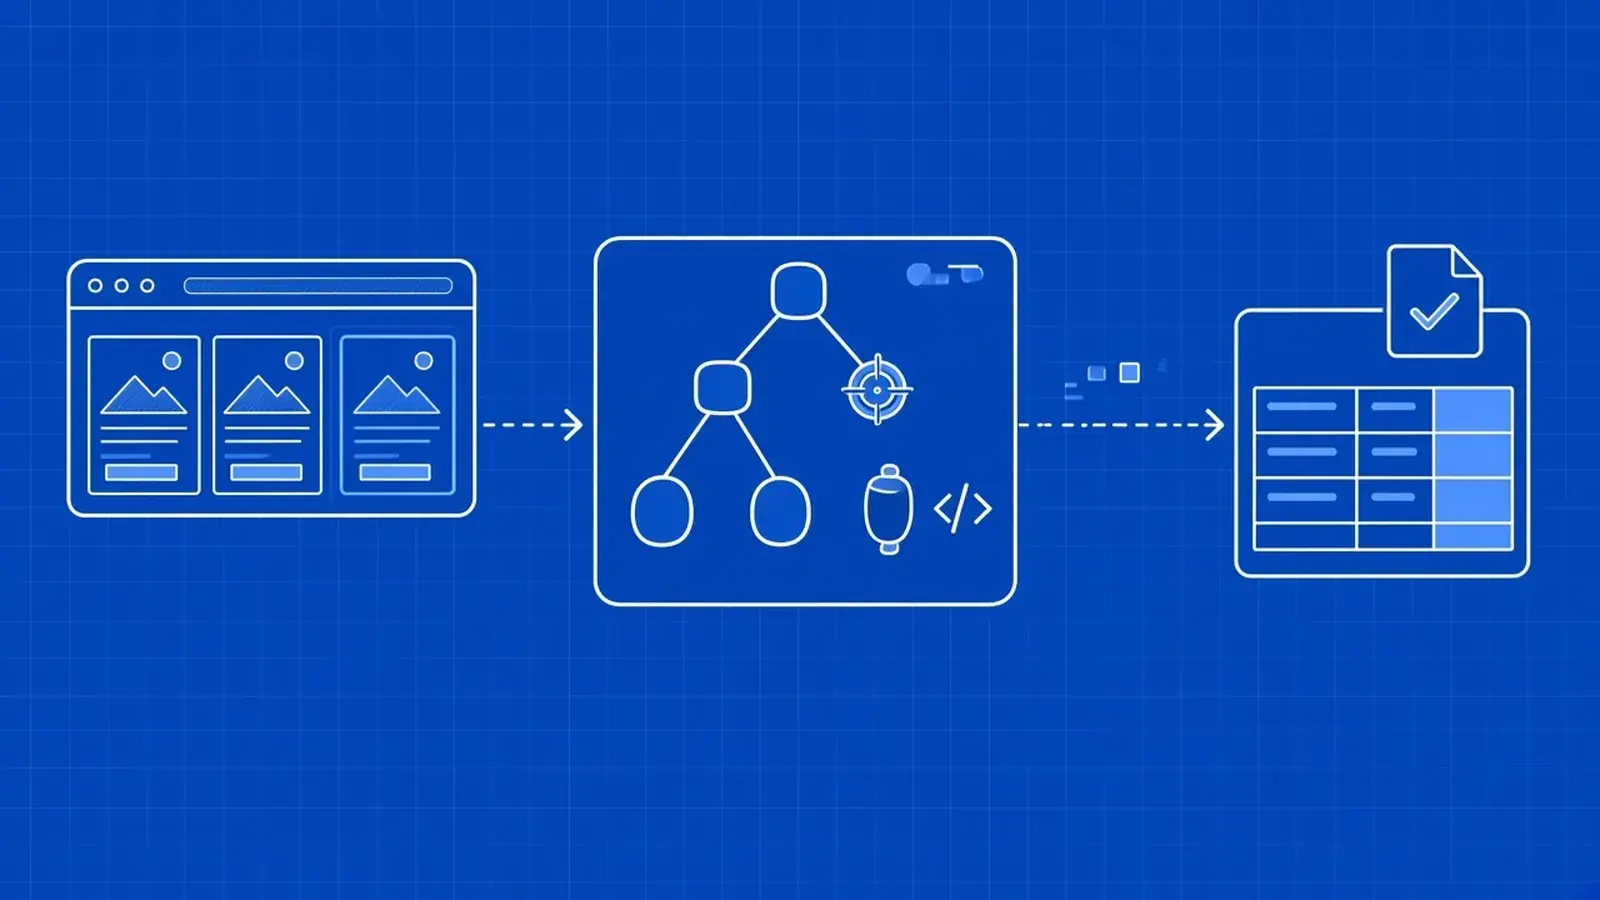
CSS 选择器是用于从 HTML 文档中筛选元素的模式,爬虫利用它们来定位需要提取的具体文本或属性。其中五种选择器承担了大部分工作: .class, [attribute]、后代和子元素组合符(空格和 >), :nth-child(),以及 :has()。这份 CSS 选择器速查表涵盖了所有这些选择器以及其余的标准语法,每项都配有相应的爬取示例。 此外,您还将看到一张矩阵,展示哪些选择器在浏览器、BeautifulSoup、Scrapy、Cheerio、Playwright 和 selectolax 中有效;同一提取任务在四种技术栈中的实现示例;常见页面模式的处理方案;以及针对返回空结果的选择器的修复方案表。
关键要点
- 大多数爬取任务仅需类名、属性名、空格以及
>组合符,:nth-child()以及:has(). :has()选择父元素。现代浏览器和主流抓取解析器均支持这些功能。- 标准 CSS 无法选择文本或属性值。
::text,::attr(),以及:-soup-contains()属于库扩展功能,而非 CSS 本身。 - 锚点位于
data-*基于属性及语义类,而非构建哈希类或冗长的复制链。 - 如果某个选择器在开发者工具中有效,但在您的爬虫中无效,那么该内容很可能是由 JavaScript 渲染的。