跳至内容
免费开始
返回博客

2026年最适合网络爬虫的代理:按任务类型和成本选择

Robert Munceanu最后更新于 5 min read
2026年最适合网络爬虫的代理:按任务类型和成本选择
简而言之:最适合网页抓取的代理,就是目标网站能接受的最便宜的代理。大规模抓取开放网站用数据中心代理;在需要登录或多步骤的流程中保持同一 IP 用 ISP 代理;应对更严格的网站和城市级定向用住宅代理;面向移动优先的目标用移动代理。先按任务选择代理类型,再按每次成功请求的成本而非每 GB 价格比较服务商。

最适合网络爬虫的代理,就是目标网站能接受的、价格最低的那种。数据中心代理适用于大规模抓取开放网站;ISP代理适用于需要登录或多步骤流程的场景;住宅代理能突破更严格的网站限制并实现城市级定向;移动代理则适用于“移动优先”的目标网站。请根据具体任务选择代理类型,然后比较每次成功请求的成本。

代理会转发您的爬虫请求,因此目标网站看到的是代理的 IP 地址,而不是您的 IP 地址。本指南面向已经拥有爬取任务,并需要确定代理类型、会话模式、计费模式以及供应商候选名单的工程和数据团队。 WebScrapingAPI 是下文列出的九种服务之一——也是我们的产品——因此我们也会指出它不适合哪些场景。

关键要点

  • 首先根据任务选择合适的代理类型;其次再比较各服务商。
  • 比较每次成功请求的成本,而不仅仅是每 GB 或每个 IP 的价格。
  • 轮换会话适用于独立页面抓取;粘性或静态 IP 则适用于多步骤流程。
  • 在投入带宽之前,请先在您自己的 URL 上测试可用内容。
  • 当封锁和浏览器验证问题成为主要障碍时,应将这些目标转移至解锁工具或爬虫API。

哪种代理最适合您的数据抓取任务?

应从目标和工作流程出发,而非品牌。该网站是否接受数据中心流量?任务是否需要在不同请求中使用同一IP?位置精度要求有多高?这些问题的答案将帮助您确定类型、会话模式和计费模式;随后筛选出提供此类配置的服务商。

爬取任务

从以下方面着手

会话模式

适合的计费方式

筛选

在以下情况下切换…

需要高流量访问公共页面(文档、产品目录、新闻、开放数据)

共享数据中心

轮换

按 GB 或按 IP 计费

Webshare、Decodo、Oxylabs

封禁率上升 → 住宅用户

根据城市或邮政编码变化的价格、库存或搜索结果

支持按州/城市/邮政编码定向的住宅IP

按位置轮换或固定

按 GB 计费

Bright Data、WebScrapingAPI、IPRoyal

您只需国家层级的结果 → 更经济的类型

屏蔽数据中心网络的网站(基于ASN的屏蔽)

住宅IP(或ISP IP,若您需要较少IP地址)

轮换

按 GB 计费

Bright Data、Oxylabs、Decodo —— 如需更深入的住宅代理方案对比,请参阅我们的轮换式住宅代理提供商排名

流量巨大,且该网站支持 ISP → ISP 模式

需要同一IP地址的登录、购物车或多页面流程

ISP(静态住宅)或专用数据中心

粘性或静态

按IP计费

Bright Data、Oxylabs、Rayobyte——若需固定代理池,请对比共享与专用代理提供商

该网站接受轮换式住宅代理,且粘性窗口较短

以移动端为主的网站和应用端点

移动端

具有可控轮换周期的粘性代理

按 GB 或按端口计费

Oxylabs、IPRoyal、Decodo——我们针对网络爬虫整理的最佳移动代理服务列表按服务商逐一列出(WebScrapingAPI 不提供移动代理服务)

桌面版 HTML 支持家庭网络

搜索引擎(Google、Bing)

支持按国家/城市定向的住宅代理或 ISP 代理,或 SERP API

轮换

按GB计费,或通过API按结果计费

Bright Data、Oxylabs、WebScrapingAPI

您需要大规模的结构化搜索结果页面(SERP)→ 搜索结果页面(SERP)API

安全防护严密的网站(JS 验证、验证码、指纹识别)

解锁工具、托管浏览器或爬取API

由服务商管理

按成功请求计费

Bright Data、Oxylabs、Decodo 解锁工具;WebScrapingAPI 爬虫 API

参见“当代理服务器不足以满足需求时”

小型任务、原型开发和学习

免费套餐或小型数据中心套餐

轮换

按 IP 计费或小额套餐

Webshare(免费套餐)、Oxylabs(5美元欢迎积分)、DataImpulse入门套餐

切勿将凭证或客户数据通过免费的公开列表进行处理

预算有限但需进行大规模爬取

优先使用数据中心,失败时回退至住宅网络(分层路由)

混合

混合

Decodo、Rayobyte、DataImpulse、Webshare

每次成功抓取的成本居高不下 → 在购买更多GB之前,先优化页面大小并调整重试策略

想先了解技术原理吗?我们的网页抓取代理类型指南涵盖了协议、IPv4 与 IPv6 的区别,以及每种类型的运作原理。

收集免费代理地址是另一项工作;请参阅我们对网页抓取免费代理列表及其限制的评测——我们不建议在生产环境中使用它们。

网络爬虫需要代理吗?

并非总是需要。向开放网站发送几百次“礼貌”请求时,通常一个 IP 地址就足够了。当网站对您的 IP 实施速率限制或封禁、内容因地理位置而异,或者请求量超过单个 IP 地址的处理能力时,您才需要代理——而当网站对浏览器进行身份验证时,仅靠代理往往还不够。

需注意:

  • HTTP 429 请求过多响应,尤其是带有 Retry-After 标头
  • 在连续成功请求后出现403响应
  • 验证码或“验证您是真人”页面(通常仍返回HTTP 200状态码)
  • 根据国家或城市而变化的内容、价格或可用性

网站根据 IP 信誉和 ASN、请求率以及浏览器和 TLS 指纹来分类自动化流量。OWASP 的自动化威胁目录中,抓取(OAT-011)是防御者需要关注的模式之一。 在某些目标上,数据中心IP范围很容易被识别,因为ASN易于标记,即使每个请求使用的是同一IP池中的不同IP地址。

数据中心、ISP、住宅或移动:您的工作需要哪种类型?

数据中心IP速度快且价格低廉,但容易被识别。ISP IP是注册在消费者ISP名下的静态地址。住宅IP来自家庭网络连接,通常会轮换。移动IP来自运营商网络。仅当目标要求时,才需为更高的可信度付费。

类型

目标方的视角

典型计费方式

适用场景

不擅长

数据中心

云或托管ASN

按IP或按GB计费

开放网站、流量大、成本低

屏蔽托管网络的网站

ISP(静态住宅IP)

部署在数据中心硬件上的消费者ISP ASN;ISP代理是托管在数据中心内的静态住宅IP

按IP计费

登录、购物车、长时粘性会话、美国私有IP池

最便宜的大批量爬取

住宅

家庭宽带IP,通常会轮换

按GB计费

安全级别更高的网站,支持按城市/邮政编码定向

轻量级HTML,海量数据(带宽费用累积)

移动

运营商4G/5G IP地址

按GB计费或按端口计费

以移动端为先的应用程序和网站

已打开页面的预算流量

轮询会话还是粘性会话:您的爬虫需要哪种?

轮换会话为每次请求分配一个新IP——适用于大规模独立页面抓取。粘性会话在设定时间内保持同一IP——适用于分页、购物车、登录,或任何网站将状态与您的IP绑定的流程。静态IP适用于长期会话。

工作流

会话模式

应向服务商提出哪些要求

独立的产品或文章页面

轮换

默认轮播行为;并发限制

分页、购物车、登录、多步骤结账

粘性

最大粘性持续时间;会话的键值方式;会话期间IP是否可以更改

长期账户或来自单一地址的监控

静态/专用

租期;白名单;带宽限制

在 WebScrapingAPI 的住宅代理中,国家、会话和轮换选项需包含在用户名中。一个粘性会话的示例如下:

username=<USER>+country=us+session=1+rotation=600

该模式可确保在文档中规定的粘性时长内保持同一住宅IP(产品页面说明粘性会话时长为3、5或10分钟;文档中规定的最大粘性时长为10分钟)。省略 session 和 rotation 。请参阅住宅代理设置文档了解各项选项详情,并查阅“网络爬虫中的IP轮换机制”了解其基本工作原理。

我们如何选择和比较这些代理提供商

此处列出的每家供应商均以自有品牌销售代理服务。 价格和功能信息均来自各供应商的公开页面。代理池规模和成功率未纳入考量:各供应商的衡量标准不一,且无法从外部进行验证。WebScrapingAPI 由我们运营。NetNut 未被纳入,因其域名已于 2026 年 7 月被美国当局查封。

网页抓取最佳代理服务商对比

服务商

最适合

类型(数据中心/ISP/住宅/移动)

住宅级入门

数据中心/ISP入门套餐

移动

计费单位

免费试用 / 信用额度 / 免费套餐

会话

定向

解锁工具或数据抓取API

WebScrapingAPI(我们的产品)

来自同一供应商的住宅IP + 爬取API

✓ / ✓ / ✓ / ✗

按量付费 $8.50/GB;月付套餐 8 GB 起 $52

报价

暂不销售

按 GB 计费(住宅);报价(数据中心/ISP)

数据抓取API试用(5,000次请求)——非代理试用

轮换、粘性

国家、州、城市、邮政编码(如有)及ASN

数据抓取API(Scraper、SERP、Browser、Crawl、Data)

Bright Data

涵盖所有四种类型的广泛产品目录

✓ / ✓ / ✓ / ✓

按量付费列表:8 美元/GB(页面上会显示促销折扣)

共享数据中心:1.40美元/IP起(10个IP);共享ISP:1.80美元/IP起(10个IP)

已售出

按 GB、按 IP 计费

“开始免费试用”;首次充值可获最高500美元等额返现

轮询、粘性、静态选项

国家、州、城市、邮政编码、ASN

是

Oxylabs

单一订阅涵盖多种代理类型 + 解锁功能

✓ / ✓ / ✓ / ✓

6 美元/GB 起(按等级递减)

按IP计费:1美元/IP起;按GB计费:0.60美元/GB起;专用数据中心:2美元/IP起;ISP:1.50美元/IP起

7.50 美元/GB 起

按GB计费、按IP计费;订阅费30美元/月起

5美元欢迎积分

轮询、粘性、静态

国家(以及更多按产品分类)

是

Decodo

自助式家庭套餐,提供小流量月费套餐

✓ / ✓ / ✓ / ✓

按量付费 4 美元/GB;月付套餐 3.75 美元/GB 起(3 GB)

共享数据中心:0.60 美元/GB 或 0.10 美元/IP;专用数据中心:2.50 美元/IP;互联网服务提供商:2 美元/IP 或 1.30 美元/GB

约2.25美元/GB起(促销图块可能显示更低价格)

按GB计费,按IP计费

免费试用按钮;数据中心页面注明14天退款保证

轮播、固定显示

按产品划分国家及更精细的地理位置

是

SOAX

住宅和移动流量均采用统一的按GB计费模式

— / — / ✓ / ✓

沙盒按量付费(无订阅费);月费200美元起

未在公开定价中列出

与住宅版采用相同计费模式

按GB计费(积分);另加增值税

Sandbox(非免费试用;需购买充值包)

固定和轮换

国家;高级套餐支持更精细的地理定位

—

IPRoyal

小型住宅套餐和简短的ISP测试

✓ / ✓ / ✓ / ✓

按量计费:7.35 美元/GB(1 GB);订阅制:7.00 美元/GB

DC 每代理 1.57 美元起(30 天);ISP 每代理 1.80 美元起(24 小时)

轮换服务:6.80 美元/GB(2 GB);专用端口:10.11 美元/天

按GB、按代理、按端口计费

未列出免费试用

轮换型、固定型

住宅IP的国家和城市

—

DataImpulse

公开的按量计费每GB费率最低

✓ / ✗ / ✓ / ✓

按量计费:1 美元/GB;新用户特惠:5 美元可享 5 GB

0.50美元/GB

2 美元/GB

按GB计费;流量永不过期

新用户5美元入门套餐

支持会话保持

包含国家定向功能

—

Rayobyte

多条产品线,包括住宅和数据中心

✓ / ✓ / ✓ / ✓

高级住宅级按量付费服务,每GB起价3.50美元

定价页面提供按IP和按GB计费的套餐

按月套餐销售

按GB计费、按IP计费

大部分产品提供免费试用;无需信用卡

轮换、固定

按产品划分的国家覆盖范围

数据抓取API/解锁类产品

Webshare

基于廉价DC的原型和开放目标

✓ / — / ✓ / —

静态和轮播住宅IP出售

10个代理免费;100个代理 2.99美元/月(0.0299美元/代理)

—

按代理计费;数据中心提供带宽分级

10个免费代理

提供轮换和静态选项

DC套餐包含多种国家组合

—

以上数据为各供应商定价页面上的美元标价。部分页面会加收增值税;Bright Data和Decodo还显示了临时优惠券——请以标价为准,而非折扣价。

网络爬虫领域9大最佳代理服务商评测

WebScrapingAPI(我们的产品)

WebScrapingAPI 提供住宅、数据中心和 ISP 代理,此外还提供 Scraper、SERP、Browser、Crawl 和 Data API——当仅靠原始代理已无法满足需求时,这些服务可满足希望从单一供应商获取全方位服务的团队需求。

按量付费的住宅代理价格为 8.50 美元/GB(上限 50 GB); 住宅代理套餐起价为每月 52 美元(8 GB),其中“Grow”套餐 150 美元(25 GB),“Business”套餐 280 美元(50 GB),“Pro”套餐 520 美元(100 GB)。 所有住宅套餐均包含无限并发会话、国家和城市定向、固定会话和轮换会话,以及高级支持;“Business”和“Pro”套餐额外提供专属客户经理。代理产品页面显示服务覆盖 195 个国家,并在条件允许的情况下支持州、市、邮政编码和 ASN 定向。 住宅端点支持 Host:port、HTTP、HTTPS 和 SOCKS5 输出,可通过凭据或 IP 白名单进行认证。

可在多步骤流程中测试 3、5 或 10 分钟的粘性会话时长,并在对地理位置敏感的页面上测试国家或城市定向功能。 请注意其公布的每GB住宅代理费率高于多家经济型供应商:不提供移动代理,数据中心和ISP代理仅限报价,且未公布免费代理试用(5,000次请求的试用仅适用于Scraper API)。

Bright Data

Bright Data 涵盖住宅、数据中心、ISP 和移动代理,并提供解锁工具和爬取产品。住宅按量付费套餐为 8 美元/GB;住宅月度套餐起价约为 499 美元(141 GB)。 共享数据中心套餐起始配置为 10 个 IP,价格为 1.40 美元/IP(14 美元/月);共享 ISP 套餐起始配置为 10 个 IP,价格为 1.80 美元/IP(18 美元/月)。 请以标价为准,而非临时折扣优惠券。页面上会出现“押金匹配”和“免费试用”按钮;请确认试用范围。请在价格页面查看城市/邮政编码的地理位置信息,并在“共享”与“专用”标签页中确认并发连接数。套餐倾向于要求更大规模的承诺;本地货币显示仅为估算值——美元价格具有法律约束力。

Oxylabs

在 Oxylabs,一个订阅即可覆盖住宅、移动、ISP、数据中心及解锁服务。入门订阅起价为 $30/月(可能需缴纳增值税),并附赠 $5 欢迎积分。 住宅流量起价为 6 美元/GB,随使用量增加而递减;移动流量为 7.50 美元/GB;数据中心提供按 IP 和按 GB 计费的选项;ISP 起价为 1.50 美元/IP。请确认您的目标网站未被列入其限制列表,并测量购物车流程中的用户停留时长。 入门级套餐的单位成本最高;随着使用量的增加,单价会相应降低。

Decodo

Decodo 提供自助式住宅服务,包含小额月度套餐和灵活的数据中心计费方式。 家庭用户按量付费为 4 美元/GB;月套餐起价为 3.75 美元/GB(3 GB 起),达到 100 GB 时降至 2.75 美元/GB。数据中心和 ISP 支持按 GB、按 IP 或专用 IP 计费。移动业务标价较低,且网站偶尔会有折扣。 价格均需另加增值税;数据中心页面注明提供14天退款保证。请将按需付费套餐与月度流量配额进行对比,并核对发票上的增值税金额;促销信息仅作临时参考。

SOAX

SOAX 将住宅和移动流量整合为统一的基于信用额度的按 GB 计费模式。Sandbox 无订阅费且不包含预付信用额——需购买充值额度进行测试。 月度套餐从“Builder”档(200美元/月 + 增值税)起,并可向上升级。每GB费率因套餐和出站国家而异,因此请先在Sandbox上查询您实际目标国家的价格;增值税和基于地理位置的费率会影响实际成本。

IPRoyal

IPRoyal 主要面向小型住宅套餐和短期 ISP 测试。住宅按量付费套餐起价为 7.35 美元/GB(1 GB 起,订阅价格略低)。流量描述为永不过期。数据中心套餐 30 天起价约为 1.57 美元/代理; ISP服务提供24小时套餐,起价为1.80美元/代理。移动流量按GB计费或以专用端口形式销售。建议在登录流程中尝试24小时ISP租赁,并在本地搜索结果页面上进行城市定向测试。若仅需短时突发流量,专用移动端口的费用会迅速攀升。

DataImpulse

DataImpulse 公布的按需付费每 GB 价格在此类服务中最低:住宅流量 1 美元/GB,入门套餐 5 美元可获 5 GB;数据中心流量 0.50 美元/GB;移动流量 2 美元/GB。流量永不过期。其公开定价页面上未列出 ISP 流量销售信息。 请根据您的核心目标来衡量实际成效——只有当页面加载无误时,低廉的每GB价格才有意义——并忽略供应商关于流量池和评级的主张。

Rayobyte

Rayobyte 在一个账户中提供多条住宅和数据中心产品线。高级住宅按量计费服务起价为 3.50 美元/GB,并随流量区间增加而递减。定价页面还列出了其他住宅和轮换产品线;在依赖任何大流量月费率之前,请仔细阅读套餐条款。 大多数产品均提供无需信用卡的免费试用。在具有代表性的URL集合上运行“高级住宅版”,并确认并发规则——名称相似的产品计费方式可能不同,因此请确保SKU与实际任务相匹配。

Webshare

Webshare 旨在为原型开发和公开目标提供基于低成本数据中心代理的服务。 “代理服务器”系列包含 10 个免费代理,付费套餐从 100 个代理起,价格为 2.99 美元/月(0.0299 美元/代理),带宽分级从 250 GB 起,高级套餐可享无限带宽。 静态和轮换式住宅代理位于不同的标签页中——请在实时定价页面上确认具体费率。请检查目标是否在您计划的并发量下接受数据中心 ASN。免费和廉价的数据中心代理池是共享的;对于防护严密的目标而言并不合适。

网络爬虫代理的实际成本是多少?

本指南中公布的按需付费住宅代理价格约为每 GB 1 至 8.50 美元;数据中心或 ISP IP 地址的月费通常在几美分到几美元之间。实际支出取决于页面大小、成功率和重试次数——请比较每次成功请求的成本。

计算公式:每 1,000 个成功页面成本 ≈ 每 GB 价格 × 每次尝试的平均传输量(GB)× 1.15(用于头部信息、TLS 和重定向的 15% 开销)× 每次成功所需的尝试次数 × 1,000。 每次成功所需的尝试次数为 1 ÷ 成功率,因为失败的尝试仍会占用带宽。

示例计算(页面大小和成功率仅供说明,WebScrapingAPI 的标价为 8.50 美元/GB):

  • 一个 100 KB 的 HTML 页面,有效成功率为 95%,每 1,000 个成功页面约需 $1.03。
  • 一个 2 MB 的渲染页面(已加载图片和字体),在 70% 的有效成功率下,每 1,000 个成功页面约需 $27.93——在每 GB 价格相同的情况下,成本大约高出 27 倍。

通常比寻找更低的每 GB 费率更划算:屏蔽图片和字体,获取页面背后的 JSON 或 HTML API,并在不需要时跳过完整的浏览器渲染。

按IP计费与按GB计费的盈亏平衡点:对于接受专用IP的网站,若存在大量轻量级请求,专用数据中心或ISP IP更具优势;而对于分布广泛且具有地域特性的请求,按GB计费的住宅IP更具优势。

需纳入预算的隐性成本

  • 部分月度套餐中的流量过期问题(DataImpulse 和 IPRoyal 宣称流量永不过期;请核实其他服务商)
  • 重试会成倍增加带宽消耗——请使用超时、重试和基于抖动的退避机制,而非严格的重试循环
  • 增值税
  • 最低承诺量
  • 轮换和封禁处理所需的工程时间
"""Estimate what a scraping proxy really costs per 1,000 successful pages."""


def cost_per_1k_per_gb(price_per_gb: float, avg_page_kb: float, success_rate: float,
                       overhead: float = 1.15) -> float:
    """Bandwidth-billed proxies (residential, mobile, some datacenter).

    avg_page_kb: average transfer per attempt, including assets you actually load.
    success_rate: share of attempts that return usable content (0-1).
    overhead: headers, TLS and redirects that the provider also bills (assumption).
    Failed attempts still consume traffic, so we divide by success_rate.
    """
    gb_per_attempt = avg_page_kb * overhead / 1_000_000
    attempts_per_success = 1 / success_rate
    return round(price_per_gb * gb_per_attempt * attempts_per_success * 1000, 4)


def cost_per_1k_per_ip(monthly_price_per_ip: float, ips: int,
                       successful_pages_per_month: int) -> float:
    """IP-billed proxies (dedicated datacenter or ISP): fixed monthly cost."""
    return round(monthly_price_per_ip * ips / successful_pages_per_month * 1000, 4)


if __name__ == "__main__":
    # Example inputs for illustration — not a vendor quote or benchmark.
    scenarios = [
        ("Light HTML page, easy target", 10.0, 80, 0.98),
        ("Same page, protected target", 10.0, 80, 0.60),
        ("Rendered page with assets", 10.0, 1500, 0.90),
    ]
    for name, price, kb, ok in scenarios:
        print(f"{name:32} ${cost_per_1k_per_gb(price, kb, ok):>8} per 1,000 successful pages")
    print(
        f"{'20 dedicated IPs, 400k pages/mo':32} "
        f"${cost_per_1k_per_ip(2.0, 20, 400_000):>8} per 1,000 successful pages"
    )

购买前如何测试代理服务商

针对每种目标类型选取50至200个真实URL,使用完全相同的设置通过每家入围的提供商进行测试,仅当所需内容存在时才计为成功。记录可用成功率、延迟和带宽,然后计算每1,000个可用页面的成本。

  1. 构建一个 targets.csv 包含以下列的表格 url,must_contain.
  2. 将 PROXY_URL 为该服务商的端点(若需通过直接连接进行模拟测试,请取消此设置)。
  3. 运行下面的测试框架。
  4. 在第二天以生产环境的并发量重复该操作。
  5. 将您的数据与提供商自身的使用量计数器进行对比。

快速连接性检查:

curl -x "$PROXY_URL" https://httpbin.org/ip

请参阅“使用 curl 配合代理”以及“六种实用的代理测试方法”(从 IP 检查到目标测试)。

200状态码并不代表成功:屏蔽页面通常会返回200状态码,但请求体中包含验证码(CAPTCHA)。HTTP语义标准(RFC 9110)描述了状态码在数据交换中的含义——而非HTML内容是否正是您所需要的。

以 WebScrapingAPI 的住宅代理为例 PROXY_URL 格式如下:

export PROXY_URL='http://username=<USER>+country=us:<PASS>@pr.webscrapingapi.com:7777'
"""Test a proxy endpoint on your own targets before you buy.

Usage:
  export PROXY_URL='http://user:pass@host:port'   # unset to test a direct connection
  python proxy_test.py targets.csv --workers 5 --price-per-gb 10

targets.csv columns: url,must_contain
"""
import argparse
import csv
import os
import statistics
import time
from concurrent.futures import ThreadPoolExecutor

import requests

BLOCK_MARKERS = ("captcha", "access denied", "verify you are human", "unusual traffic")
RETRY_STATUSES = {429, 500, 502, 503, 504}


def fetch(url: str, must_contain: str, proxy_url: str | None, max_retries: int = 2) -> dict:
    proxies = {"http": proxy_url, "https": proxy_url} if proxy_url else None
    attempts, total_bytes = 0, 0
    for attempt in range(max_retries + 1):
        attempts += 1
        start = time.perf_counter()
        try:
            r = requests.get(
                url,
                proxies=proxies,
                timeout=30,
                headers={"User-Agent": "Mozilla/5.0 (proxy-evaluation)"},
            )
        except requests.RequestException as exc:
            result = {"status": type(exc).__name__, "latency": None}
            if attempt < max_retries:
                time.sleep(2 ** attempt)
                continue
            break
        latency = time.perf_counter() - start
        body = r.text.lower()
        total_bytes += len(r.content) + sum(len(k) + len(v) for k, v in r.headers.items())
        blocked = any(m in body for m in BLOCK_MARKERS)
        usable = r.status_code == 200 and must_contain.lower() in body and not blocked
        result = {
            "status": r.status_code,
            "latency": latency,
            "usable": usable,
            "blocked": blocked,
        }
        if r.status_code == 407:  # bad proxy credentials: retrying won't help
            break
        if r.status_code in RETRY_STATUSES and attempt < max_retries:
            wait = r.headers.get("Retry-After")
            time.sleep(int(wait) if wait and wait.isdigit() else 2 ** attempt)
            continue
        break
    result.update({"url": url, "attempts": attempts, "bytes": total_bytes})
    result.setdefault("usable", False)
    return result


def main() -> None:
    ap = argparse.ArgumentParser()
    ap.add_argument("targets")
    ap.add_argument("--workers", type=int, default=5)
    ap.add_argument("--price-per-gb", type=float, default=0.0)
    args = ap.parse_args()
    proxy_url = os.environ.get("PROXY_URL")
    with open(args.targets, newline="") as f:
        rows = list(csv.DictReader(f))
    with ThreadPoolExecutor(max_workers=args.workers) as pool:
        results = list(pool.map(lambda r: fetch(r["url"], r["must_contain"], proxy_url), rows))

    usable = [r for r in results if r["usable"]]
    latencies = sorted(r["latency"] for r in usable if r["latency"])
    gb = sum(r["bytes"] for r in results) / 1_000_000_000
    for r in results:
        print(
            f'{str(r["status"]):>20}  usable={r["usable"]!s:5}  '
            f'attempts={r["attempts"]}  {r["url"]}'
        )
    print(f"\nUsable: {len(usable)}/{len(results)} ({len(usable) / len(results):.0%})")
    if latencies:
        p95 = latencies[min(len(latencies) - 1, int(len(latencies) * 0.95))]
        print(f"Latency p50 {statistics.median(latencies):.2f}s, p95 {p95:.2f}s")
    print(f"Measured transfer: {gb * 1000:.3f} MB (your provider's meter will read higher)")
    if args.price_per_gb and usable:
        print(f"Cost per 1,000 usable pages: ${args.price_per_gb * gb / len(usable) * 1000:.4f}")


if __name__ == "__main__":
    main()

示例 targets.csv:

url,must_contain
https://example.com/,Example Domain
https://httpbin.org/html,Herman Melville
https://books.toscrape.com/,Books to Scrape
https://httpbin.org/status/429,anything

您可能会遇到的代理错误及其含义

大多数代理失败可归入以下几类:身份验证(407)、访问受阻(403 或 CAPTCHA 页面)、速率限制(429)、上游故障(5xx)以及超时。每种情况都需要不同的解决方法;其中只有部分情况应进行重试。

代码

通常表示

解决方法

需要重试吗?

407 需要代理身份验证

代理凭据错误,或 IP 地址未列入白名单

修正凭据或白名单

否

403

目标拒绝了此 IP 或指纹

轮换代理,或切换至安全性更高的代理类型

在进行某些更改后

429

速率限制

请降低请求频率并遵守 Retry-After 规则

是的,并采用退避策略

5xx(502/504)

上游或代理服务器故障

带退避机制重试

是

超时

并发量过大,或位置较远

降低并发数;检查地理位置设置

是,但次数有限

我们的《代理状态错误诊断指南》将逐一分析每个失败的跳点。

如何核查住宅和移动IP的来源

询问服务商如何获取IP地址、设备所有者是否同意且获得报酬、如何选择退出,以及服务商如何筛选客户。优先选择公开披露相关信息的提供商。来自遭入侵或用户不知情的设备的IP地址会带来道德和法律风险。

检查清单:

  1. 获取模式——SDK、应用合作还是ISP合同?
  2. 同意与退出机制——设备所有者能否退出,具体如何操作?
  3. 补偿——设备所有者是否因提供带宽而获得报酬?
  4. 客户身份验证(KYC)及禁止用途——他们会拒绝哪些情况?
  5. 转售——该网络是否转售其他提供商的IP地址?
  6. 滥用处理——如何调查投诉?

谷歌2026年7月的网络中断报告说明了为何这种尽职调查至关重要:基于被入侵设备构建的住宅网络曾被用于掩盖攻击,且部分品牌会转售其他网络的带宽——这属于行业普遍风险,并非针对此处列出的任何服务商的具体指控。

当代理服务器不够用时:解锁工具与数据抓取API

当解锁、验证码和浏览器指纹识别所耗时间超过数据采集时间时,请将这些目标转移至解锁工具或爬取API。您按成功请求次数付费,而非按GB计费;服务商将负责IP轮换、重试和页面渲染。 对于已能正常访问的目标,仍可保留普通代理。我们在《最佳网页抓取API指南》中对各类选项进行了对比分析。

选项

由谁处理轮换、重试和渲染

典型计费方式

最适合

原始代理

您

按GB计费或按IP计费

已支持该代理类型的目标

Unblocker风格的代理端点

提供商

通常按成功请求次数或高级服务每GB计费

无需重写客户端即可访问的难度较高的网站

数据抓取API

提供商

按成功请求计费

结构化提取和大量使用JS的页面

托管浏览器

提供商

按会话或计算时间计费

由您掌控的完整浏览器工作流

已购买的数据集

供应商

按数据集或订阅计费

当您需要数据而非爬取服务时

Bright Data、Oxylabs 和 Decodo 销售解锁工具;Zyte 等公司则销售爬取 API。而我们的 Scraper API 会为您自动处理 IP 轮换、页面渲染和重试。我们制定的“避免被封的爬取指南”涵盖了每一层防御机制。

使用代理进行网页抓取是否合法?

在大多数国家,使用代理是合法的。关键在于您收集的内容以及收集的方式。 请抓取公开数据,遵守网站条款和《机器人排除协议》(RFC 9309),不要绕过登录或访问控制,按照适用法律处理个人数据,并从经同意获取 IP 地址的供应商处购买服务。本文不构成法律建议——请查阅您所在司法管辖区的相关法规。

常见问题

哪些代理最适合网络爬虫?

就是目标网站能接受的、价格最低的那种:针对大量公开网站使用数据中心代理;针对需要登录或多步骤流程的网站使用 ISP 代理;针对要求更严格或具有地域限制的目标网站使用住宅代理;针对移动优先网站使用移动代理。然后在您的 URL 上测试入围的供应商。

哪种代理类型最适合网页抓取?

没有哪一种是放之四海皆准的最佳选择。建议从数据中心代理开始(速度快且价格低);当网站屏蔽数据中心网络或您需要城市级定位时,转用住宅代理;当必须保持一个稳定 IP 时,使用 ISP 代理;仅在目标网站最信任运营商网络时才使用移动代理。

在数据抓取方面,住宅代理比数据中心代理更好吗?

住宅IP属于家庭网络连接,因此更难被封锁,但成本更高,且通常按每千兆字节计费。数据中心代理速度更快、价格更低,尽管有些网站会直接封锁这类网络。在适用情况下,请使用数据中心代理。

进行网页抓取时,应该使用轮换代理还是粘性代理?

对于大规模独立页面抓取,请使用轮换代理(每次请求一个新 IP);对于分页、购物车、登录或网站将状态与您的 IP 绑定的操作流程,请使用粘性会话(一个 IP 维持固定时间)。请先确认各提供商的最大粘性时长。

网络爬虫代理的费用是多少?

按需付费的入门价格约为每GB 1 至 8.50 美元(住宅IP),而每个数据中心或 ISP IP 的月费则从几美分到几美元不等。页面大小、成功率和重试次数决定了实际成本——请比较每 1,000 个成功抓取页面的成本。

网络爬虫需要多少个代理?

请根据每个目标的请求速率(而非总流量)来确定代理池规模:估算单个 IP 在触发速率限制前每分钟可发送的请求数,然后将目标请求速率除以该数值。轮换式住宅网关会自动处理此问题;若使用专用数据中心或 ISP IP,则需自行确定代理池规模。

免费代理用于网络爬虫安全吗?

不安全。免费的公共代理通常速度慢、寿命短、已被封锁,或者由身份不明的运营商管理,这些运营商可能查看或篡改未加密的流量。用于学习尚可;但切勿通过它们发送凭据或客户数据。生产环境需要使用付费服务商,且该服务商应具备清晰的来源、技术支持及服务条款。

网络爬虫需要匿名代理还是精英代理?

是的。透明代理会在请求头中暴露您的真实 IP 地址。匿名代理和精英(高匿名性)代理则能隐藏真实 IP;精英代理还能避免暴露正在使用代理的事实。商用爬虫代理通常属于精英代理——测试时请检查一次请求头。

抓取谷歌的最佳代理有哪些?

搜索引擎会严格限制请求频率,且搜索结果会因地理位置而异,因此请使用支持国家/城市定向的住宅代理或 ISP 代理,保持低请求频率,并轮换代理。对于大量查询或结构化结果,使用 SERP API 通常每条成功结果的成本更低。

如何判断住宅代理提供商是否符合道德规范?

询问其获取 IP 的方式、设备所有者是否给予知情同意且可选择退出、是否获得补偿,以及如何审核客户。优先选择公开披露这些信息的提供商。在撰写本文时,针对与被入侵设备相关的住宅网络采取的公开行动,使得来源审核成为您自身风险评估的一部分。

何时应使用爬取 API 代替代理?

当屏蔽、验证码和指纹识别所耗费的工程时间超过数据采集所需时间,或者您需要大规模进行 JavaScript 渲染时,应切换至抓取 API。抓取 API 会自动处理地址轮换、重试和渲染,按每次成功请求计费。对于已正常运行的场景,请继续使用普通代理。

使用代理进行网页抓取是否合法?

在大多数国家,是合法的。关键在于您收集的数据及其获取方式:请仅收集公开数据,遵守网站条款和robots.txt规定,不要绕过登录或访问控制,并依法处理个人数据。本文不构成法律建议;请查阅您所在司法管辖区的相关法规。

根据任务选择,再验证成本

从爬取任务出发,而非品牌列表。选择目标网站可接受的最低成本代理类型,比较每次成功请求的成本,并在购买大额套餐前进行内容级测试。

需要住宅代理,还是准备将难以抓取的目标交由 API 处理?请查看 WebScrapingAPI 的住宅代理套餐,或免费试用 Scraper API(附带 5,000 次请求额度)。

关于作者

Robert Munceanu, 全栈开发工程师 @ WebScrapingAPI

Robert Munceanu

全栈开发工程师

罗伯特·蒙塞阿努(Robert Munceanu)是 WebScrapingAPI 的全栈开发工程师,他在产品各领域均有贡献,并协助构建了支持该平台的可靠工具和功能。

Nodriver Python 教程:隐身浏览器爬取——从第一个脚本到投入生产
网络爬虫技术

Nodriver Python 教程:隐身浏览器爬取——从第一个脚本到投入生产

TL;DR: 简而言之:Nodriver 是一个异步 Python 库,通过 Chrome DevTools Protocol 驱动 Chromium,无需 Selenium 或 chromedriver 二进制文件。当一个更接近真实 Chrome 会话的自托管隐身浏览器比 WebDriver 技术栈更合适时,请使用它;但要知道,它本身并不能消除 IP、TLS 或行为层面的风险。本教程从第一个脚本讲到容器化生产部署以及托管的 Browser API。

Suciu Dan5 min read
阅读文章
如何在搜索结果页面(SERP)抓取工具中处理 Google /goto 重定向 URL 和 CAES 令牌
网络爬虫技术

如何在搜索结果页面(SERP)抓取工具中处理 Google /goto 重定向 URL 和 CAES 令牌

TL;DR: Google 搜索会在搜索结果页面(SERP)中的结果与目标页面之间插入一个不透明的重定向。href 属性中可能不会直接显示 URL,而是显示包含 CAES 令牌的 google.com/goto——或者较旧的 /url 包装形式。了解如何在生产环境的 SERP 抓取工具中,无需解密 CAES 即可对这些重定向进行分类、去重和解析。

Suciu Dan4 min read
阅读文章
cURL 中的 HTTP 响应头:每个标记、技巧和脚本配方
网络爬虫技术

cURL 中的 HTTP 响应头:每个标记、技巧和脚本配方

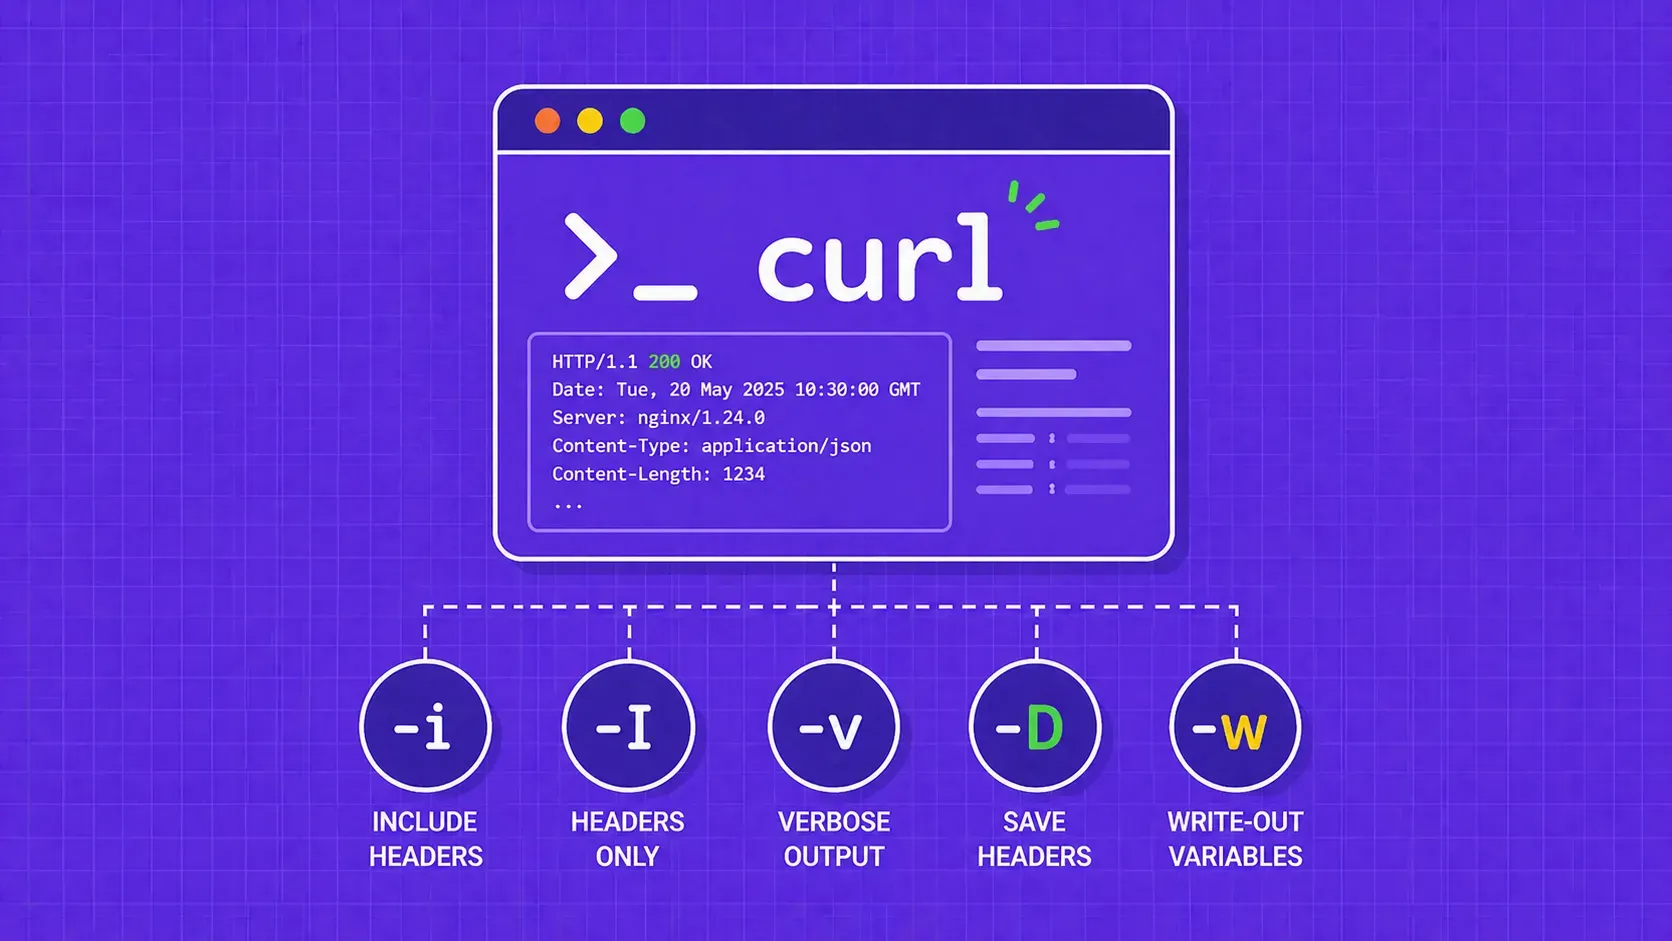
TL;DR: 简要说明:cURL 默认隐藏响应头信息。使用 -i 可以看到响应头和正文,使用 -I 可以看到 HEAD 请求只返回响应头,使用 -v 可以看到完整的请求/响应调试,使用 -D 可以将响应头保存到文件中。对于现代脚本,cURL 7.83+ 允许提取单个头信息,或使用 -w write-out 选项将所有头信息转存为 JSON 格式。

Suciu Dan3 min read
阅读文章

开始构建

准备好扩展您的数据收集规模了吗?

加入2,000多家企业,使用WebScrapingAPI在无需任何基础设施开销的情况下,以企业级规模提取网络数据。