跳至内容
免费开始
返回博客

如何在搜索结果页面(SERP)抓取工具中处理 Google /goto 重定向 URL 和 CAES 令牌

Suciu Dan最后更新于 4 min read
如何在搜索结果页面(SERP)抓取工具中处理 Google /goto 重定向 URL 和 CAES 令牌
简而言之:带 CAES 令牌的 Google /goto URL 以及较旧的 /url 包装链接都是重定向层,而非目标地址;如果 SERP 爬虫把每个 href 都当作最终链接,排名跟踪和链接存储就会出错。如果结构化 SERP API 能返回目标链接,请优先使用。必须解析 HTML 时,请对每个 href 分类、对重定向去重,并用普通 GET 请求解析。不要解密 CAES。

谷歌搜索会在搜索结果页面(SERP)中的某个结果与目标页面之间插入一个不透明的重定向。而不是 https://example.com/page 在 href,您可能会看到 https://www.google.com/goto?url=CAES...——或者一个较旧的 /url 包装器,其中包含同类令牌。对用户而言,点击后仍会跳转到正确的网站。但对于将每个 href 都视为最终目标的爬虫而言,这会破坏排名追踪、外链存储以及下游爬取。

这是一条生产环境的URL管道,而非密码学技术文档。若Google搜索结果页面(SERP)API能返回目标链接,请优先使用该API。当必须解析HTML时,请对每个 href、去重重定向、使用纯文本 GET,并记录错误。切勿解密 CAES.
关键要点

  • 将 /goto?url=CAES... 和 /url?... 视为重定向层,而非目标。
  • 请勿解密 CAES。使用 GET 和 allow_redirects=False,然后读取 Location.
  • 优先路径 A:WebScrapingAPI SERP API 结构化 JSON(当自然 link 字段为目标时。
  • 仅当需要原始标记时才使用路径 B:Scraper API 或 Browser API(仅 HTML)——随后进行分类 → 去重 → 解析。
  • HTTP 200 无法作为有效的搜索结果页面(SERP)使用。在解析前请验证结果容器。
  • 对同一页面内的相同 /goto 令牌;复用连接;限制并发量。
  • 将请求指纹(查询、 gl, hl, device域名、时间)作为指纹。
  • Google 的链接格式并非一成不变。设计时应考虑直接 URL, /goto,以及 /url.

Google /goto 是什么(以及它与 /url )

/goto 是什么(以及它与 /url)

从历史上看,爬虫通常直接从自然搜索锚文本中读取目标地址。如今,同样的概念结果可以以多种形式呈现:

形式

示例模式

如何处理

直接目标地址

https://example.com/page

原样使用

/goto + CAES

https://www.google.com/goto?url=CAES...

通过以下方式解决 GET → Location

/url 包装器

https://www.google.com/url?...&url=CAES... 或旧版 url= / q= 变体

分别分类;仔细解析或处理参数

其他 Google 主机/路径

地图、账户、Chrome 内部

忽略或通过有机管道外部进行处理

/goto 是 Google 托管的重定向端点。该 url 查询值通常以 CAES——这并非因为“CAES”是产品名称,而是因为这是二进制封套经过 Base64URL 编码后的常见形式。打开该链接会请求 Google 重定向至实际目标地址。

/url 是一个较旧的(但仍可见)Google重定向路径。据称,部分客户端会收到 /url 包含 CAES 有效载荷,而非明文目标地址。无论哪种情况,抓取规则均相同:先对链接进行分类,然后保留直接目标地址或解析封装层。切勿假设不透明令牌仅出现在 /goto.

Google 曾将重定向层描述为应对搜索滥用行为演变的技术措施之一。具体的部署逻辑并非公开规范。请针对多种格式进行开发。

你真的需要抓取 HTML 吗?

大多数生产环境中的排名追踪和搜索结果页面(SERP)监控任务需要目标 URL + 标题 + 摘要 + 排名,而非 Google 的展示 HTML。请先确定产品路径。

方案 A — SERP API(当目标 URL 为 JSON 格式时推荐)

向 WebScrapingAPI 的 SERP 端点发送一个基于上下文的 Google 查询,并读取已解析的集合:

  • 端点: https://serpapi.webscrapingapi.com/v2
  • 必填项: api_key, engine=google, q
  • 常见的可选控制选项: device, domain, uule, hl, gl, start, num, tbm, ibp
  • 异步替代方案: engine=google_async,然后通过快照 API 检索

产品页面:SERP API · Google 搜索 API
文档:访问 API · Google 搜索引擎

当前公开文档显示的内容:自然搜索结果示例中使用了 link 类似最终目标 URL 的字段(例如 https://www.history.com/ 或 https://en.wikipedia.org/wiki/History),而非 google.com/goto 包装符。字段文档中将 link 为目标 URL。

请在您的实际响应中检查 link 字段:

  • 在仅依赖路径 A 之前,请检查您账户中 link 值。
  • 公开文档中展示了类似目标页面的 link 示例;您的实时生产响应是否将任何结果包裹在 /goto ,只有您自己的样本才能给出答案——请勿仅凭本文内容做出任何假设。

另请注意文档架构中的双重命名:某些页面显示的是 organic 数组 (link, display_link, rank),而自然搜索结果文档中则显示为 organic_results (link, displayed_link, position)。两者都将 link 作为目标。请对这两种结构都进行保守解析,并根据实际响应进行验证。

路径 B — 爬虫 API / 浏览器 API HTML(当必须解析页面时)

当需要自定义选择器、布局分析,或结构化搜索结果页面(SERP)引擎无法覆盖的工作流时,请使用 HTML:

  • 抓取 API: https://api.webscrapingapi.com/v2 使用 api_key + url
  • Set render_js=1 当目标页面需要在接收正文之前执行客户端 JavaScript 时
  • 浏览器 API:当您需要文档中记录的等待操作、交互操作或浏览器状态控制时

验证可用的搜索结果页面(SERP)。HTTP 200 仍可能是插页广告、同意墙、验证码或“启用 JavaScript”的空壳页面。在提取链接之前,请确认存在可识别的结果容器(例如位于 #rso / #search,或您维护的等效标记)。若验证失败,请尝试渲染、调整区域设置/设备上下文,或回退至路径 A——切勿默认存储空排名结果。

从 HTML 中提取 /goto URL后,请通过纯HTTP解析它们(见下文)。通常,每个自然搜索链接无需额外消耗一次渲染抓取配额。

如何解析 /goto (尽早编码)

/goto (尽早编码)

解析是路径 B 的核心——也是当结构化输出中出现任何包装器时的安全网。

import requests

def resolve_google_goto(url: str, timeout: float = 10.0) -> str:
    """Resolve a Google /goto (or similar) redirect without following to the destination site."""
    response = requests.get(
        url,
        allow_redirects=False,
        timeout=timeout,
        headers={"User-Agent": "Mozilla/5.0"},
    )
    if response.status_code != 302:
        raise RuntimeError(f"Expected 302, got {response.status_code} for {url[:80]}...")
    location = response.headers.get("Location")
    if not location:
        raise RuntimeError("Redirect response has no Location header")
    return location  # keep full value, including #:~:text= fragments when present

生产环境中需注意的规则:

  1. allow_redirects=False — 您需要的是 Google 的 Location,而非跳转到发布商。
  2. 优先使用 GET 而非 HEAD。公开的分析报告指出, HEAD 可能会返回 200 不带 Location ,而 GET 返回 302 会返回目标地址。请将此视为行业指导;在将该方法硬编码之前,请通过您自己的管道确认 HEAD 与 GET 的行为 /goto 令牌的行为,再将方法硬编码。
  3. 保持 Location 保持原样。Google 可能会返回诸如 #:~:text=...。仅当您的产品明确需要规范 URL 时才进行过滤。
  4. 当令牌可移植时,请在抓取 API 之外进行解析——通过 Scraper/Browser HTML 收集,并使用常规客户端会话进行解析。

最简 cURL 模式:

curl -sS -o /dev/null -D - \
  "https://www.google.com/goto?url=CAES..." \
  | grep -i '^location:'

若仅需重定向目标,请勿使用 -L 。

将每个 href

href

切勿仅围绕子字符串构建解析器 CAES 。应先对绝对 URL 进行分类:

from urllib.parse import parse_qs, urljoin, urlparse

GOOGLE_BASE_URL = "https://www.google.com/"

def is_google_host(host: str) -> bool:
    host = (host or "").lower()
    return host == "google.com" or host.endswith(".google.com")

def classify_google_link(href: str) -> tuple[str, str]:
    absolute = urljoin(GOOGLE_BASE_URL, href)
    parsed = urlparse(absolute)
    host = parsed.hostname or ""

    if is_google_host(host) and parsed.path == "/goto":
        token = parse_qs(parsed.query).get("url", [""])[0]
        if token.startswith("CAES"):
            return "goto", absolute
        return "goto", absolute  # still a /goto wrapper even if token shape changes

    if is_google_host(host) and parsed.path == "/url":
        return "google_url", absolute

    if parsed.scheme in {"http", "https"} and not is_google_host(host):
        return "direct", absolute

    return "other", absolute

建议处理方式:

类型

操作

direct

保留

goto

去重 → 解析 → 保留 Location

google_url

解析已知的查询键;不要假设是明文

other

从自然流量来源中剔除(或路由至单独的处理程序)

生产管道:去重、并发、错误、指纹

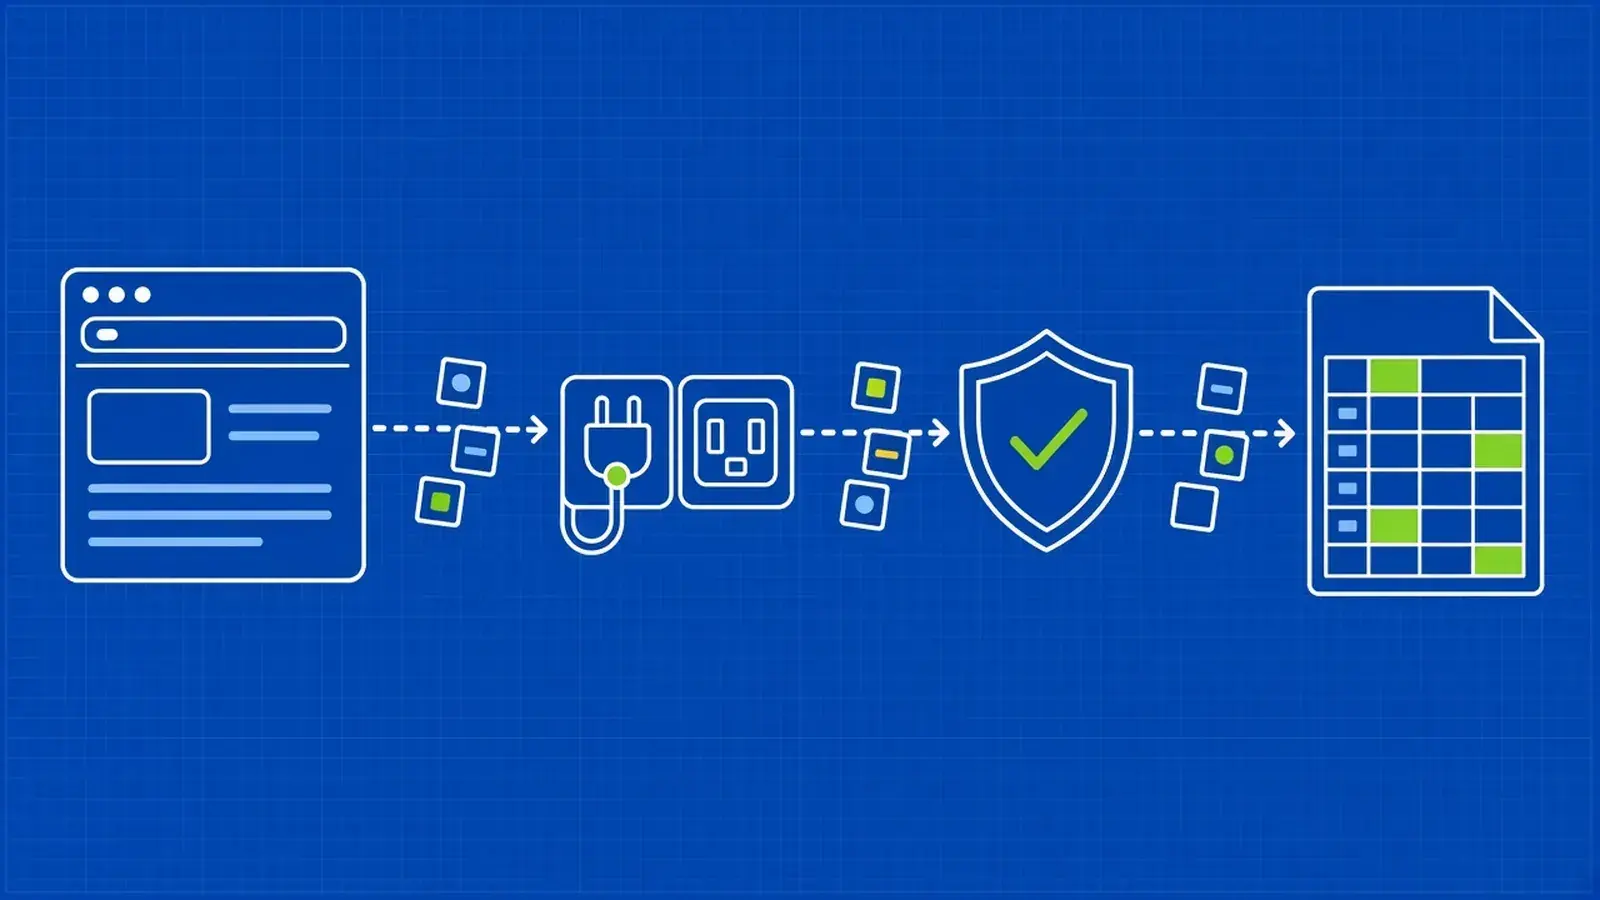
HTML → URL 管道:

SERP fetch (SERP API JSON or Scraper/Browser HTML)
        ↓
validate usable payload (JSON modules or SERP DOM)
        ↓
extract candidate hrefs / link fields
        ↓
classify → direct | goto | google_url | other
        ↓
dedupe wrappers (same token often repeats in one SERP)
        ↓
resolve with GET, bounded concurrency, connection reuse
        ↓
merge destinations + store request fingerprint + outcome codes

在解析前进行去重

一个搜索结果页面(SERP)中,同一 /goto token。逐个解析锚文本会浪费请求。在确保唯一性的同时保留顺序:

unique_goto_urls = list(dict.fromkeys(goto_urls))

有限并发与连接复用

使用较小的 worker 池,并为每个 requests.Session ,以便复用 TCP/TLS 连接。确切的工作线程数量取决于具体环境——应根据您的延迟和错误率进行调优,而非照搬其他供应商的基准数据。

错误分类(需进行监控)

代码 / 类

含义

建议处理方式

http_non_302

来自 /goto

计数;示例URL;若出现以下情况则延迟 429/5xx

missing_location

302 未 Location

将该结果标记为失败;不要自行生成 URL

timeout / 网络

瞬态

使用抖动回退重试

invalid_token

一个令牌出现持续失败

标记为失败;永远不要重试

serp_unusable

200 正文不是SERP

修复获取路径(render_js, 产品选项) 后再进行解析

wrapper_unresolved

/url 尚未处理的路径

排队待审核;未经指标验证时,请勿悄然下调排名

存储观察结果的指纹

可比的搜索结果页面(SERP)数据除URL外还需上下文信息:

  • q, gl, hl, device, domain, uule (若使用), start, num, tbm/ibp
  • 观测时间戳和架构版本
  • 抓取路径(serp_api vs scraper_html vs browser_html)
  • 计数:直接 / goto / google_url / 已解析 / 失败

这符合 WebScrapingAPI 的负责任网络数据指南:保留观察上下文,以便下游团队能够解读每条记录。

Google 何时返回 /goto ?

/goto?

简短回答:将其视为一种条件情况,而非固定规则。

第三方报告(包括 ScrapingBee 于 2026 年 9 月发布的深度分析)指出 /goto 在手动操作的Chrome和Edge浏览器中、在Playwright会话中,以及通过爬虫API获取的HTML中,而某些注重隐私的浏览器仍会显示直接目标,Safari有时则显示 /url 显示 CAES。这些是竞争对手报告的观察结果,并非WebScrapingAPI的重新测试,也不构成谷歌的承诺。据报告,仅改变IP地址或国家/地区在这些测试中不足以强制显示直接链接——再次强调,请审慎解读,切勿过度拟合。

安全的生产环境假设:

  • 自动化并非唯一触发因素。
  • 仅凭浏览器引擎本身并非可靠的切换条件。
  • 仅凭地理位置也无法作为可靠的切换条件。
  • 您的爬虫必须接受直接、 /goto且 /url 随时间推移的。

如果您需要为自身的合规性报告建立浏览器矩阵,请先进行小范围的内部初步测试并注明日期——切勿将未经核实的规则作为事实发布。

一个 CAES ?(简短附录)

CAES ?(简短附录)

发布可运行的爬虫时,你并不需要这一部分内容。它的存在是为了让团队不再在死胡同上浪费时间。

从宏观层面来看,行业分析指出:

  1. 对 CAES... 参数的 Base64URL 解码 → 二进制数据
  2. 一个紧凑的类似 Protobuf 的封装(通常是一个常量字段加上一个以长度为界限的二进制块)
  3. 受保护的有效载荷,其外层字节与加密库输出的前缀相似
  4. 对于实际抓取目的而言,无法恢复明文目标

“优先解析”策略:若确有必要,可出于好奇或恶意软件研究目的进行解码;对于搜索引擎结果页面(SERP)产品,请调用 /goto 并读取 Location。试图逆向分析受保护的二进制数据块是本末倒置的做法。

端到端路径 A — SERP API

Python:

import os
import requests

api_key = os.environ["WSA_API_KEY"]

response = requests.get(
    "https://serpapi.webscrapingapi.com/v2",
    params={
        "api_key": api_key,
        "engine": "google",
        "q": "best trail shoes",
        "gl": "us",
        "hl": "en",
        "device": "mobile",
    },
    timeout=120,
)
response.raise_for_status()
payload = response.json()

# Docs may use organic or organic_results — support both.
organic = payload.get("organic") or payload.get("organic_results") or []

for row in organic:
    link = row.get("link")
    title = row.get("title")
    # Check link on your live response; if it looks like google.com/goto or /url, classify + resolve.
    print(title, "→", link)

Node.js:

const apiKey = process.env.WSA_API_KEY;
if (!apiKey) throw new Error("WSA_API_KEY is required");

const parameters = new URLSearchParams({
  api_key: apiKey,
  engine: "google",
  q: "best trail shoes",
  gl: "us",
  hl: "en",
  device: "mobile",
});

const response = await fetch(
  "https://serpapi.webscrapingapi.com/v2?" + parameters,
  { signal: AbortSignal.timeout(120_000) }
);
if (!response.ok) {
  throw new Error("Google Search API status " + response.status);
}
const payload = await response.json();
const organic = payload.organic || payload.organic_results || [];
for (const row of organic) {
  console.log(row.title, "→", row.link);
}

cURL:

: "${WSA_API_KEY:?WSA_API_KEY is required}"
curl --get --fail-with-body --max-time 120 \
  "https://serpapi.webscrapingapi.com/v2" \
  --data-urlencode "api_key=$WSA_API_KEY" \
  --data-urlencode "engine=google" \
  --data-urlencode "q=best trail shoes" \
  --data-urlencode "gl=us" \
  --data-urlencode "hl=en" \
  --data-urlencode "device=mobile"

对于队列中的工作负载,请使用 engine=google_async 并遵循文档中所述的快照检索流程,而非在同步引擎上阻塞。

端到端路径 B — HTML → 分类 → 解析

from __future__ import annotations

import os
import threading
from concurrent.futures import ThreadPoolExecutor
from urllib.parse import urlencode

import requests
from bs4 import BeautifulSoup

# reuse classify_google_link + resolve_google_goto from earlier sections

SCRAPER_API = "https://api.webscrapingapi.com/v2"
GOOGLE_SEARCH = "https://www.google.com/search"
_thread_local = threading.local()


def fetch_google_html(query: str, api_key: str) -> str:
    target = GOOGLE_SEARCH + "?" + urlencode({"q": query, "hl": "en"})
    response = requests.get(
        SCRAPER_API,
        params={
            "api_key": api_key,
            "url": target,
            "render_js": "1",  # enable when Google returns a JS shell instead of a SERP
        },
        timeout=120,
    )
    response.raise_for_status()
    return response.text


def assert_usable_serp(html: str) -> None:
    soup = BeautifulSoup(html, "html.parser")
    if not soup.select("#rso a[href], #search a[href]"):
        raise RuntimeError("No recognizable Google search results found (unusable SERP body)")


def extract_links(html: str) -> tuple[list[str], list[str], list[str]]:
    soup = BeautifulSoup(html, "html.parser")
    direct, goto, google_url = [], [], []
    for anchor in soup.select("#rso a[href], #search a[href]"):
        href = anchor.get("href") or ""
        kind, url = classify_google_link(href)
        if kind == "direct":
            direct.append(url)
        elif kind == "goto":
            goto.append(url)
        elif kind == "google_url":
            google_url.append(url)
    return direct, goto, google_url


def get_worker_session() -> requests.Session:
    session = getattr(_thread_local, "session", None)
    if session is None:
        session = requests.Session()
        _thread_local.session = session
    return session


def resolve_goto(url: str) -> tuple[str, str | None]:
    session = get_worker_session()
    try:
        response = session.get(url, allow_redirects=False, timeout=10)
    except requests.RequestException:
        return url, None
    if response.status_code != 302:
        return url, None
    return url, response.headers.get("Location")


def resolve_many(urls: list[str], workers: int = 5) -> dict[str, str]:
    unique_urls = list(dict.fromkeys(urls))
    with ThreadPoolExecutor(max_workers=workers) as executor:
        results = executor.map(resolve_goto, unique_urls)
    return {src: dest for src, dest in results if dest}


def main() -> None:
    api_key = os.environ["WSA_API_KEY"]
    html = fetch_google_html("best trail shoes", api_key)
    assert_usable_serp(html)

    direct, goto, google_url = extract_links(html)
    direct = list(dict.fromkeys(direct))
    goto = list(dict.fromkeys(goto))

    resolved = resolve_many(goto, workers=5)
    # Optionally add handlers for google_url wrappers here.

    destinations = list(dict.fromkeys(direct + list(resolved.values())))
    for url in destinations:
        print(url)

    # Persist fingerprint + counts in your store:
    # path=scraper_html, q, hl, render_js=1, n_direct, n_goto, n_resolved, n_failed


if __name__ == "__main__":
    main()

安装: pip install requests beautifulsoup4. 请将 WSA_API_KEY 在环境中——切勿将其硬编码。

负责任的使用

公开的搜索结果页面(SERP)URL 仍属于网络数据。在扩大数据采集规模之前:

  1. 明确业务目的(排名监控、竞争对手可见度、市场调研)。
  2. 界定公开数据源的范围(Google 域名、市场、设备、排除项)。
  3. 仅保留最低限度的有用记录——无需收集 Google 渲染的每个字段。
  4. 为访问、保留和决策指定下游负责人。
  5. 保留观察背景,确保结果可解读。

请阅读 WebScrapingAPI 的操作简报:《负责任的网络数据》。您的团队负责确定目的、数据源范围及下游用途;WebScrapingAPI 负责操作所选的 API 路径。本文不构成法律建议,亦非规避安全控制的指南——它是一套用于合法公开搜索观察的实用 URL 处理流程。

常见问题

我需要解密 CAES 令牌吗?

CAES 令牌吗?

不需要。对于数据抓取和排名追踪, GET 该 /goto URL(禁用重定向并读取 Location。本地 Base64URL/protobuf 解码无法生成可用的明文目标。

我应该使用 HEAD 来解析 /goto ?

HEAD 来解析 /goto?

首选 GET。公开报告称 HEAD 可能会返回 200 不 Location ,而 GET 返回 302 会返回目标地址。请在生产环境中确认 HEAD 与 GET 的 /goto 令牌上确认 HEAD 与 GET 的区别,再确定客户端的行为。

以下两者有何区别 /goto 与 /url ?

/goto 与 /url?

两者都是 Google 重定向端点,可位于搜索结果页面(SERP)与目标页面之间。 /goto 通常携带一个 CAES... url 参数。 /url 是较旧风格的封装形式,可能仍然会出现(有时包含不透明的令牌)。将两者都进行分类;对于无法解析的部分,将其视为直接目标地址。

我应该使用 SERP API 还是抓取 Google HTML?

当结构化自然搜索结果符合您的架构规范时,建议优先使用 Google 搜索 SERP API——HTML 更稳定,请求指纹更清晰。当您需要原始标记或自定义交互时,请使用 Scraper API 或 Browser API。文档示例中显示的是最终呈现效果的 link ;请在您的实时响应中核对 link 字段,并记录日期,切勿在确定该格式属于 Google /goto 推出前,请先自行检查实时响应中的字段并记录日期。

这些 CAES 令牌会过期吗?

CAES 令牌会过期吗?

第三方报告显示,令牌在超过一天的时间内仍可解析,且可能在原始浏览器会话之外依然有效。其最大有效期尚不明确。请将其视为不透明的临时重定向,而非永久标识符。(此信息由竞争对手报告;本文未重新验证。)

Playwright(或自动化工具)是否会导致 /goto ?

/goto?

作为唯一原因时并不可靠。竞争对手报告的测试显示 /goto 在手动操作的 Chrome 以及自动化的 Chromium 中均出现该问题。请勿将“Playwright = /goto,Brave = 直接”的规则写入生产逻辑。

行业报告指出,某些令牌可在某个环境中收集,随后通过普通 HTTP 客户端解析。这有助于将 HTML 获取与重定向解析区分开来——但不能保证适用于未来所有令牌变体。记录失败情况。

谷歌为何使用 /goto ?

/goto?

谷歌将重定向措施定位为保护搜索服务免受不断演变的滥用行为的一部分。确切的筛选逻辑并未完全公开。从爬虫的角度来看,目标页面已不再总是以HTML中的明文形式呈现。

如果我的爬虫 API 响应 200 却没有自然搜索链接呢?

200 却没有自然搜索链接呢?

将其视为无法使用的搜索结果页面(SERP)主体。在 render_js=1 ,在适当情况下确认目标URL和语言环境,或切换至结构化搜索结果API。切勿仅凭状态码做出判断。

我该如何存储结果以便进行排名比较?

请将目标地址与请求指纹(q, gl, hl, device、域名、偏移量、抓取路径、时间戳)一起存储目标网址。这符合负责任的观察实践,并可防止因地区或设备混用而导致的虚假“排名变化”。

后续步骤

  1. 调用同步版 Google 引擎,地址为 https://serpapi.webscrapingapi.com/v2 并使用 api_key, engine=google,并 q.
  2. 检查自然搜索 link 自然搜索结果,并记录日期。
  3. 若继续使用 HTML,请在扩展关键词量之前完成分类 → 去重 → 解决步骤。
  4. 与数据负责人一起审查可靠的网络数据。

从 Google 搜索 API 开始,比较各搜索引擎的 SERP API,或在结构化结果不足时通过 Scraper API / 浏览器 API 抓取页面 HTML。

关于作者

Suciu Dan, 联合创始人 @ WebScrapingAPI

Suciu Dan

联合创始人

Suciu Dan 是 WebScrapingAPI 的联合创始人,他撰写了关于 Python 网页抓取、Ruby 网页抓取以及代理基础设施的实用指南,这些指南专为开发者而设计。

Nodriver Python 教程:隐身浏览器爬取——从第一个脚本到投入生产
网络爬虫技术

Nodriver Python 教程:隐身浏览器爬取——从第一个脚本到投入生产

TL;DR: 简而言之:Nodriver 是一个异步 Python 库,通过 Chrome DevTools Protocol 驱动 Chromium,无需 Selenium 或 chromedriver 二进制文件。当一个更接近真实 Chrome 会话的自托管隐身浏览器比 WebDriver 技术栈更合适时,请使用它;但要知道,它本身并不能消除 IP、TLS 或行为层面的风险。本教程从第一个脚本讲到容器化生产部署以及托管的 Browser API。

Suciu Dan5 min read
阅读文章
cURL 中的 HTTP 响应头:每个标记、技巧和脚本配方
网络爬虫技术

cURL 中的 HTTP 响应头:每个标记、技巧和脚本配方

TL;DR: 简要说明:cURL 默认隐藏响应头信息。使用 -i 可以看到响应头和正文,使用 -I 可以看到 HEAD 请求只返回响应头,使用 -v 可以看到完整的请求/响应调试,使用 -D 可以将响应头保存到文件中。对于现代脚本,cURL 7.83+ 允许提取单个头信息,或使用 -w write-out 选项将所有头信息转存为 JSON 格式。

Suciu Dan3 min read
阅读文章
什么是无头浏览器?架构、用例和顶级工具
网络爬虫技术

什么是无头浏览器?架构、用例和顶级工具

TL;DR: 简要说明:无头浏览器是一种网络浏览器,运行时没有可见的图形界面,完全由代码或命令行指令控制。开发人员将无头浏览器用于自动测试、网络扫描、性能监控,并越来越多地用于支持人工智能代理。本指南将介绍无头浏览器的内部工作原理、何时选择无头浏览器而非普通浏览器,以及哪些框架值得你花时间研究。

Suciu Dan2 min read
阅读文章

开始构建

准备好扩展您的数据收集规模了吗?

加入2,000多家企业,使用WebScrapingAPI在无需任何基础设施开销的情况下,以企业级规模提取网络数据。