

指南
如何测试代理:6 种实用方法
TL;DR: 简而言之:糟糕的代理服务器代价高昂。它们会消耗带宽、触发封禁,并悄无声息地破坏你的 scraper 所依赖的数据。本指南介绍了如何使用 ping、curl、在线检查器、IP 数据库和一个可重复使用的 Python 脚本来测试代理的五个健康信号(连接性、出口 IP、速度、匿名性和声誉),您可以将其放入您的 CI 管道中。
Robert Munceanu2 min read
阅读文章作者简介
罗伯特·蒙塞阿努(Robert Munceanu)是 WebScrapingAPI 的全栈开发工程师,他在产品各领域均有贡献,并协助构建了支持该平台的可靠工具和功能。

已发表的文章
10 文章
TL;DR: 简而言之:糟糕的代理服务器代价高昂。它们会消耗带宽、触发封禁,并悄无声息地破坏你的 scraper 所依赖的数据。本指南介绍了如何使用 ping、curl、在线检查器、IP 数据库和一个可重复使用的 Python 脚本来测试代理的五个健康信号(连接性、出口 IP、速度、匿名性和声誉),您可以将其放入您的 CI 管道中。
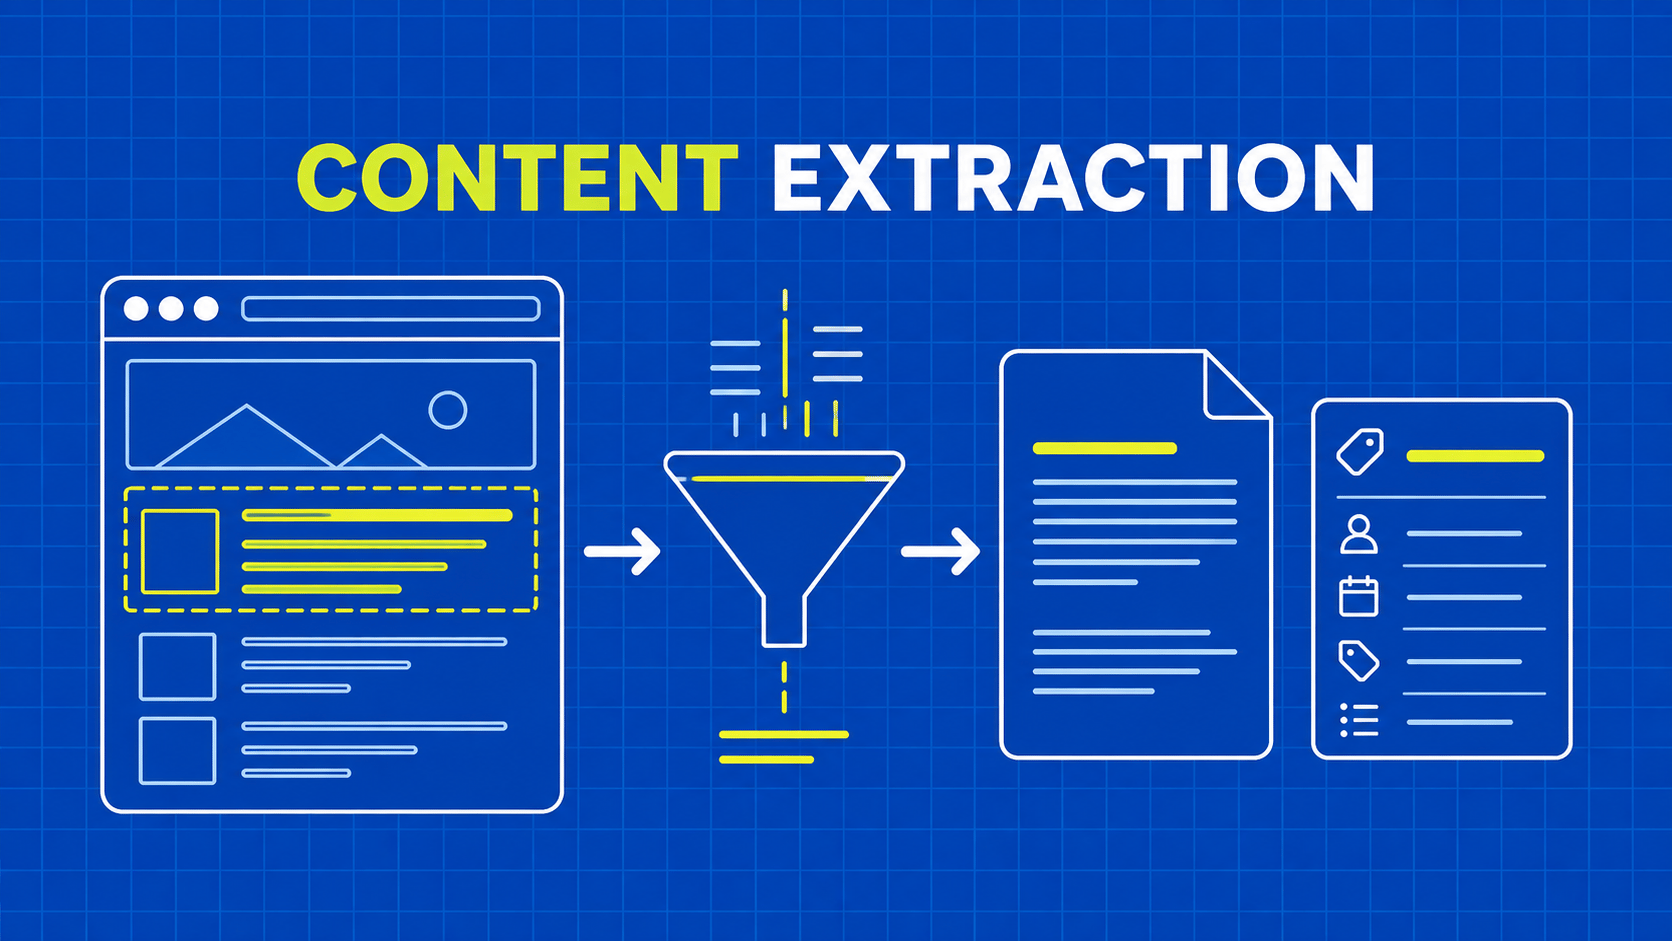
TL;DR: 选择一种适用于各种布局或精确模板规则的文章提取器,然后在您自己的语料库上测试文本保真度、元数据、结构以及错误处理情况。
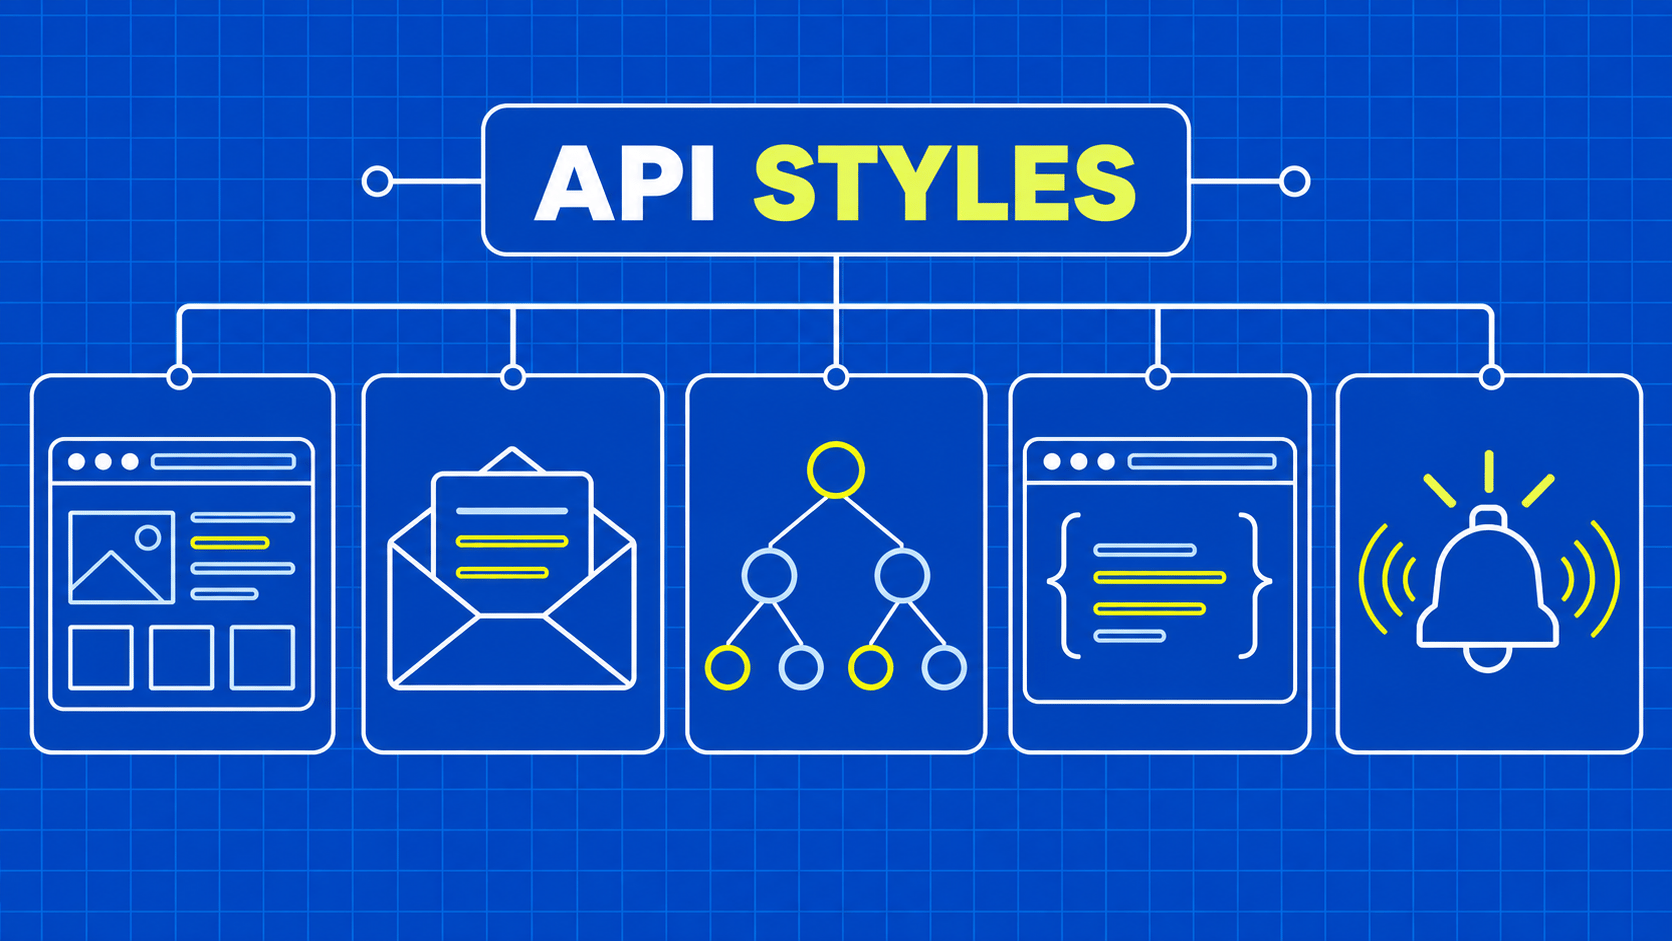
TL;DR: 区分五种常见的 API 实现方式,同时避免将架构、协议和交付模式混为一谈。通过一个实际的目录场景,比较它们的契约。
TL;DR: 简而言之:最适合网页抓取的免费代理列表是:用于脚本的 ProxyScrape 列表、注重在线率和 ASN 筛选的 Geonode 列表,以及 GitHub 上适合纯文本管道输入的 monosans/proxy-list。请把每个列表都视为候选池,因为在任何一天只有一小部分列出的代理可用;切勿通过免费代理发送登录信息或访问支付页面。
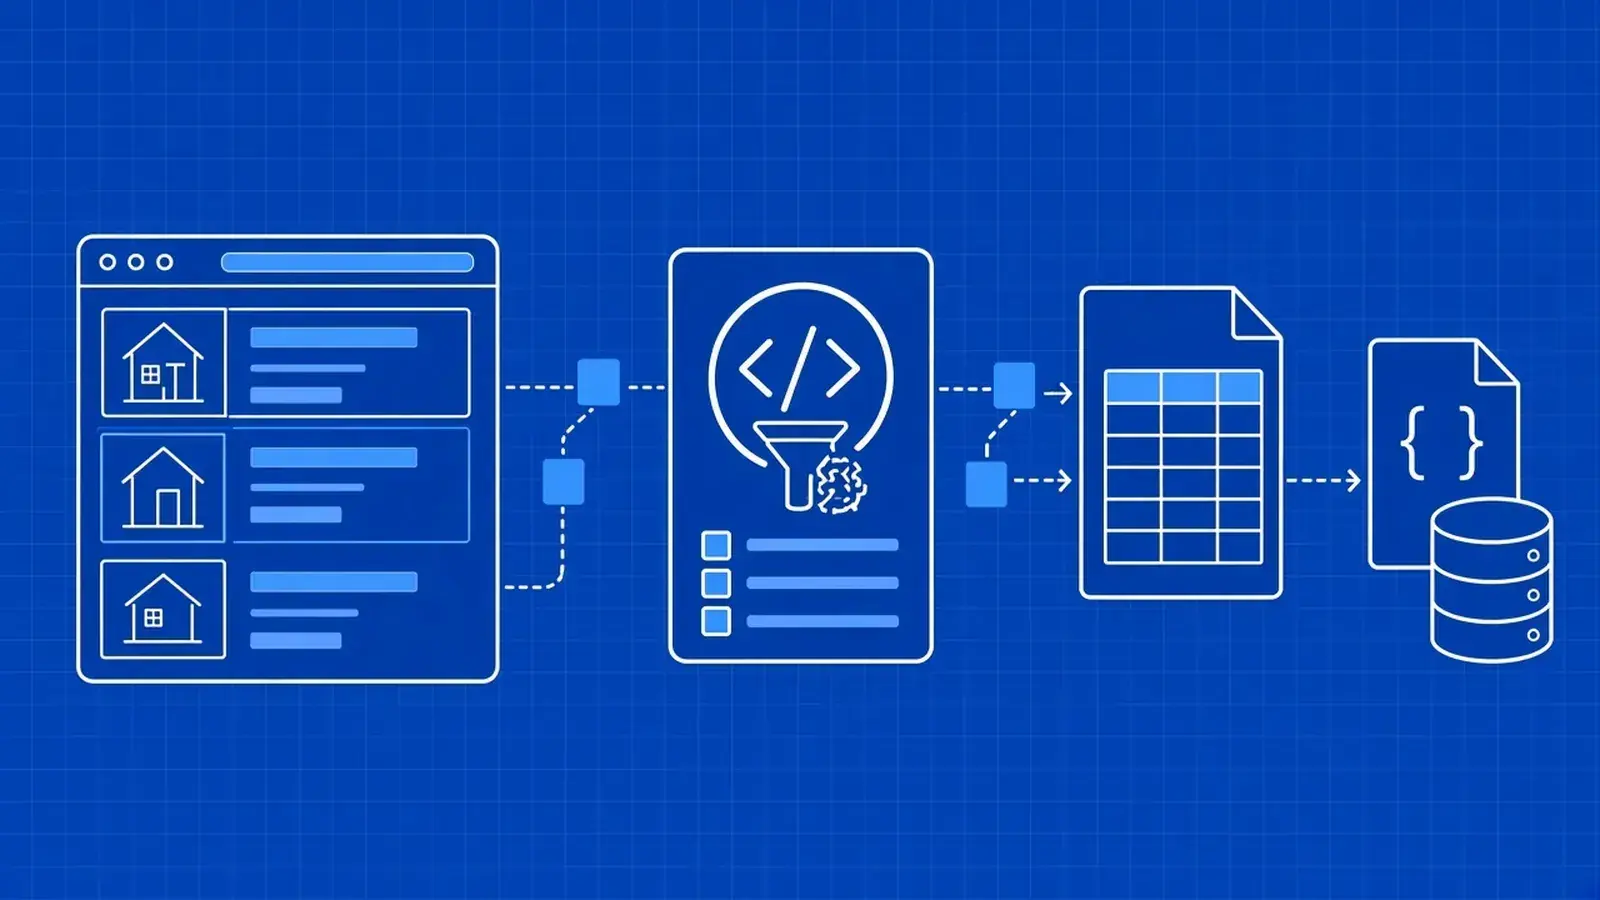
TL;DR: 学习如何用 Python 抓取房地产数据:选择数据源,解析房源列表和 JSON-LD,核查各房产门户的使用条款,并通过开放数据获取房价。
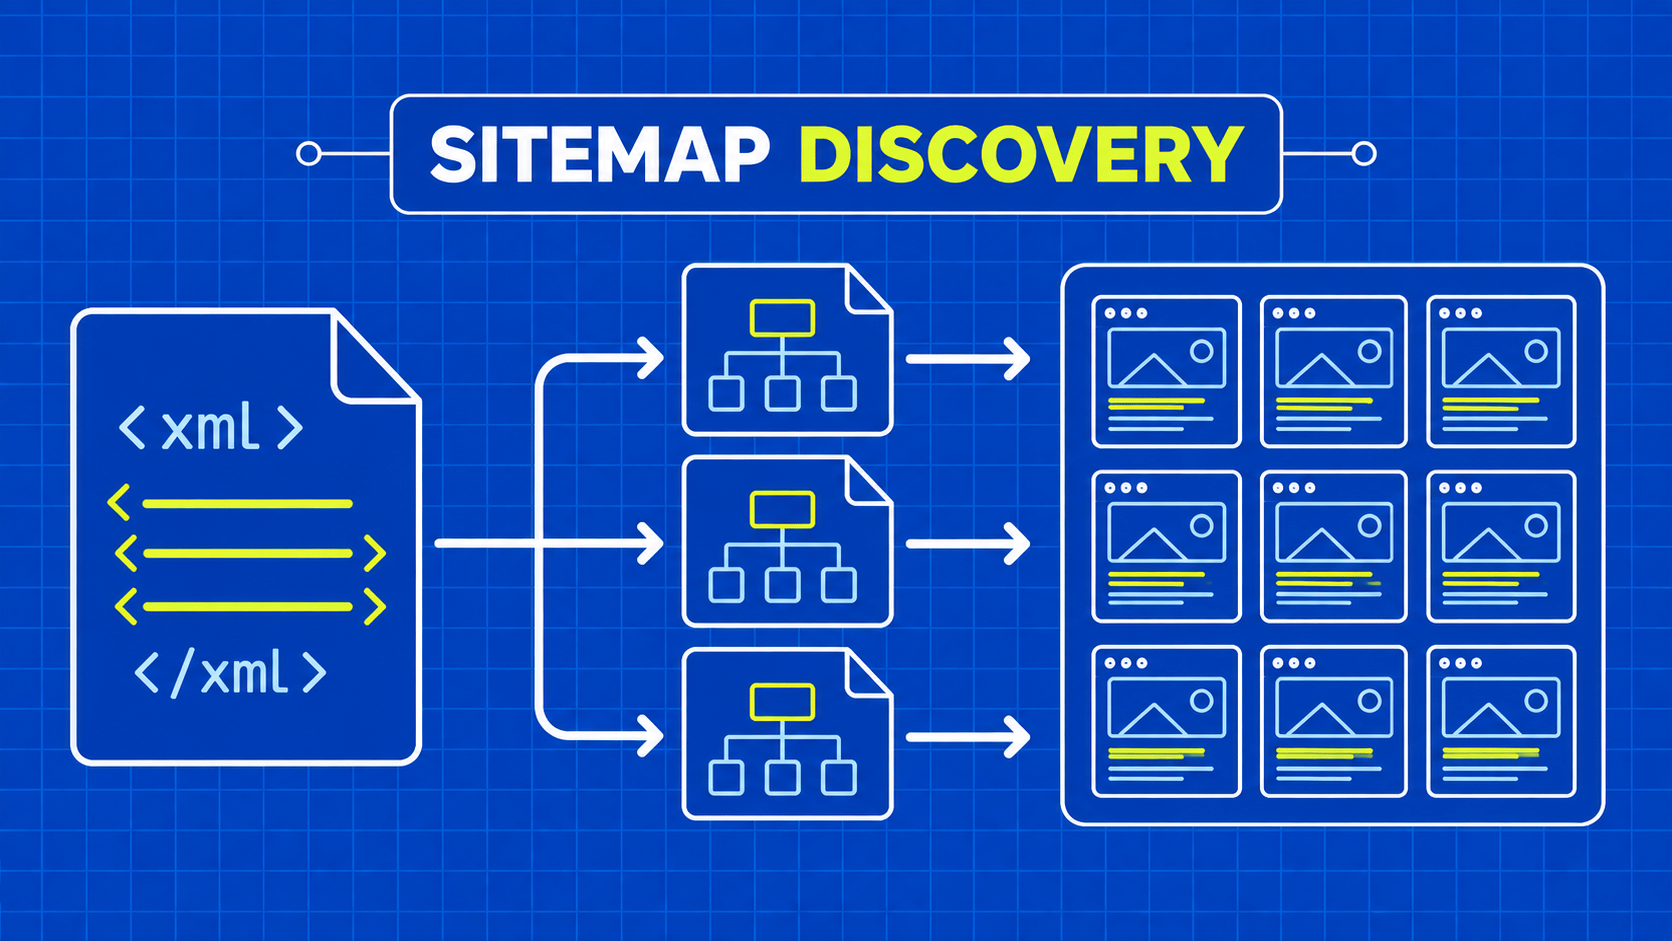
TL;DR: 将网站地图索引转化为可追踪的 URL 发现队列。了解支持命名空间的解析、协议限制、数据时效性注意事项,以及针对不可信 URL 的安全边界。
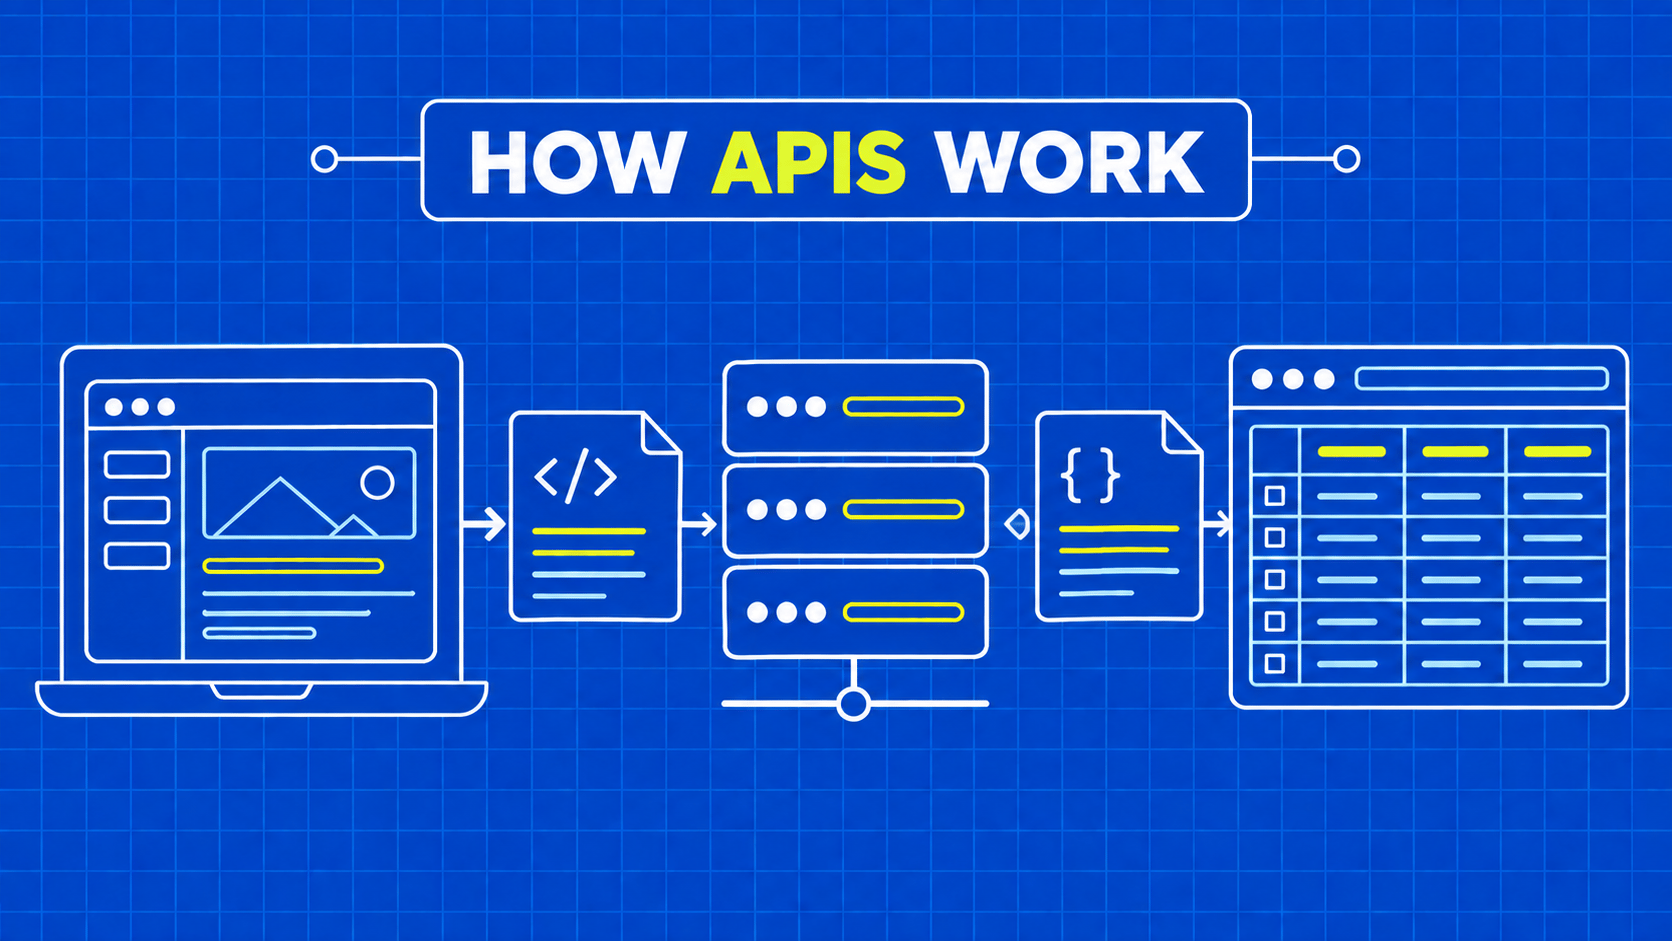
TL;DR: 以一个虚构的目录查询为例,从文档说明追踪至经过验证的记录。在进行扩展之前,先了解端点、响应字段、身份验证、分页以及错误处理。
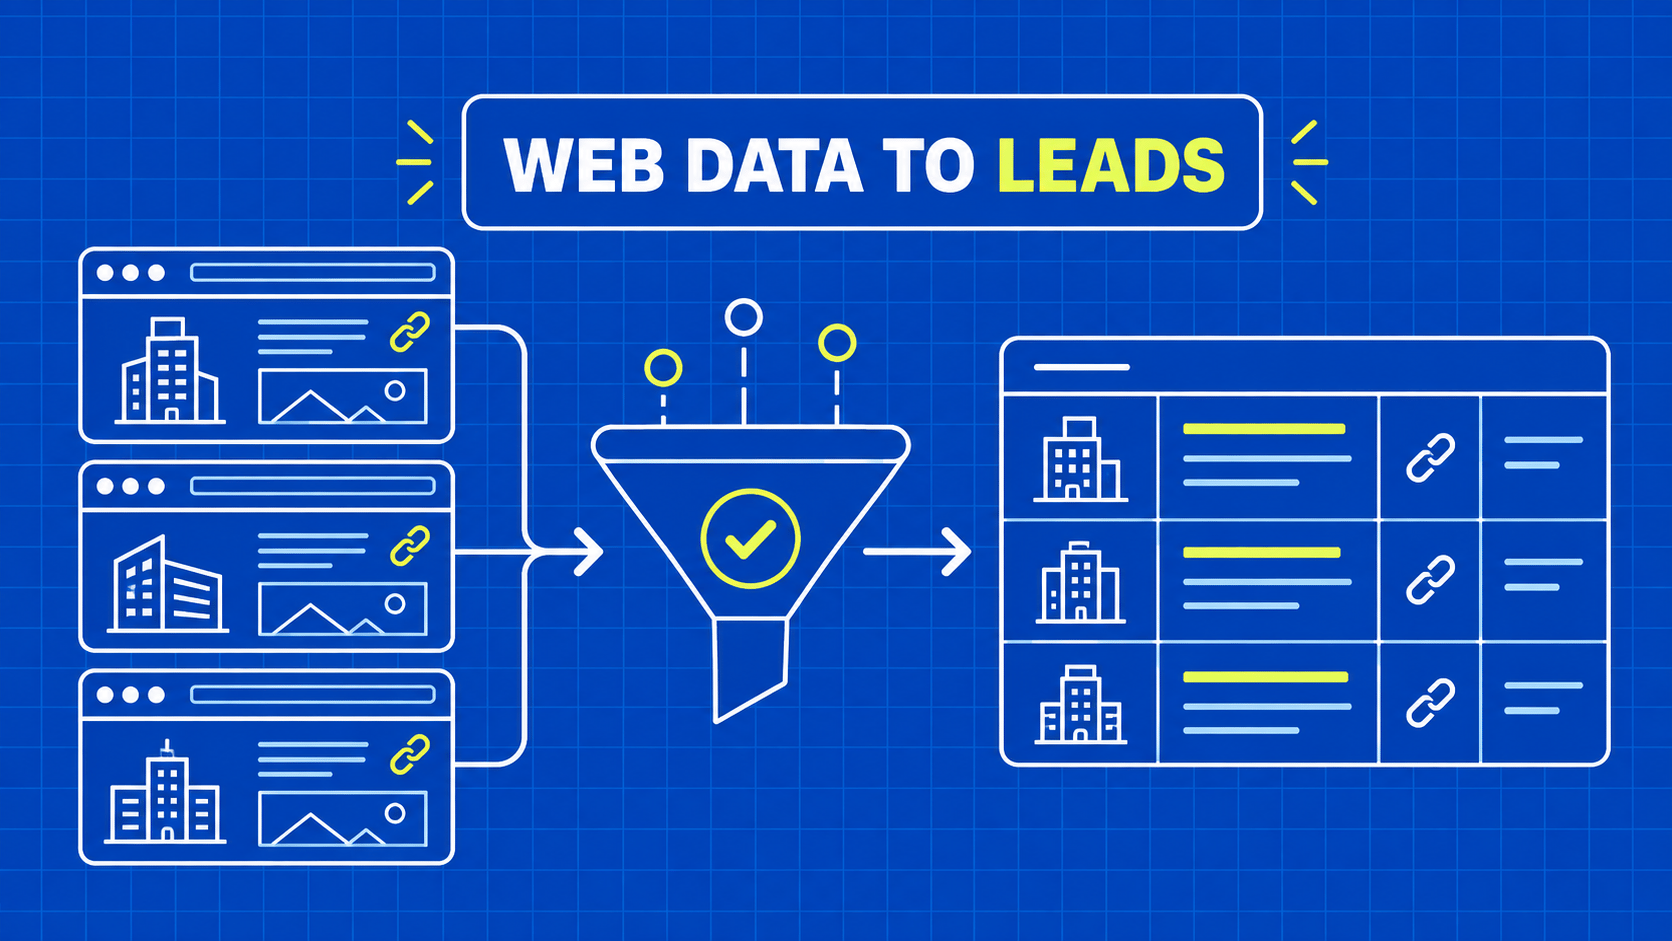
TL;DR: 用网页抓取搭建 B2B 销售线索管道:选择数据源、规范化企业数据、去重、对客户进行资格评估,并安全同步到 CRM。
TL;DR: 用于网络爬虫的最佳代理就是目标网站能够接受的、价格最低的那种。本指南将数据中心代理、ISP代理、住宅代理和移动代理与爬虫任务进行匹配,对比了九家服务商的公开定价,介绍了如何计算每次成功请求的成本,并提供了一个 Python 测试框架,供您在购买前使用自己的 URL 测试各家服务商。
TL;DR: 请先将密钥设置为环境变量,并发送您的第一个 WebScrapingAPI 爬虫 API 请求,随后仅在目标需要时,再添加 JavaScript 渲染、地理定位、数据提取规则和异步任务。 本指南涵盖了所有已记录的错误代码、按调用计费的跟踪机制、截至 2026 年 10 月的套餐方案、何时应选择浏览器 API、搜索结果页面 (SERP) API、爬虫 API 或数据 API,以及如何通过 Web MCP 连接 AI 代理。