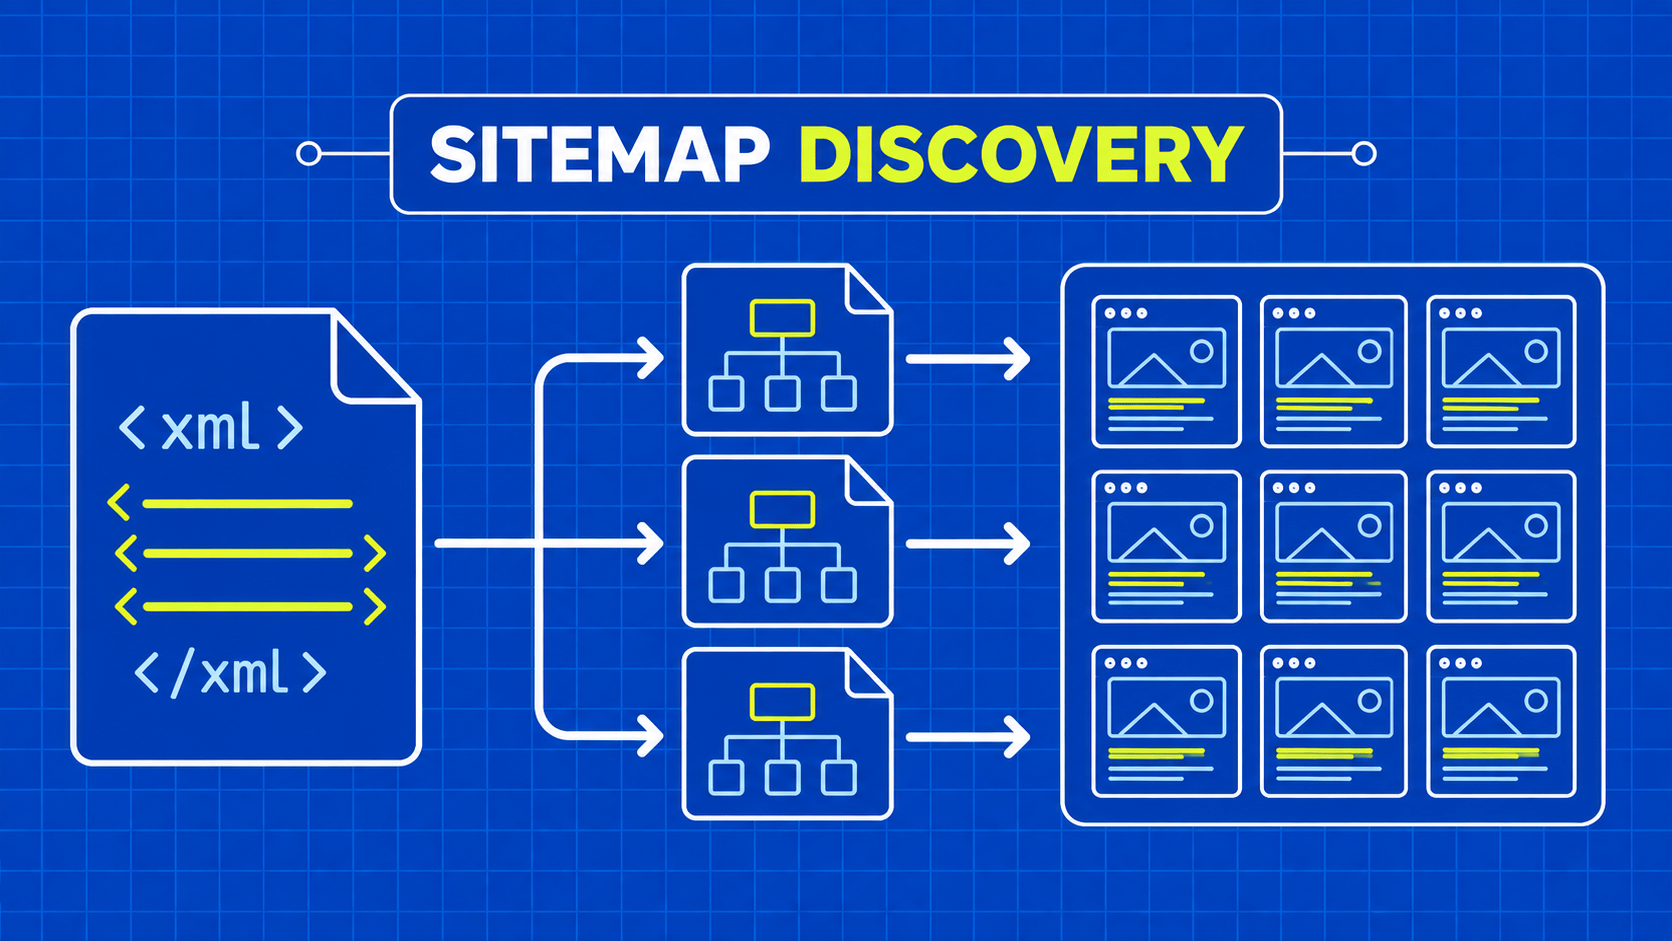
简而言之:网站地图是一种发现输入,而非完整的数据集,也不代表可以抓取其中列出的每个 URL。应区分 URL 集合与索引,有意识地解析命名空间,将时效性元数据视为来源声明,并在将目标添加到集合队列之前严格执行检索边界。
某个产品类别显示了二十个链接,但其网站地图却列出了数千个产品地址。通过抓取网站地图,您可以发现这个更大的候选集合,而无需逐一浏览每个菜单。关键区别在于:网站地图仅提供位置信息和有限的元数据;它既不提供产品记录本身,也不保证所列出的每个页面均可访问。
基于网站地图的发现还会改变信任边界。XML 文件及其内部的 URL 属于外部输入。解析器可能成功识别出某个文档,但生成的地址却超出了您的采集范围。一个索引可能指向许多文档,而压缩文件解压后的体积可能远超其传输大小。
本指南将发现、验证和收集三个环节区分开来。您将检查两种主要的 XML 格式,运行本地 Python 测试脚本,定义遍历限制,并决定如何使用 lastmod ,但不要将其视为变更的证明。本练习使用存储在内存中的虚构文档,不会发起任何网络请求。在将发现的页面添加到真实的抓取队列之前,请将相同的推理方法应用于已获批准的网站。