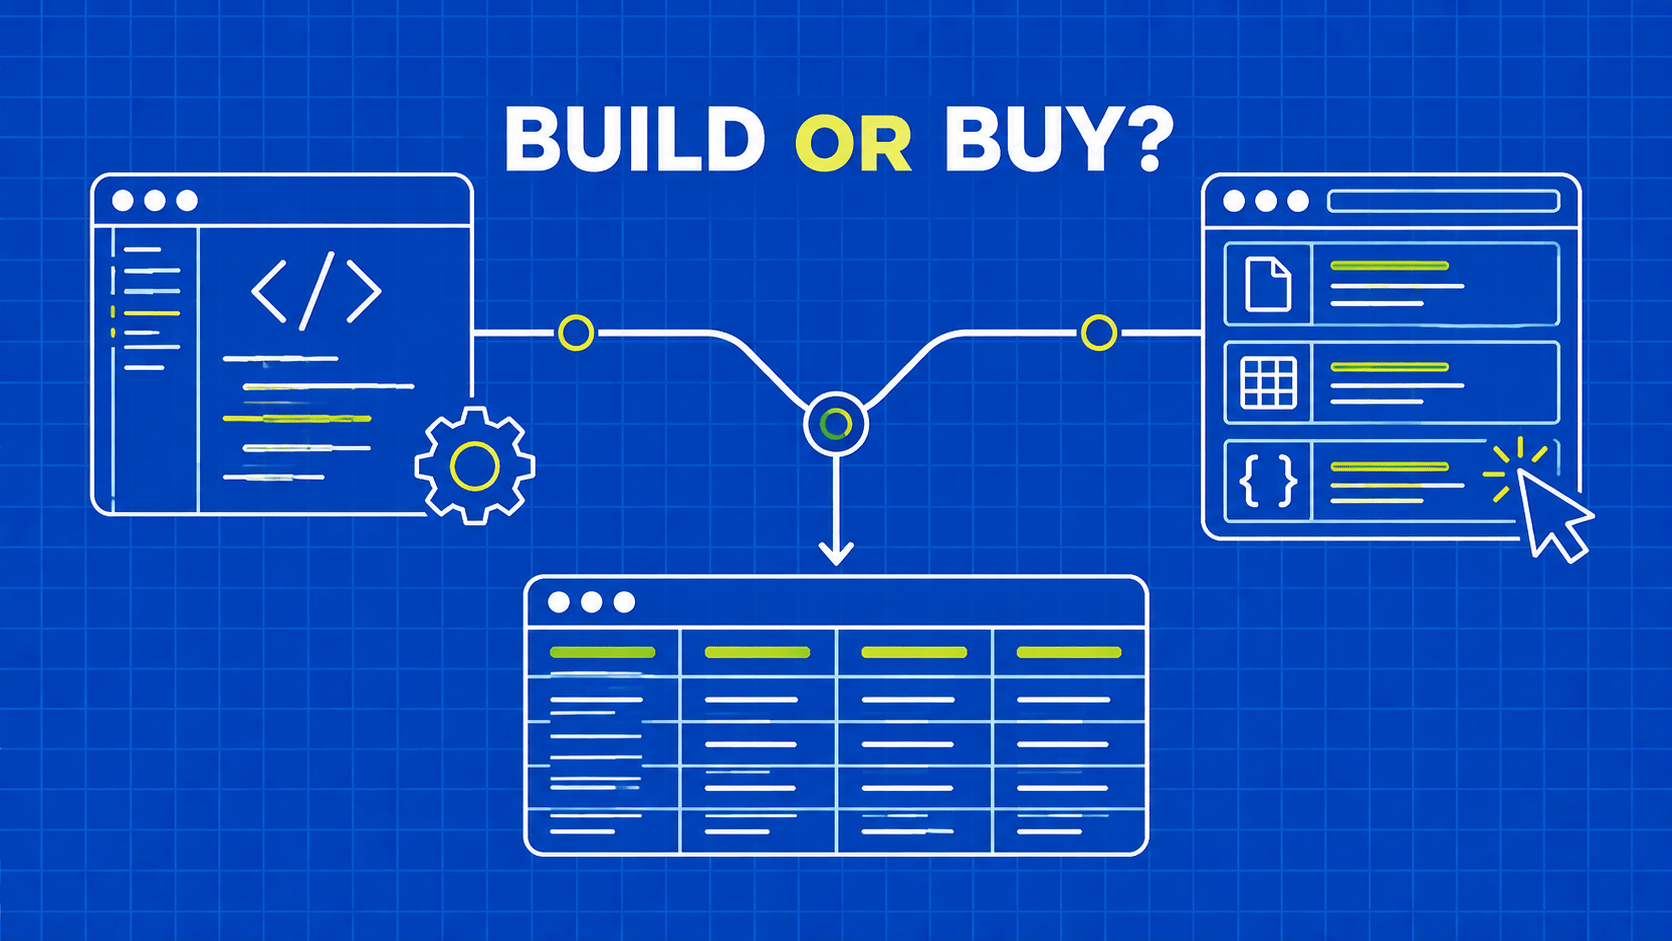
简而言之:当您的数据提取逻辑、部署限制或数据源覆盖范围需要某种控制权,而现有工具无法满足时,请开发自定义爬虫。对于那些无法让您的产品脱颖而出的数据采集功能,直接购买现成解决方案即可;随后,从新采集的有效记录数量、工程维护成本以及日后切换方案的灵活性等方面,对这两种方法进行比较。
自定义爬虫是由您的团队设计和维护的软件,用于根据特定需求收集网站数据。数据提取工具则通过可视化界面、托管 API 或托管交付服务提供部分此类功能。因此,选择自定义爬虫还是数据提取工具,本质上是一个责任归属的问题:数据采集管道的哪些部分应由您的开发人员负责?
设想一个需要从公开供应商目录中获取每日价格的产品团队。一个能从单个页面提取价格的脚本,只能证明该字段可访问,却无法证明团队能够收集所有必需的变体、区分促销活动与格式变更,或在下次报表生成前补救遗漏的数据。
正确的比较应从这一交付要求入手。自定义实现可能非常适合该需求;托管服务则可能免除最繁重的运维工作。 两者的结合则可能让您在保留产品逻辑的同时,将页面抓取工作外包。本指南为您提供了一个决策矩阵、成本模型和试点计划,帮助您在这些选项中进行选择,而无需依赖供应商基准测试,也不必假设工程时间是免费的。