
指南
Cheerio 与 Puppeteer:如何选择正确的工具
TL;DR: 简而言之:Cheerio 是轻量级 HTML 解析器;Puppeteer 驱动真正的 Chromium 浏览器。当数据已经存在于原始 HTML 中时,使用 Cheerio;当 JavaScript 渲染数据时,使用 Puppeteer;当每次访问需要提取大量字段的 JS 页面时,将它们结合起来使用。
Sergiu Inizian3 min read
阅读文章作者简介
Sergiu Inizian 是 WebScrapingAPI 的技术内容撰稿人,负责创作清晰、实用的内容,帮助开发者了解产品并有效使用它。

已发表的文章
6 文章
TL;DR: 简而言之:Cheerio 是轻量级 HTML 解析器;Puppeteer 驱动真正的 Chromium 浏览器。当数据已经存在于原始 HTML 中时,使用 Cheerio;当 JavaScript 渲染数据时,使用 Puppeteer;当每次访问需要提取大量字段的 JS 页面时,将它们结合起来使用。
TL;DR: 按每 GB 或每端口价格、运营商与 ASN 定向、5G、粘性会话和试用条款,对比 9 家用于网页抓取的移动代理服务商(截至 2026 年 10 月)。

TL;DR: 简而言之:现代阻塞发生在四个层面:网络、请求签名、浏览器和行为。首先使用状态代码和挑战页面对该层进行诊断,然后通过旋转式住宅代理、浏览器级标头、TLS 冒充、隐身浏览器和类人计时的正确组合进行修复。当流量或反僵尸技术的复杂性导致 DIY 不经济时,可将请求层卸载到托管 API。
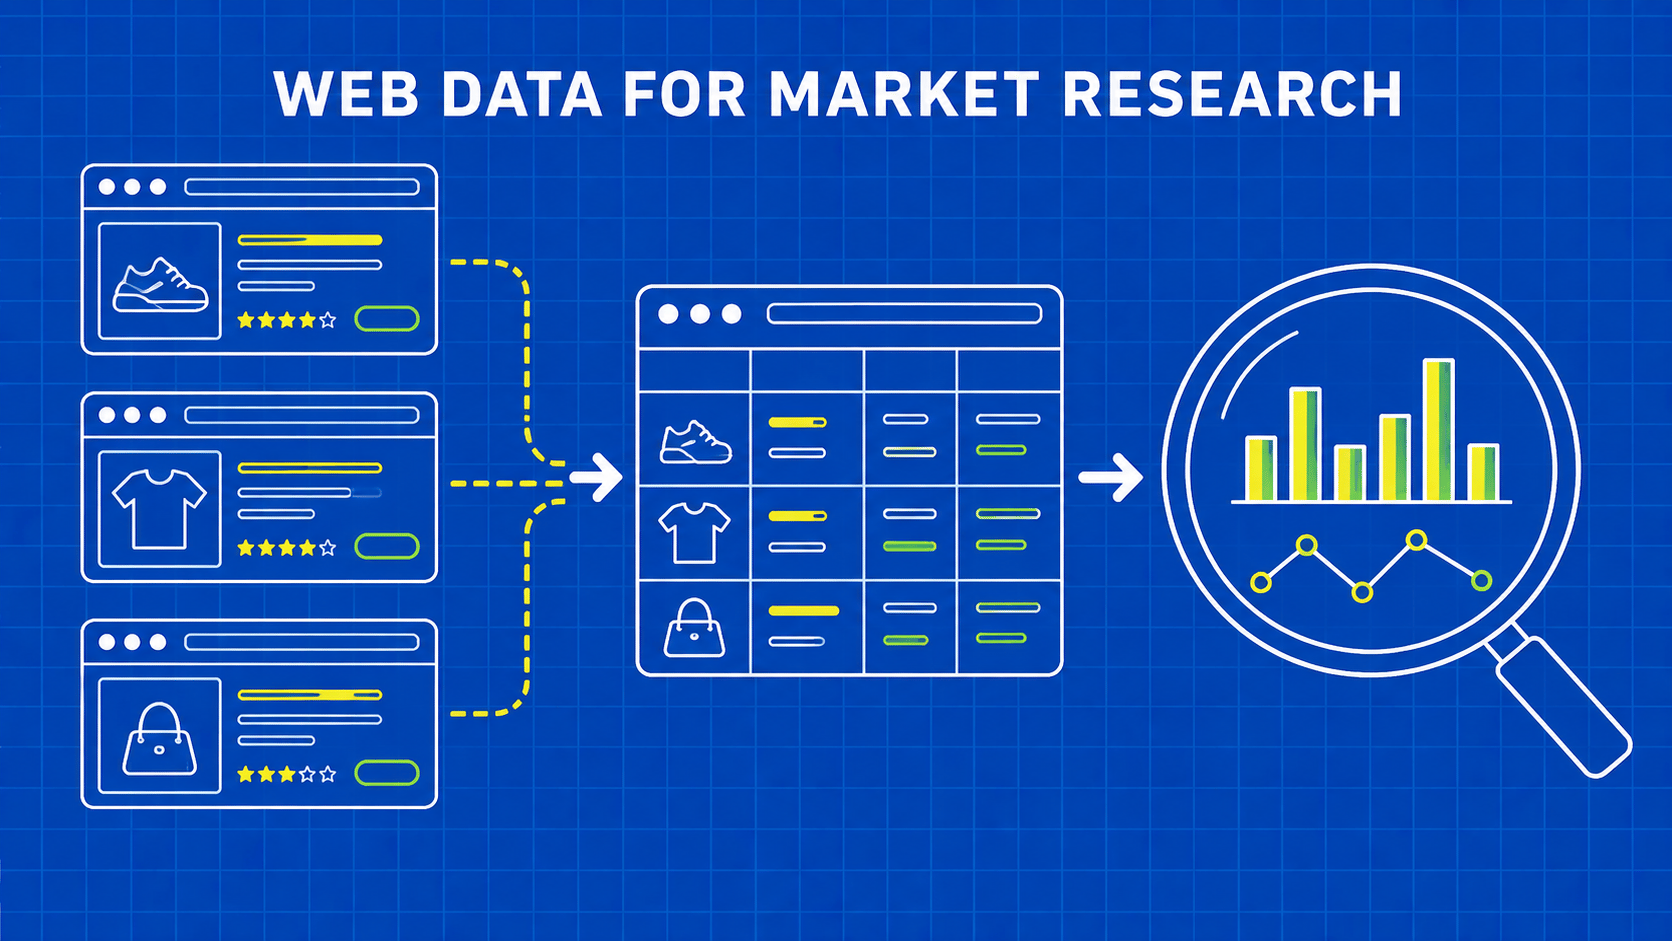
TL;DR: 构建值得信赖的竞争对手数据集:定义样本、匹配产品、验证价格,并在报告市场观察结果时避免夸大证据。
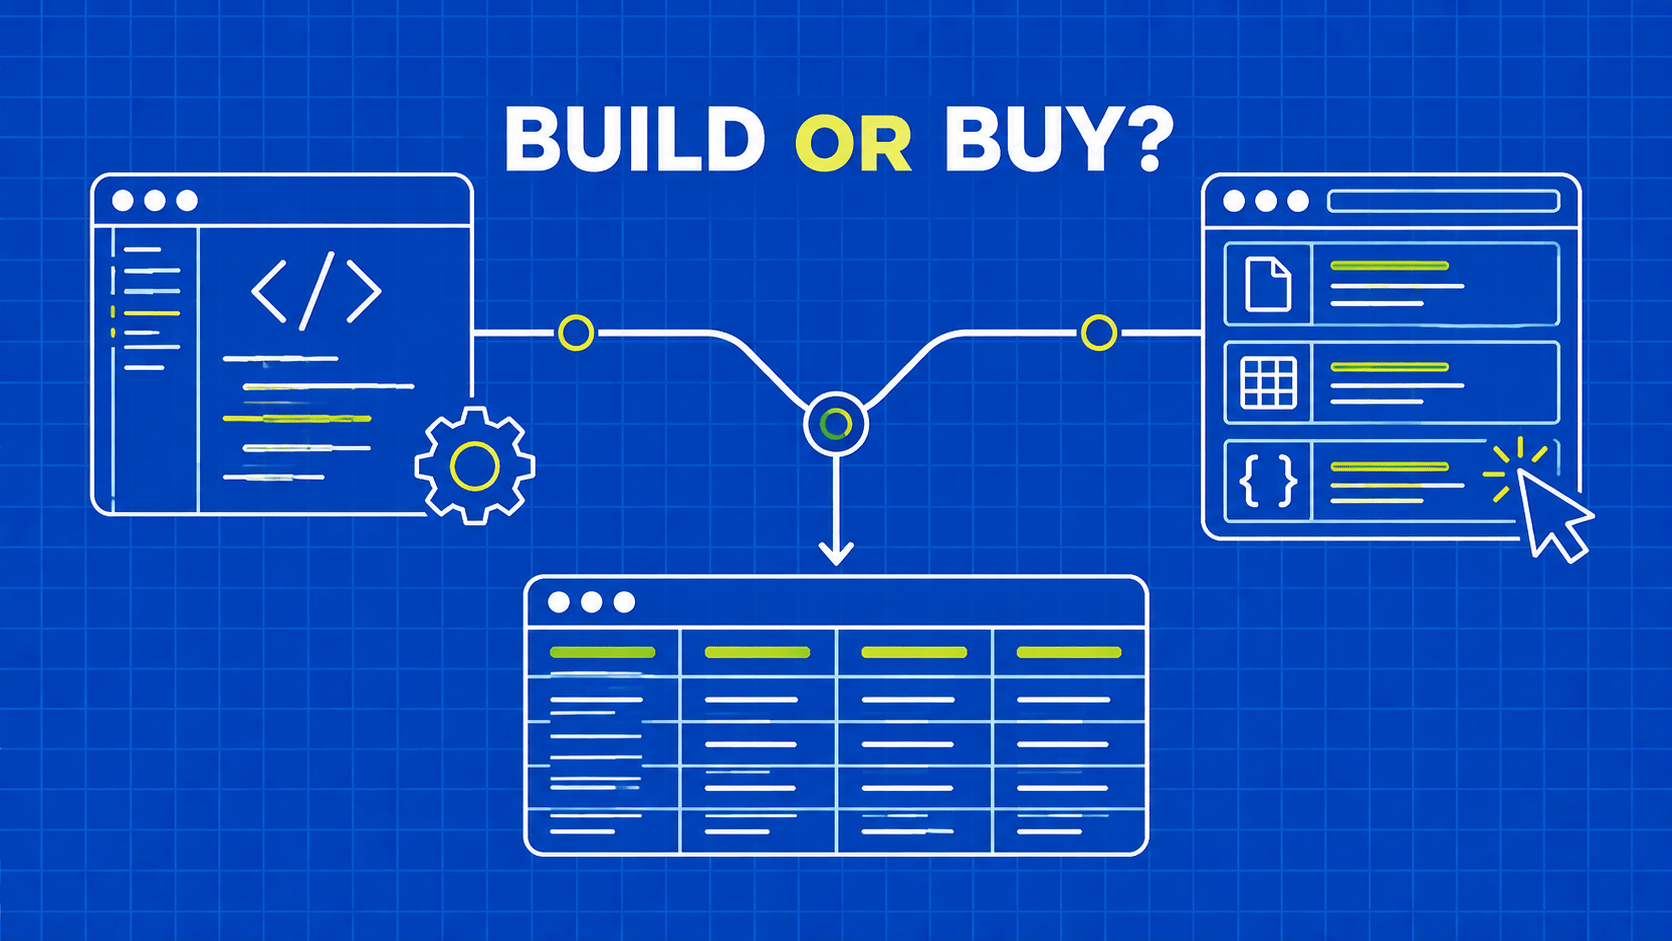
TL;DR: 通过数据合同、所有权对比、总成本模型以及实际试点,决定是自行开发、购买还是组合使用数据抓取工具。
TL;DR: 简要说明:网络搜刮是将公共网络数据自动提取为您可以实际使用的结构化格式,如 JSON 或电子表格。本指南从定义层面介绍了什么是网络刮削、网络刮削背后的请求-解析流水线、团队在哪里使用网络刮削、从无代码到可管理 API 的工具范围,以及如何在反僵尸防御和法律方面保持正确的立场。