跳至内容
免费开始
返回博客

如何使用亚马逊数据抓取 API:快速入门指南

Robert Sfichi最后更新于 6 min read
如何使用亚马逊数据抓取 API:快速入门指南
简而言之:要使用 Amazon Scraper API,请向 https://ecom.webscrapingapi.com/v1 发送 GET 请求,附上 api_key、engine=amazon、请求类型及该类型的输入,例如 product_id 中的 ASIN 或 q 中的关键词。单个 ASIN 用 product,关键词用 search,类目 ID 用 bestsellers 或 todays-deals,卖家 ID 用 seller_products 或 seller_feedback。本指南涵盖全部九种请求类型、20 个站点、错误处理和套餐。

您需要能够存储和跨市场比较亚马逊商品、搜索、排名、评论或卖家数据的代码,而无需为每个页面布局维护一个专门的爬虫。本指南使用 WebScrapingAPI 的亚马逊 API。 完成本指南后,您将能够:在环境变量中设置密钥并发送首个请求;选择正确的请求类型;定位正确的亚马逊域名和交付位置;使用一个解析器读取所有响应结构;根据文档中规定的错误处理规则进行重试;并选择合适的套餐。

快速入门

  • 端点: https://ecom.webscrapingapi.com/v1 (GET)
  • 必填: api_key, engine=amazon, type,外加该类型的专属输入(q, product_id, category_id,或 seller_id)
  • 请求类型:九种,从单个商品到卖家评价
  • 免费试用:100 次亚马逊请求

什么是亚马逊数据抓取API,它会返回什么?

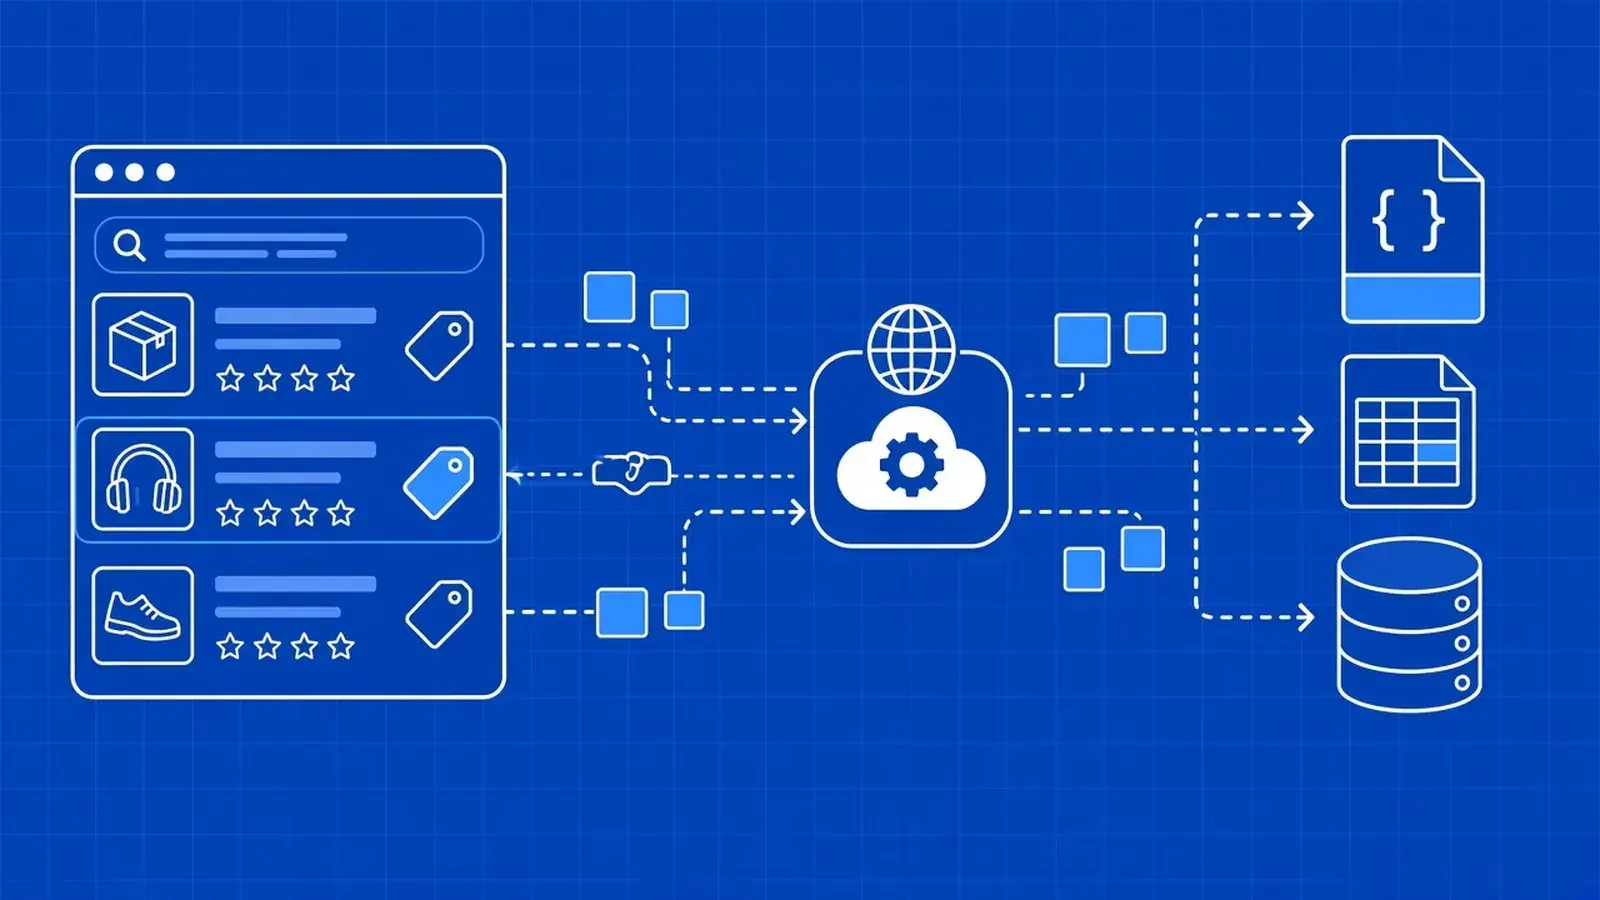
WebScrapingAPI 的亚马逊 API 是一个 GET 端点,它接受请求类型(例如商品、搜索或畅销榜),以及 ASIN、关键词、类别或卖家 ID,并以结构化 JSON 格式返回匹配的亚马逊页面。WebScrapingAPI 负责访问、数据提取和解析器的维护。 您的代码负责选择页面、市场和字段,并存储结果。

您通过 type 及其输入参数来命名页面,每个响应都采用相同的顶级布局:您请求的内容、亚马逊显示的内容以及该页面上的记录。您无需编写选择器,也无需在亚马逊更改标记时重写它们。

以下是各方的职责分工:

  • WebScrapingAPI 负责:数据源访问、数据提取、解析器更新以及质量监控。
  • 您的团队负责:确定要采集的页面和市场、保留哪些字段、刷新计划和数据交付,以及基于这些数据进行的分析。

该 API 涵盖搜索和分类结果、商品及变体页面,以及商家报价列表。各团队利用这些数据进行“购买框”和报价情报分析、搜索及分类市场份额分析,以及变体和评论信号分析。亚马逊只是更广泛的数据 API 目录中的一个数据源。

每次响应代表某个市场中某个页面在某个时刻的单次观测结果。价格、排名或评论数量只有结合生成该数据的设置和时间背景,才具有实际意义。

如何获取 API 密钥并发送您的第一个亚马逊请求?

创建一个 WebScrapingAPI 账户,在仪表盘中订阅亚马逊 API,并将 API 密钥存储在环境变量中。然后向 https://ecom.webscrapingapi.com/v1 发送一个 GET 请求,其中包含 api_key、engine=amazon、type=search,并将 q 设置为您的关键词。 让您的 HTTP 客户端负责参数编码,并将 API 密钥保存在服务器上。

  1. 使用电子邮件和密码、GitHub 或 Google 账号注册。
  2. 在仪表盘中订阅亚马逊 API。试用版包含 100 次亚马逊请求,费用为 0 美元。
  3. 将密钥存储在环境变量中,例如 WSA_API_KEY,或保存在密钥管理器中。
  4. 通过终端、Python 或 Node.js 发送请求。

请将密钥保存在服务器端的密钥管理中,切勿将其放在前端代码、公开仓库、日志行或屏幕截图中。该密钥与您的账户及套餐配额绑定,因此任何持有该密钥的人都会消耗您的请求配额。

# Paste your key from the dashboard, or load it from your secrets manager. Never commit it.
export WSA_API_KEY="..."

curl --get "https://ecom.webscrapingapi.com/v1" \
  --max-time 130 \
  --data-urlencode "engine=amazon" \
  --data-urlencode "api_key=$WSA_API_KEY" \
  --data-urlencode "type=search" \
  --data-urlencode "q=memory card"

本指南的其余部分基于下方的 Python 客户端。它从环境中读取密钥,根据后面将介绍的错误规则进行重试,并返回解析后的 JSON 以及调用的信用标头。使用 pip install requests.

# amazon_client.py
import os
import random
import time
from urllib.parse import urlencode

import requests

SCRAPER_URL = "https://ecom.webscrapingapi.com/v1"
RETRYABLE = {429, 500, 502, 503}


def redacted_url(params):
    """The request URL with the key hidden. Log this, never the real URL."""
    return f"{SCRAPER_URL}?{urlencode({'engine': 'amazon', 'api_key': '***', **params}, safe='*')}"


def amazon_get(params, retries=3, timeout=130):
    query = {"engine": "amazon", "api_key": os.environ["WSA_API_KEY"], **params}
    for attempt in range(retries + 1):
        resp = requests.get(SCRAPER_URL, params=query, timeout=timeout)
        if resp.status_code == 200:
            return resp.json(), resp.headers.get("Searchdata-Call-Credit-Usage")
        retry_422 = resp.status_code == 422 and attempt == 0  # retry a website error once
        if (resp.status_code not in RETRYABLE and not retry_422) or attempt == retries:
            raise RuntimeError(f"{resp.status_code} on {redacted_url(params)}: {resp.text[:200]}")
        wait = resp.headers.get("Retry-After", "")
        delay = int(wait) if wait.isdigit() else 2 ** attempt
        time.sleep(delay + random.random())  # exponential backoff with jitter
# first_request.py
from amazon_client import amazon_get

data, credits = amazon_get({"type": "search", "q": "memory card"})
results = data.get("search_results", {}).get("product_results", [])
print(len(results), "products; credits for this call:", credits)

在 Node.js 18 或更高版本中,相同的请求无需任何依赖项:

// amazon_request.mjs — run with: node amazon_request.mjs
const params = new URLSearchParams({
  engine: "amazon",
  api_key: process.env.WSA_API_KEY,
  type: "search",
  q: "memory card",
});

const res = await fetch(`https://ecom.webscrapingapi.com/v1?${params}`, {
  signal: AbortSignal.timeout(130_000),
});
if (!res.ok) throw new Error(`${res.status}: ${await res.text()}`);

const data = await res.json();
console.log("credits for this call:", res.headers.get("searchdata-call-credit-usage"));
console.log(data.search_results?.product_results?.length, "products");

带空格的关键词, &,或 + 必须遵循百分比编码规则。未编码的 & 会默认开始一个新参数,API 会以“不允许参数 '<name>'”为由拒绝该参数。curl 的 --data-urlencode、URLSearchParams 以及 Requests 的 params 参数都会自动为您进行编码。 每个示例还设置了 130 秒的超时,因此加载缓慢的页面不会导致工作线程挂起。

响应示例(摘自 API 文档,已精简):

{
  "search_parameters": {
    "amazon_url": "https://www.amazon.com/s?k=memory+card",
    "engine": "amazon",
    "amazon_domain": "amazon.com",
    "type": "search",
    "q": "memory card"
  },
  "search_information": {
    "organic_results_state": "Results for exact spelling",
    "total_results": "5,000",
    "query_displayed": "memory card"
  },
  "search_results": {
    "product_results": [
      {
        "position": 1,
        "product_id": "B08TJRVWV1",
        "title": "Amazon Basics microSDXC Memory Card with Full Size Adapter",
        "link": "https://www.amazon.com/dp/B08TJRVWV1",
        "price": "$12.42",
        "rating": { "rating": "4.7 out of 5 stars", "total_ratings": 33500 }
      }
    ]
  }
}

文档:访问 API

您可以使用哪些亚马逊请求类型?

将 type 设置为以下九个值之一:product 用于查询单个 ASIN;search 用于查询关键词;category、bestsellers、new-releases 或 todays-deals 用于查询类别 ID;seller_products、seller_profile 或 seller_feedback 用于查询卖家 ID。seller_feedback 即评论请求。 每种类型都需要各自的输入参数,并返回对应的行数据。

目标

type

必填输入

可选类型输入

行位于

部分

按ASIN显示一个商品(含评分和评分数量)

product

product_id

—

product_results (对象)

按 ASIN 排序的商品

关键词搜索结果

search

q

page, sort_by, filter_by

search_results.product_results

搜索结果

畅销榜排名

bestsellers

category_id

parent_alias

category_results.product_results

畅销书

新上架商品

new-releases

category_id

parent_alias

category_results.product_results

新书

浏览分类

category

category_id

page, sort_by

category_results.product_results

分类

今日特惠

todays-deals

category_id

—

category_results.product_results (新增 price_raw)

今日特惠

卖家的商品目录

seller_products

seller_id

page

search_results.product_results

卖家商品

卖家简介

seller_profile

seller_id

—

seller_profile (无商品列表)

卖家资料

评价(买家对卖家的评价)

seller_feedback

seller_id

page (每页5条)

seller_feedback (无商品列表)

评价

响应位置遵循文档中的示例。请审慎阅读。下面的解析器展示了具体方法。

有三个细节容易让人出错。deals 的值为 todays-deals,其中包含连字符和字母“s”。API 接受 seller 作为 seller_products的别名,但请写全值以确保日志可读性。此外, parent_alias 仅适用于畅销书和新书,在此处它指向一个子类别。

对于评论,请使用 seller_feedback 来收集评论行,并使用 product 用于获取 ASIN 的评分及评分数量。

文档:亚马逊搜索类型

如何通过 ASIN 抓取亚马逊商品?

发送 type=product 请求,并将 product_id 设置为 ASIN(即任何亚马逊商品 URL 中 /dp/ 后的十位字符 ID)。响应中的 product_results 对象包含商品标题、价格、评分、总评分、分类、图片和属性,以及亚马逊显示时的商品亮点。 添加 `amazon_domain` 参数,即可读取同一 ASIN 在其他亚马逊市场上的信息。

在 https://www.amazon.com/dp/B098RNZGNW中,ASIN是 B098RNZGNW。同一个ASIN通常存在于多个市场中,因此通过一个ID加上 amazon_domain 即可跨国家/地区比较同一商品。

curl --get "https://ecom.webscrapingapi.com/v1" \
  --max-time 130 \
  --data-urlencode "engine=amazon" \
  --data-urlencode "api_key=$WSA_API_KEY" \
  --data-urlencode "type=product" \
  --data-urlencode "product_id=B098RNZGNW" \
  --data-urlencode "amazon_domain=amazon.co.uk"
import re
from amazon_client import amazon_get

url = "https://www.amazon.com/dp/B098RNZGNW"
asin = re.search(r"/dp/([A-Z0-9]{10})", url).group(1)

data, _ = amazon_get({"type": "product", "product_id": asin})
item = data.get("product_results", {})
rating = item.get("rating", {})
print(item.get("title"), item.get("price"), rating.get("rating"), rating.get("total_ratings"))

响应示例(摘自 API 文档,已截取):

{
  "product_results": {
    "product_id": "B098RNZGNW",
    "title": "Example Amazon Product",
    "item_highlights": "Foldable card table for board games, dining, and extra seating",
    "price": "$59.99",
    "rating": { "rating": "4.6 out of 5 stars", "total_ratings": 12438 },
    "categories": ["Electronics", "Headphones"],
    "images": ["https://m.media-amazon.com/images/I/example-1.jpg"],
    "attributes": { "Brand": "Example", "Color": "Black" }
  }
}

price 是一个显示字符串,例如 "$59.99",因此请保留其原始域名,并在单独的步骤中解析其中的数字。 rating.rating 是文本,而 rating.total_ratings 是一个整数,可用于跨时间段比较。这是与卖家买家评价相匹配的商品级评价指标。 item_highlights 当亚马逊显示“无”时,该项将被省略。设置 wait_for_offers=true 当商品模块重要时,并 wait_for_video=true 用于视频模块。

字段覆盖范围因页面而异。“购买框”、商家、变体和库存详情取决于各商品页面的具体显示内容,因此在设计架构之前,请先针对您自己的 ASIN 检查一个具有代表性的样本。该样本也是价格和“购买框”监控的起点。

文档:亚马逊产品

如何抓取亚马逊搜索结果并进行分页?

发送 type=search 请求,并将 q 设置为关键词。产品数据将返回在 search_results.product_results 中,每条记录包含位置、ASIN、标题、链接、价格和评分,而 related_searches 则列出了亚马逊的搜索建议。 请求 page=2、3 及后续页面可获取更深入的结果,如需使用亚马逊自身的排序或 Prime 筛选功能,请使用 sort_by 或 filter_by=prime。

亚马逊搜索结果(即亚马逊搜索结果页面,SERP)显示了针对特定查询出现的商品及其排序顺序。 position 是该关键词、域名、页面及特定时刻在返回列表中的排名。将其与 q, amazon_domain, page, sort_by,并记录捕获时间,否则排名比较将失去意义。

curl --get "https://ecom.webscrapingapi.com/v1" \
  --max-time 130 \
  --data-urlencode "engine=amazon" \
  --data-urlencode "api_key=$WSA_API_KEY" \
  --data-urlencode "type=search" \
  --data-urlencode "q=memory card" \
  --data-urlencode "page=2" \
  --data-urlencode "filter_by=prime"

若要分页,请保持 q、域名和排序设置保持一致,并增加 page。每页都算作一次独立请求,因此请限制每个关键词的页面数:

from datetime import datetime, timezone
from amazon_client import amazon_get

rows = []
for page in range(1, 4):  # page cap: three pages per keyword
    params = {"type": "search", "q": "memory card", "page": page, "amazon_domain": "amazon.com"}
    data, _ = amazon_get(params)
    found = data.get("search_results", {}).get("product_results", [])
    if not found:
        break
    captured_at = datetime.now(timezone.utc).isoformat()
    rows += [{**params, "captured_at": captured_at, "position": r.get("position"),
              "product_id": r.get("product_id"), "price_text": r.get("price")} for r in found]
print(len(rows), "rows")

响应示例(摘自API文档,已截取):

{
  "related_searches": [
    { "query": "micro sd card", "link": "https://www.amazon.com/s?k=micro+sd+card" }
  ]
}

sort_by 接受 featured, price-asc-rank, price-desc-rank, review-rank, date-desc-rank,并 relevancerank. filter_by 接受 prime 和 climate-friendly。若需追踪位置,请在多次运行中保持这两项值不变。搜索页面还可以包含 top_sponsored, video_sponsored, pagination,以及 amazon_pagination。当这些参数存在时请读取它们,切勿自行假设其值。

如果您正在跟踪搜索排名随时间的变化,请将这些数据行与同一关键词的谷歌搜索结果进行对比。

文档:亚马逊搜索

如何抓取亚马逊畅销榜排名?

发送 type=bestsellers 并附带 category_id(可以是“电子产品”等别名,也可以是数字节点 ID),并添加 parent_alias 以访问子类别。 无键类别助手会根据关键词查询这两个值。排名产品将出现在 category_results.product_results 中,每条记录都包含亚马逊显示的排名位置、ASIN、标题、链接和价格。

只需三个步骤即可获取排名:

  1. 使用“categories”辅助函数查询分类(无需 API 密钥)。
  2. 传递其 category_id,并添加 parent_alias 作为子类别。
  3. 读取 category_results.product_results.
curl "https://amazon-helpers.webscrapingapi.com/categories?q=electronics&limit=3"

辅助函数响应(已截取):

[
  { "title": "Amazon Launchpad Top Electronics", "href": "/gp/new-releases/boost/23602499011", "parent_alias": "boost", "category_id": "23602499011" },
  { "title": "Electronics", "href": "/gp/new-releases/boost/21179674011", "parent_alias": "boost", "category_id": "21179674011" },
  { "title": "Electronics", "href": "/gp/new-releases/automotive/3248690011", "parent_alias": "automotive", "category_id": "3248690011" }
]

请按键名读取辅助函数的字段,因为名称可能与文档中的表格有所不同。诸如 electronics 无需查找即可使用:

curl --get "https://ecom.webscrapingapi.com/v1" \
  --max-time 130 \
  --data-urlencode "engine=amazon" \
  --data-urlencode "api_key=$WSA_API_KEY" \
  --data-urlencode "type=bestsellers" \
  --data-urlencode "category_id=electronics"

响应示例(摘自 API 文档,已截取):

{
  "category_results": {
    "product_results": [
      { "position": 1, "product_id": "B08C1W5N87", "title": "Fire TV Stick with Alexa Voice Remote",
        "link": "/fire-tv-stick-with-3rd-gen-alexa-voice-remote/dp/B08C1W5N87", "price": "$19.99",
        "rating": { "rating": "4.7 out of 5 stars", "total_ratings": 141438 } }
    ]
  }
}

position 是亚马逊在该时刻针对该类别的显示排名,因此请记录抓取时间,并在相同时间表下运行时进行比较。请注意相对 link:在存储此类路径前,请在路径前添加域名,这 absolute_link() 解析器部分会自动完成。

文档:亚马逊畅销榜

如何获取某类别的亚马逊新上架商品?

发送 type=new-releases 并附带一个 category_id(例如 fashion),若需子类别则添加 parent_alias,操作方式与畅销榜完全相同。 响应结果会在 `category_results.product_results` 中列出该类别下亚马逊的热门新书,包含排名、ASIN、书名、链接和价格。可按计划定期运行该请求,以查看哪些新书进入或退出榜单。

curl --get "https://ecom.webscrapingapi.com/v1" \
  --max-time 130 \
  --data-urlencode "engine=amazon" \
  --data-urlencode "api_key=$WSA_API_KEY" \
  --data-urlencode "type=new-releases" \
  --data-urlencode "category_id=fashion"

响应示例(摘自 API 文档;ASIN 为文档中的占位符):

{
  "category_results": {
    "product_results": [
      { "position": 1, "product_id": "B09EXAMPLE", "title": "New release product",
        "link": "https://www.amazon.com/dp/B09EXAMPLE", "price": "$29.99" }
    ]
  }
}

查找子类别 ID 及其 parent_alias 使用畅销榜部分的 categories 辅助函数。使用此请求进行新品追踪:每次运行仅针对一个类别和一个市场,且每次执行时间表保持一致。

文档:亚马逊新书

如何抓取亚马逊分类列表?

发送 type=category 并附带 category_id,可以是别名(如 amazon-devices),也可以是数字节点 ID。添加 page 参数可获取更深入的结果,使用 sort_by 参数可更改排序顺序。 商品数据将返回至 `category_results.product_results` 字段,包含位置、ASIN、标题、链接、价格和评分,因此您可以追踪整个浏览节点,而非仅限单个关键词。

curl --get "https://ecom.webscrapingapi.com/v1" \
  --max-time 130 \
  --data-urlencode "engine=amazon" \
  --data-urlencode "api_key=$WSA_API_KEY" \
  --data-urlencode "type=category" \
  --data-urlencode "category_id=amazon-devices" \
  --data-urlencode "page=2"

响应示例(摘自 API 文档,已精简):

{
  "category_results": {
    "product_results": [
      { "position": 1, "product_id": "B08C1W5N87", "title": "Fire TV Stick with Alexa Voice Remote",
        "link": "/fire-tv-stick-with-3rd-gen-alexa-voice-remote/dp/B08C1W5N87", "price": "$19.99",
        "rating": { "rating": "4.7 out of 5 stars", "total_ratings": 141438 } }
    ]
  }
}

类别请求会按亚马逊设定的排序返回浏览列表,而畅销榜请求则会返回按排名排序的畅销商品列表。 page 并且 sort_by 在此处适用,但 parent_alias 此处不适用。链接可以是相对路径,例如畅销榜中的情况。

文档:亚马逊分类

如何抓取亚马逊的“今日特惠”?

发送 type=todays-deals(而非 deals),并附上 category_id(例如 15684181)。 特价商品会出现在 category_results.product_results 中,每行包含 price(当前特价)和 price_raw(特价前的价格)。请将这两项与抓取时间一同保存,因为特价会随时间变化,后续请求可能会返回不同的列表。

curl --get "https://ecom.webscrapingapi.com/v1" \
  --max-time 130 \
  --data-urlencode "engine=amazon" \
  --data-urlencode "api_key=$WSA_API_KEY" \
  --data-urlencode "type=todays-deals" \
  --data-urlencode "category_id=15684181"

响应示例(摘自 API 文档,已截取):

{
  "category_results": {
    "product_results": [
      { "position": 1, "product_id": "B081T7N948", "title": "Cleaning Gel for Car",
        "link": "/Cleaning-Universal-Detailing-Automotive-Interior/dp/B081T7N948",
        "price": "$5.94", "currency": "$", "price_raw": "$9.99" }
    ]
  }
}

仅对解析后的数字计算折扣,在去除该域名的货币符号后,同时保留原始字符串:

deal, before = float(row["price"].lstrip("$")), float(row["price_raw"].lstrip("$"))
discount_pct = round((before - deal) / before * 100, 1)  # 40.5 for the sample row

优惠链接可能是相对路径,因此需通过 absolute_link().

文档:亚马逊优惠

如何列出卖家在亚马逊上销售的产品?

发送 type=seller_products 请求,并在 seller_id 中填写卖家的 ID。响应将在 search_results.product_results 中列出该卖家的店铺商品,包含位置、ASIN、标题、链接和价格,其结构与 search 请求相同。 添加 page 以获取更多结果。较短的别名 seller 同样有效,但建议使用 seller_products 以保持代码可读性。

请使用卖家店铺 URL 中显示的卖家 ID。

curl --get "https://ecom.webscrapingapi.com/v1" \
  --max-time 130 \
  --data-urlencode "engine=amazon" \
  --data-urlencode "api_key=$WSA_API_KEY" \
  --data-urlencode "type=seller_products" \
  --data-urlencode "seller_id=AAZRLVTNON75Z"

响应示例(摘自 API 文档,已截取):

{
  "search_results": {
    "product_results": [
      { "position": 1, "product_id": "B01NGTV4J5", "title": "Cascade Platinum Dishwasher Pods",
        "link": "https://www.amazon.com/dp/B01NGTV4J5", "price": "$38.88", "currency": "$" }
    ]
  }
}

由于这些行与搜索结果匹配,因此此处的解析和存储代码与搜索结果相同。请按每次运行存储这些数据,以便查看商家列出了哪些 ASIN 以及其显示价格。

文档:亚马逊卖家商品

如何获取亚马逊卖家的个人资料和评分?

发送 type=seller_profile 并附上 seller_id。seller_profile 对象将返回 seller_details,其中包含店铺名称、店铺链接、星级评分、总评分数及好评率,此外还有近期反馈的简短列表以及包含好评、中评和差评比例的反馈摘要。 该请求按卖家为单位,不包含商品列表,也不支持分页。

curl --get "https://ecom.webscrapingapi.com/v1" \
  --max-time 130 \
  --data-urlencode "engine=amazon" \
  --data-urlencode "api_key=$WSA_API_KEY" \
  --data-urlencode "type=seller_profile" \
  --data-urlencode "seller_id=AAZRLVTNON75Z"

响应示例(摘自 API 文档,已精简):

{
  "seller_profile": {
    "seller_details": { "name": "Triplenet Pricing INC", "store_link": "https://www.amazon.com/s?me=AAZRLVTNON75Z",
      "rating": 4, "ratings_total": 4078, "ratings_positive_percentage": 74 },
    "feedback": [ { "rating": 5, "body": "Great service", "rater": "By Sarah M. on July 24, 2023." } ],
    "feedback_summary": [ { "positive_percent": 75, "neutral_percent": 1, "negative_percent": 24, "count": 366 } ]
  }
}

利用卖家档案来审核竞逐“购买框”的第三方卖家,或对店铺进行审核 ratings_total 并 ratings_positive_percentage 每次查询来观察卖家的排名变化。 feedback 此处列出的是一份简短的近期样本。对于每行评价记录,请通过下方的卖家反馈请求逐页浏览。

文档:亚马逊卖家档案

如何通过卖家反馈请求抓取亚马逊评论?

发送 type=seller_feedback 并附上 seller_id。这是亚马逊 API 的评论请求:每行数据代表该卖家的一条买家评论,包含评分者、星级评分、评论内容、日期以及卖家是否回复等信息。 结果每页显示五条,因此请跟随 pagination.has_next_page 和 next_page 继续获取,直到达到您设定的页数上限。

curl --get "https://ecom.webscrapingapi.com/v1" \
  --max-time 130 \
  --data-urlencode "engine=amazon" \
  --data-urlencode "api_key=$WSA_API_KEY" \
  --data-urlencode "type=seller_feedback" \
  --data-urlencode "seller_id=AAZRLVTNON75Z" \
  --data-urlencode "page=2"

响应示例(摘自 API 文档,已截取):

{
  "seller_feedback": [
    { "rater": "Sarah M.", "rating": 5, "has_response": false, "body": "Great service",
      "date": { "raw": "July 24, 2023", "utc": "2023-07-24T04:00:00.000Z" }, "position": 1 }
  ],
  "pagination": { "current_page": 1, "has_next_page": true, "next_page": 2 }
}

每页都需单独发起请求,因此评论历史记录较长时请求次数会累积增加。当没有下一页或达到 max_pages:

# seller_feedback_pages.py
from amazon_client import amazon_get


def all_feedback(seller_id, max_pages=3):
    page, rows = 1, []
    while page and page <= max_pages:
        data, _ = amazon_get({"type": "seller_feedback", "seller_id": seller_id, "page": page})
        rows += data.get("seller_feedback", [])
        pagination = data.get("pagination", {})
        page = pagination.get("next_page") if pagination.get("has_next_page") else None
    return rows


reviews = all_feedback("AAZRLVTNON75Z")
print(len(reviews), "reviews")

商店 seller_id 和 date.utc ,并在每次运行之间对所有评论进行去重。 date.raw 遵循亚马逊的显示格式。将其与产品数据结合使用: type=product 可获取每个 ASIN 的评分及总评分数,因此这两次请求共同涵盖了评论数量、星级评分以及卖家评论文本。

文档:亚马逊卖家反馈

如何针对其他亚马逊域名、国家或邮政编码进行定位?

将 `amazon_domain` 设置为二十个受支持的市场之一,例如 `amazon.de` 或 `amazon.co.jp`。默认值为 `amazon.com`。添加 `delivery_location` 并使用国家代码(如 `de` 或 `gb`)来设置默认配送国家,或使用 `zip_code` 指定美国本地地址。 使用 hl 和 gl 分别指定语言和国家,并将每项设置及其结果记录下来。

亚马逊上的价格、库存和配送承诺取决于市场和配送地址,因此两个设置不同的调用结果无法直接比较。请定义一个小型市场网格(每个 ASIN 或关键词 × 每个域名 × 每个配送地点),并在每次运行中保持该网格设置不变。

地区

域名

美洲

amazon.com、amazon.ca、amazon.com.mx、amazon.com.br

欧洲

amazon.co.uk、amazon.de、amazon.fr、amazon.it、amazon.es、amazon.nl、amazon.pl、amazon.se、amazon.com.tr

中东和非洲

amazon.ae、amazon.sa、amazon.eg

亚太地区

amazon.co.jp、amazon.in、amazon.sg、amazon.com.au

所有这些通用参数均为可选:

参数

功能说明

取值

amazon_domain

要读取的亚马逊市场

上述 20 个域名之一;默认值为 amazon.com

delivery_location

默认配送国家/地区

us, de, gb, ca, fr, jp, cn, au, es, br, in, mx

zip_code

本地配送地址上下文

邮政编码

hl / gl

语言/国家

语言和国家代码

page

结果页面

整数

sort_by

按搜索或分类结果排序

精选、价格升序排名、价格降序排名、评论排名、日期降序排名、相关性排名

filter_by

筛选结果

Prime、环保

scroll_to_bottom

提取前滚动整页

true / false(false 速度更快)

wait_bottom_carousel

等待滚动条到达底部

true / false(false 速度更快)

lazy_loading

页面加载后额外等待

毫秒

wait_for_offers / wait_for_video

在产品页面上等待优惠或视频模块加载

true / false

delivery_location 仅接受所列出的十二个代码,因此并非每个域名都有对应的值。没有 it 或 nl等选项。当您不需要页面底部的模块时,请将 scroll_to_bottom=false 和 wait_bottom_carousel=false 以加快响应速度。当页面加载后仍需更多处理时间时,请使用 lazy_loading ,当页面加载后需要更多时间时。

在 Node.js 中,市场设置是 URLSearchParams:

const params = new URLSearchParams({
  engine: "amazon",
  api_key: process.env.WSA_API_KEY,
  type: "search",
  q: "memory card",
  amazon_domain: "amazon.de",
  delivery_location: "de",
});

文档:支持的域名

如何读取和存储 JSON 响应?

首先处理 `search_parameters`(该字段会回显您的请求以及获取的亚马逊 URL)和 `search_information`。然后根据类型,从 `search_results`、`category_results`、单个 `product_results` 对象、`seller_profile` 或 `seller_feedback` 中读取数据行。 将其他模块视为可选,保留原始价格字符串及其所属域名,并将每行数据与其请求设置一同存储。

文档中的描述和示例有时会将商品放置在不同的键下。分类页面的文本写道 product_results,而其示例却将其嵌套在 category_results,而卖家商品页面的说明中则将 seller_results,而其示例则使用 search_results。因此,解析器会检查文档中记录的所有位置,并返回一个空列表,而非导致程序崩溃。将其添加到 amazon_client.py:

def product_rows(data):
    """Return the product list wherever this request type puts it."""
    for container in ("search_results", "category_results"):
        rows = (data.get(container) or {}).get("product_results")
        if isinstance(rows, list):
            return rows
    single = data.get("product_results")
    return [single] if isinstance(single, dict) else []


def absolute_link(link, amazon_domain="amazon.com"):
    """Category-style responses can return relative links such as /Item/dp/ASIN."""
    if not link or link.startswith("http"):
        return link
    return f"https://www.{amazon_domain}{link}"

product_rows() 会返回所有七种包含产品的类型的行。阅读 seller_profile 和 seller_feedback 按其各自的键进行处理,如相关章节所述。然后将每个产品展平为一行存储数据:

# store.py
from datetime import datetime, timezone
from amazon_client import absolute_link, product_rows


def to_records(data, request):
    """One flat row per product, with the request settings that produced it."""
    captured_at = datetime.now(timezone.utc).isoformat()
    domain = request.get("amazon_domain", "amazon.com")
    amazon_url = (data.get("search_parameters") or {}).get("amazon_url")
    for row in product_rows(data):
        rating = row.get("rating") or {}
        yield {
            "captured_at": captured_at,
            "type": request["type"],
            "input": request.get("q") or request.get("category_id")
                     or request.get("seller_id") or request.get("product_id"),
            "amazon_domain": domain,
            "delivery_location": request.get("delivery_location"),
            "page": request.get("page", 1),
            "position": row.get("position"),
            "product_id": row.get("product_id"),
            "title": row.get("title"),
            "price_text": row.get("price"),
            "rating_text": rating.get("rating"),
            "total_ratings": rating.get("total_ratings"),
            "link": absolute_link(row.get("link"), domain),
            "amazon_url": amazon_url,
        }

同时保留原始响应,以便在添加字段时可以重新处理它。区分失败的请求(HTTP 错误)和因缺少模块而成功的请求(空列表)。后者是一种现象,并非错误。有关更多模式,请参阅《Python 中解析 JSON 响应》。

定价页面列出了每个套餐的 JSON、CSV 和 HTML 输出格式。亚马逊文档描述了 JSON 响应,因此本指南通篇使用 JSON。

您的代码应如何处理错误、重试和信用额度使用?

请勿重试 401 错误或验证错误。应修正密钥、订阅或参数。 对于 429、500、502 和 503 错误,应采用指数退避和抖动策略重试几次,并在遇到 429 错误时降低并发度。422 错误表示亚马逊返回了错误、挑战或超时,因此仅当故障看起来是暂时的时,才重试一次。

状态

正文或结构

含义

操作

401

Access denied. No key api_key provided.

未发送密钥

修正配置;不要重试

401

Access denied. Invalid api_key provided. 或 Authentication failure: …

密钥无效,或该密钥无权访问 Amazon API

请检查密钥和订阅;不要重试

验证错误

Parameter '<name>' not allowed. 及类似错误

以下参数错误或缺失 engine=amazon

修正请求;请勿重试

422

error_type: "website"

Amazon 返回了错误、挑战、无效的请求体或超时

若为临时性问题,请重试一次

429

{"error":"max_concurrent_connections"}

达到并发限制

降低并发数,延迟重试

500 / 503

Internal Server Error / other_failure

API 暂时性故障

采用抖动退避策略重试几次

没有键的请求会返回此正文并伴随 HTTP 401 状态码:

{ "error": "Access denied. No key `api_key` provided." }

其他验证消息包括 Parameter '<name>' is required., must be a boolean, must be in range,以及 cannot be used with。这些表示请求本身有误,因此重试也无济于事。如果 /v1 请求返回“此端点已弃用。请使用 /v2.”,则说明您的密钥未订阅该 Amazon API。请在控制台中进行订阅,而非切换端点。

amazon_get() 实现了此策略。它对 HTTP 429 和 5xx 响应采用指数退避加随机抖动的方式重试,若存在数值型 Retry-After 头则予以遵守,对 422 响应重试一次,对于其他所有情况则抛出异常(同时屏蔽密钥)。 若多次收到 429 响应,还应减少并行工作进程的数量。

每次调用时记录两个标头: Searchdata-Call-Credit-Usage (本次调用消耗的积分) 和 Searchdata-Current-Credit-Usage (您账户的当前使用量)。一周的日志记录可显示哪些类型和市场占用了您的配额。

文档:错误与标头

Amazon Scraper API 的费用是多少?

截至 2026 年 10 月,试用版提供 100 次亚马逊请求,费用为 0 美元。 付费套餐按月计费:“入门版”59 美元可进行 10,000 次请求,“成长版”375 美元可进行 250,000 次请求,“商业版”1,000 美元可进行 1,000,000 次请求,“专业版”2,200 美元可进行 2,500,000 次请求。 所有套餐均涵盖亚马逊所有域名、商品及评论API、搜索和分类结果,以及畅销榜。

套餐

价格

亚马逊请求量

每 1,000 次请求的实际费用

试用

0美元

100

—

入门版

59美元/月

10,000

5.90

成长

375 美元/月

250,000

1.50

商业

1,000 美元/月

1,000,000

1.00

专业版

每月 2,200 美元

2,500,000

0.88

所有套餐均包含所有亚马逊域名、产品和评论API、搜索和分类结果、畅销榜API,以及JSON、CSV和HTML输出功能,并支持批量处理。价格以美元计。在本指南中,产品和评论API指的是 product 和 seller_feedback 请求。

根据实际输入数据而非猜测来确定套餐规格:

每月请求量 = 输入项(ASIN、关键词、类别、卖家)× 域名数 × 配送地点数 × 每项输入的页面数 × 每月运行次数,再加上用于测试和重试的余量

例如,400 个 ASIN × 2 个域名 × 1 页 × 每周 4 次运行,共计 3,200 次请求,这符合“入门版”的配额。 若再增加 50 个关键词 × 2 个域名 × 3 个页面 × 每天 3 次运行,即增加 9,000 次请求,总计 12,200 次请求已超出“入门版”的配额,因此应选择“成长版”。 价格和配额会发生变化,因此定价页面才是权威信息来源。还在选择服务商吗?请参阅我们的亚马逊数据抓取 API 对比指南。

亚马逊 API 无法实现哪些功能?何时应选择其他方案?

亚马逊 API 仅支持其参考文档中列出的九种页面类型,且仅限于此。该 API 不支持亚马逊异步任务,字段覆盖范围因页面而异,且每个结果仅描述一个域名、一个位置和一个时间点。对于其他页面、其他市场或现成的数据集,请使用 Scraper API、其他 Data API 数据源或托管数据源。

  • 超出这九种类型的页面。请为此类页面申请样本,或以 HTML 格式获取页面。请参阅如何使用 Scraper API。
  • 您更倾向于自行构建。若要自行运行和维护爬虫,请参考 Python 版亚马逊爬虫的实践指南。
  • 您需要的是数据记录,而非请求。若需预处理过的、定期更新的亚马逊数据,请查看亚马逊产品数据集。
  • 您需要其他电商平台。Data API 还涵盖其他零售商,例如沃尔玛的产品数据。
  • 亚马逊不支持异步任务。每次调用均为同步操作,因此请根据上述重试策略自行运行任务队列。
  • 字段因页面而异。在确定数据结构之前,请先检查一个具有代表性的样本。
  • 使用受限。请仅收集公开页面,并遵守 WebScrapingAPI 的《服务协议》以及适用于您的相关要求。

常见问题

是否有免费的亚马逊数据抓取 API 试用版?

有。截至 2026 年 10 月,WebScrapingAPI 的亚马逊 API 试用套餐费用为 0 美元,包含 100 次亚马逊请求,足以让您根据自身需求测试产品、搜索、畅销榜和卖家相关请求。 请创建一个账户,在仪表盘中订阅亚马逊 API,并在评估期间将密钥保存在环境变量中。

什么是 ASIN,在哪里可以找到它?

ASIN 是亚马逊的十位字符产品标识符,亚马逊 API 将其用作 product_id。您可以在产品 URL 的 /dp/ 之后找到它,或者在产品页面的“产品信息”或“附加信息”部分中找到。同一 ASIN 在不同的亚马逊域名上可能显示不同的价格和库存情况。

如何抓取亚马逊畅销榜排名?

发送 type=bestsellers 并附带一个 category_id(例如 electronics),若需获取子类别,请添加 parent_alias。 无键分类助手可根据关键词同时获取这两个值。结果将以 category_results.product_results 的形式返回,其中包含亚马逊显示的排名位置、ASIN、标题、链接、价格和评分,因此请将抓取时间与每行数据一同存储。

该 API 支持哪些亚马逊市场?

该 API 支持二十个亚马逊域名:美国、加拿大、墨西哥、巴西、英国、德国、法国、意大利、西班牙、荷兰、波兰、瑞典、土耳其、阿联酋、沙特阿拉伯、埃及、日本、印度、新加坡和澳大利亚。 请将 `amazon_domain` 设置为其中一个,当配送情境导致亚马逊显示内容发生变化时,请使用 `delivery_location` 或 `zip_code`。

我可以通过浏览器 JavaScript 调用亚马逊 API 吗?

请勿这样做。浏览器请求会将您的 API 密钥暴露给任何打开开发者工具的人,而该密钥控制着您的套餐配额。请通过服务器、无服务器函数或定时任务调用 API,从环境变量或密钥管理器中读取密钥,并仅将解析后的结果发送给前端。

如何分页浏览亚马逊搜索结果?

在 type=search 请求中添加 page=2、page=3 及后续参数,同时保持 q、domain 和排序设置不变。每页都会消耗您的配额,因此请为每个关键词设置页面上限。将页码与每行数据一同存储,以便日后能重建该关键词的完整排名。

Amazon API 能抓取评论吗?

可以。发送 type=seller_feedback 并附带 seller_id,即可收集某卖家的买家评论,每页五条,每条包含评价者、星级评分、评论内容、日期以及卖家是否回复。若需获取产品级别的评论数据,type=product 可返回每个 ASIN 的评分及总评分数量。 请跟踪 pagination.has_next_page 以读取所有页面。

为什么我的请求返回“参数不允许”?

API 会根据亚马逊引擎对每个参数进行验证,并拒绝不被接受的参数名称。常见原因包括:参数名称拼写错误或大小写不正确、来自其他引擎的参数,或者关键词中未编码的“&”符号导致其被拆分为新参数。请修正请求内容,而非直接重试。

如何了解请求消耗了多少积分?

请查看响应头中的 `Searchdata-Call-Credit-Usage`(报告该调用所消耗的积分)和 `Searchdata-Current-Credit-Usage`(报告您账户的当前使用情况)。 请将这两项信息连同请求类型、输入内容和域名一并记录。通过一周的日志,您可以了解哪些请求类型和市场消耗了您的配额,以及您的套餐是否仍符合需求。

不编写代码也能获取亚马逊数据吗?

可以,前提是有现成的数据源能满足您的需求。在您查看了页面、字段和市场的样本数据后,WebScrapingAPI 可以按计划将亚马逊记录作为数据集或托管集合交付。该 API 适合希望自行选择输入内容和时间的团队,而托管数据源则适合仅需定期获取文件的分析师。

从 100 次免费亚马逊请求开始

亚马逊抓取 API 可从 20 个亚马逊市场中提取产品、搜索、分类、畅销榜、优惠、卖家及卖家评论页面,并以结构化 JSON 格式返回,同时为您处理解析器的维护工作。当您确定了 ASIN、关键词、市场和刷新计划后,请对比亚马逊 API 套餐并选择适合的配额。

关于作者

Robert Sfichi, 全栈开发工程师 @ WebScrapingAPI

Robert Sfichi

全栈开发工程师

罗伯特·斯菲奇是 WebScrapingAPI 的团队成员,致力于产品开发,并协助构建可靠的解决方案,以支持该平台及其用户。

开始构建

准备好扩展您的数据收集规模了吗?

加入2,000多家企业,使用WebScrapingAPI在无需任何基础设施开销的情况下,以企业级规模提取网络数据。