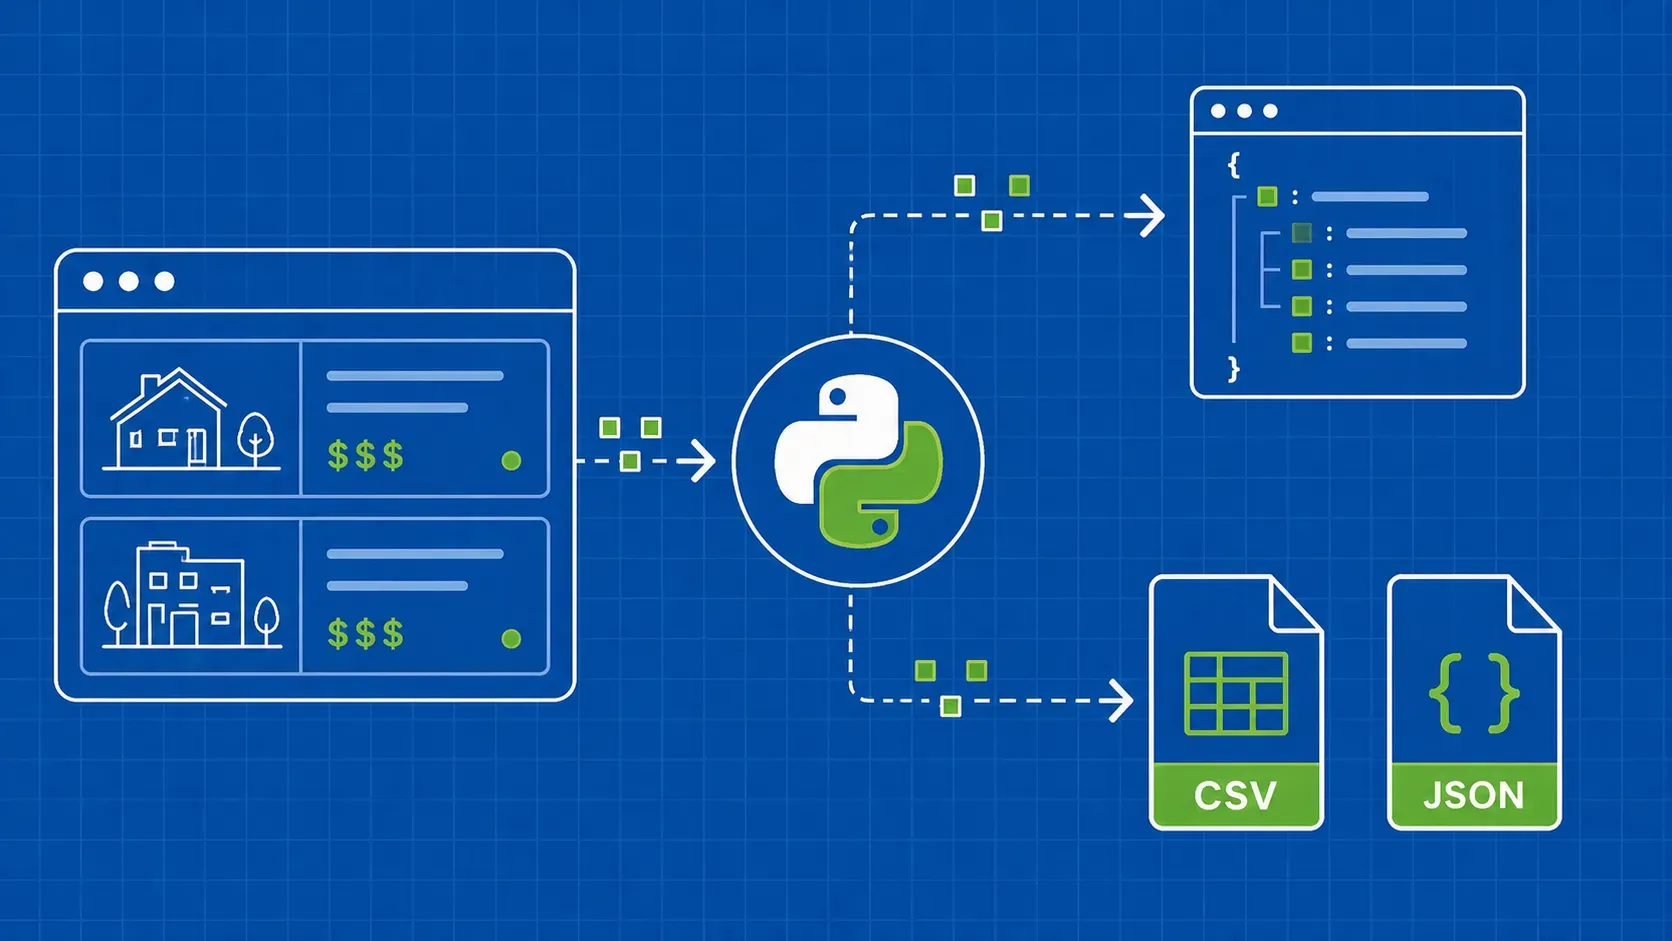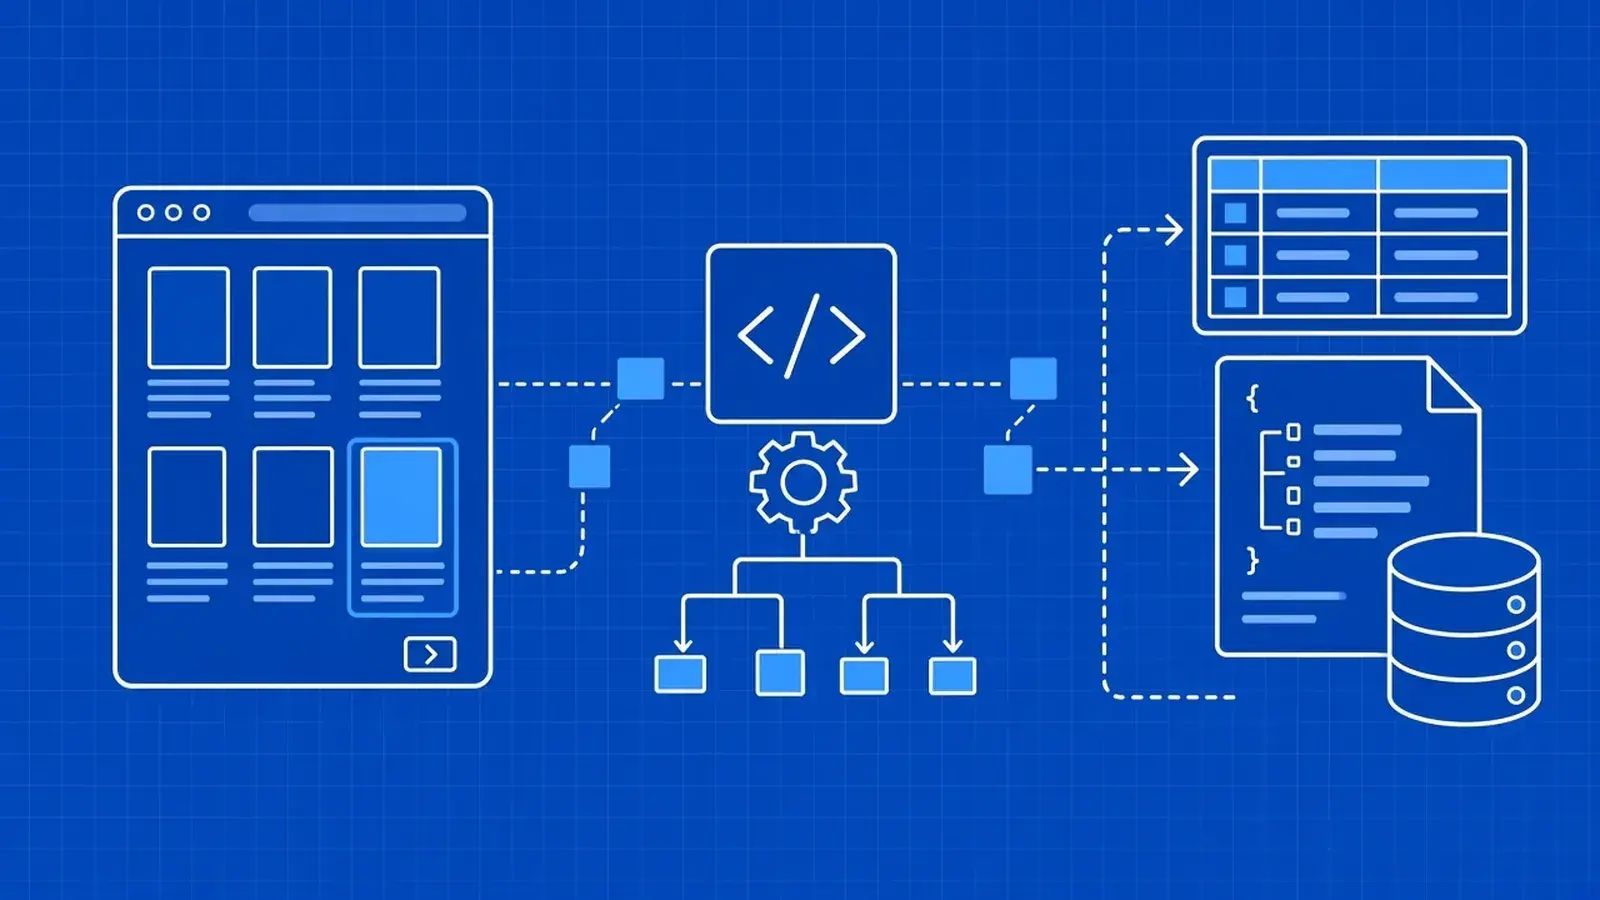
简而言之:在 C 和 C++ 中进行网页抓取,请用 libcurl 下载网页,用 lexbor 通过 CSS 选择器解析 HTML5;两者都是纯 C 库,因此一套技术栈即可同时服务两种语言。当爬虫位于原生代码库中、运行在资源受限的硬件上,或需要解析大量 HTML 时,请选择 C++。对于快速的一次性任务,用 Python 编写更快。
本指南将向您展示如何使用两种可移植的 C 语言库(而非 C#)用 C 和 C++ 抓取网站:libcurl 用于下载网页,lexbor 用于通过 CSS 选择器解析 HTML5。这两者都是纯 C 语言实现的,因此一套运行环境即可同时支持这两种语言。它们在 Windows、macOS 和 Linux 上的安装方式也完全相同。
您将构建一个用于公共练习书店“Books to Scrape”的 C++20 爬虫。该爬虫支持分页,通过小型线程池访问每个产品页面,并保存经过清理的 CSV 和 JSON 文件。 随后,你将通过三种方式处理 Quotes to Scrape 网站上的 JavaScript 页面:直接从 script 标签中读取数据、使用无头 Chrome 渲染页面,以及交由爬取 API 处理。 最后,你将再次看到作为纯 C 程序的核心爬虫。CMake 和 vcpkg 将根据单一清单文件完成所有构建工作。
你将构建的内容:
- 一个能够礼貌地沿列表页面中的“下一页”链接进行爬行的爬虫。
- 一个产品页面处理步骤,利用四个工作线程添加 UPC 码和库存数量。
- 支持 RFC 4180 标准的 CSV 及有序 JSON 导出,价格以整数形式呈现。
- 从 JavaScript 页面获取数据的 3 种方法。
- 基于同一组两个库构建的纯 C17 爬虫。
想改用 C# 吗?我们的 C# 网页抓取指南涵盖了 HttpClient、AngleSharp 以及 .NET 版的 Playwright。