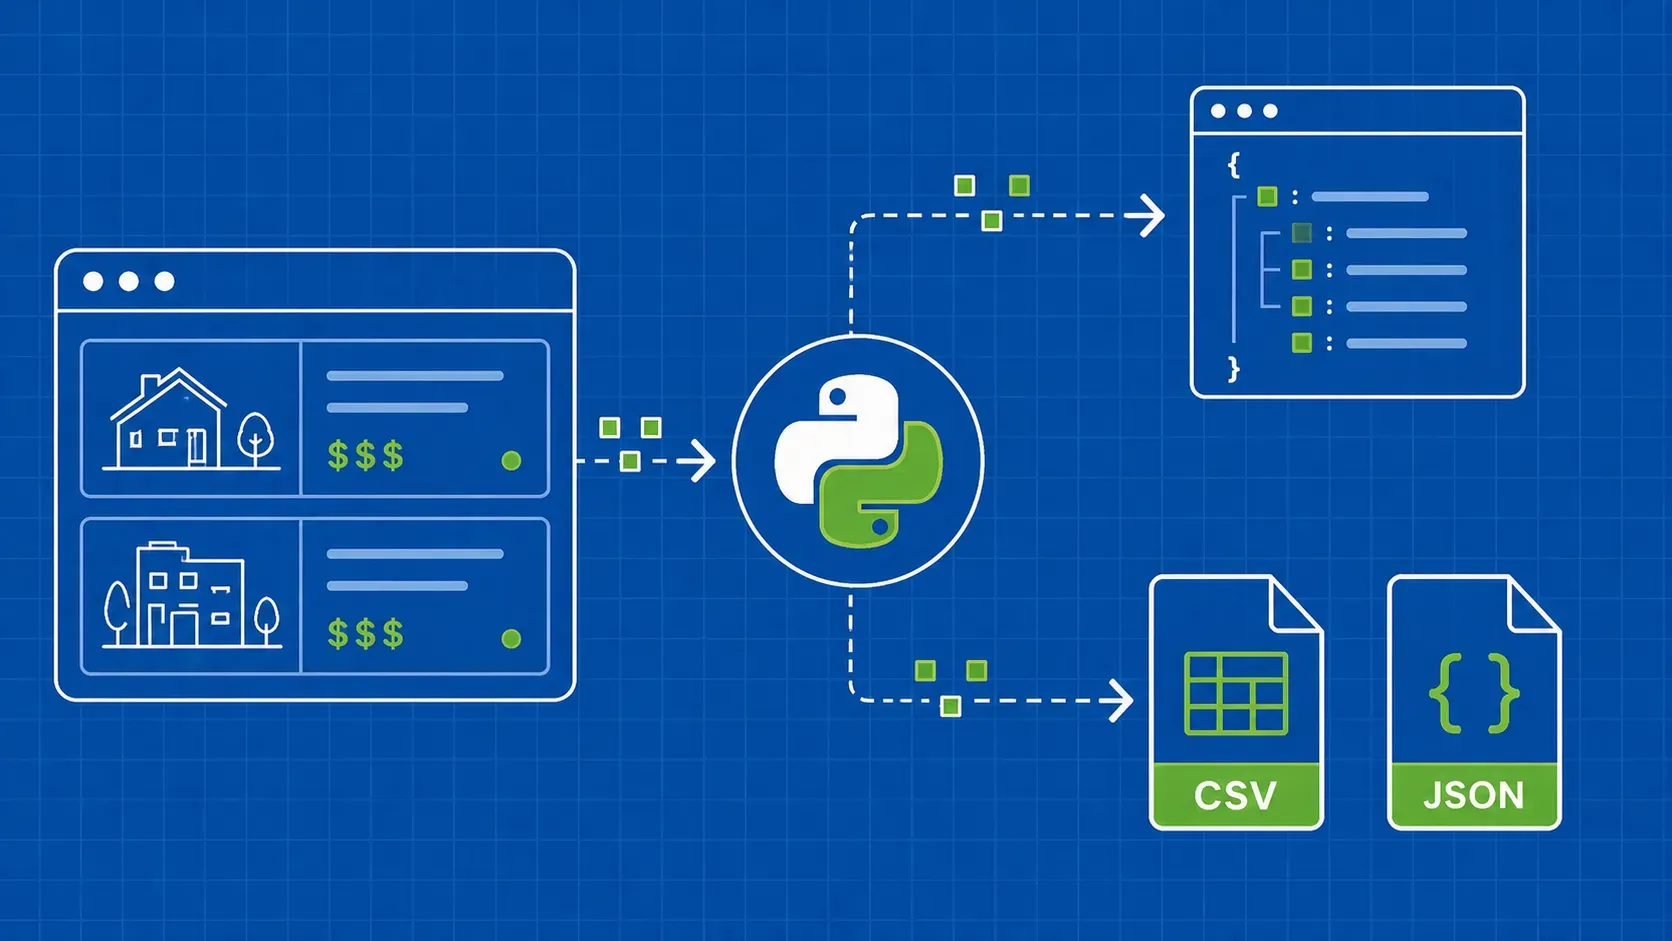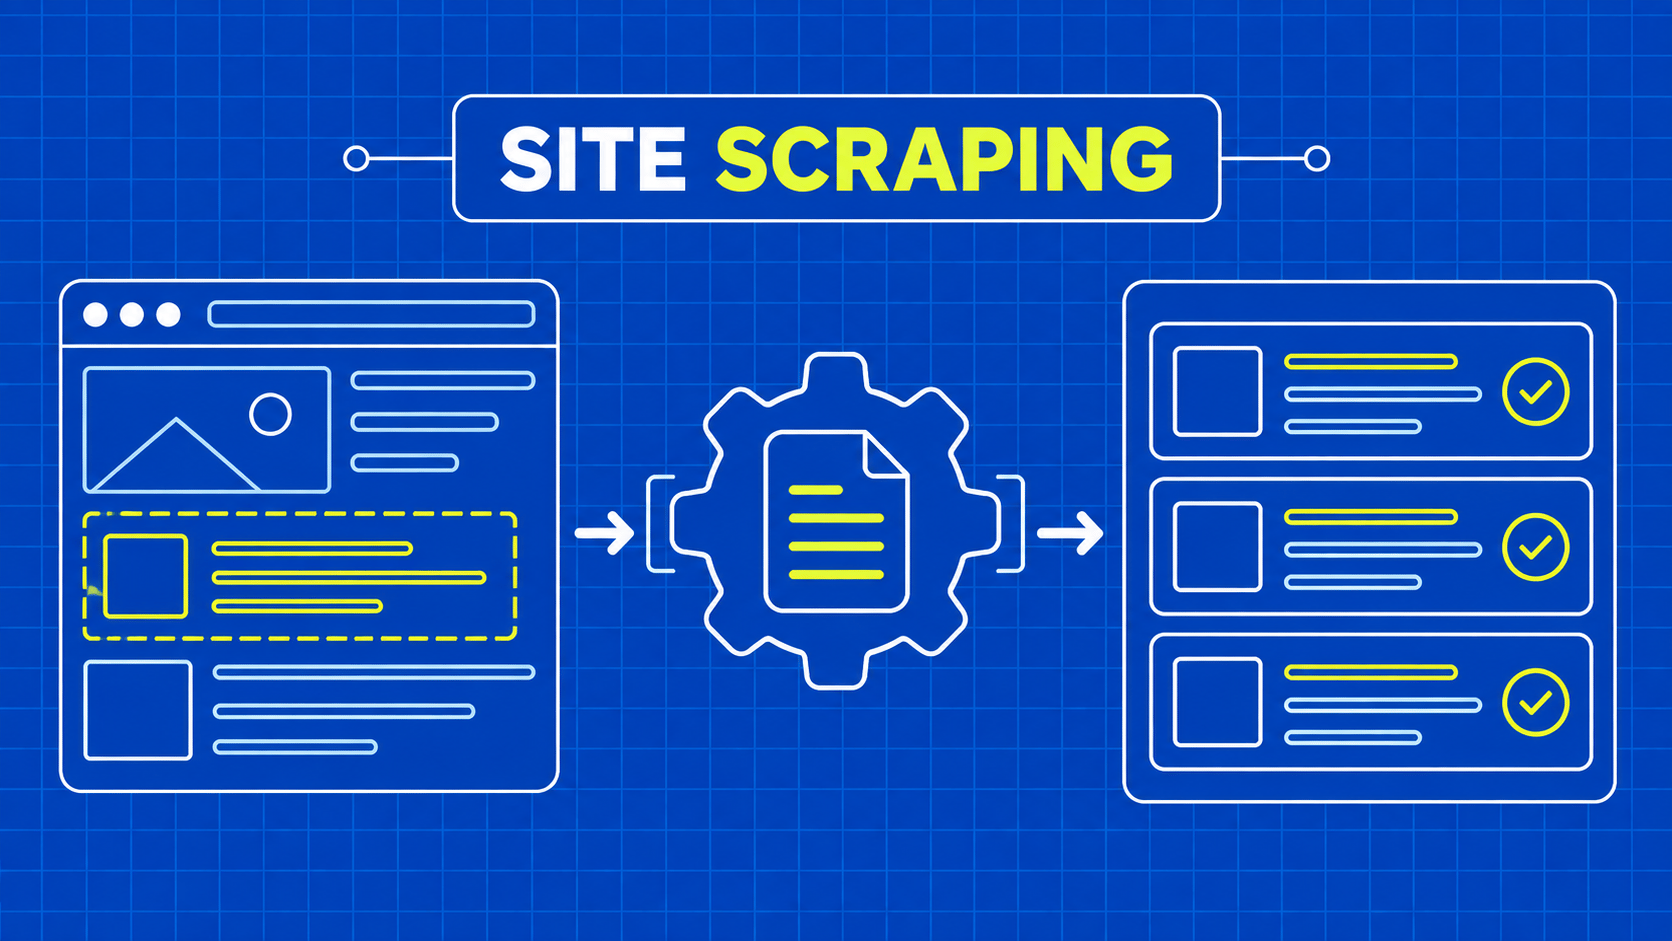
简而言之:一个实用的网站爬虫工具会将一组经过批准的页面转换为具有明确含义的记录,对这些记录进行验证,并输出可识别的批量数据。首先确定记录和采集范围,选择一种能够获取数据的执行模型,并在安排任务前测试导航功能、缺失值处理及恢复机制。
假设你需要从一个获准采集的网站中获取每周更新的组织名录。每行应包含名称、地址、来源 URL 以及观察时间。网站爬虫是一种软件工作流,它会访问相关页面并提取这些字段,但一个可靠的采集器还会检查生成的行是否可用。
从单个页面提取文本只是第一步。您必须确定哪些页面属于采集范围,判断多个条目是否描述同一组织,决定如何表示缺失的地址,以及当下次运行中途停止时,用户应如何应对。这些决策将决定输出结果能否支持报表或应用程序功能。
本指南以该目录为例,从数据记录设计到交付进行全流程说明。这是一份实用的设计与选型指南,而非对可互换产品的排名。无论您选择可视化工具、基于 HTTP 的采集器还是浏览器自动化工具,只要所选实现方案能提供您的工作流所需的控制和验证机制,均可应用此方法。
请从一个经批准的小型样本开始,确保有人能够对其进行人工验证。只有在采集器能够说明其访问了哪些页面、接受了哪些内容以及哪些内容尚不明确之后,才应进行扩展。