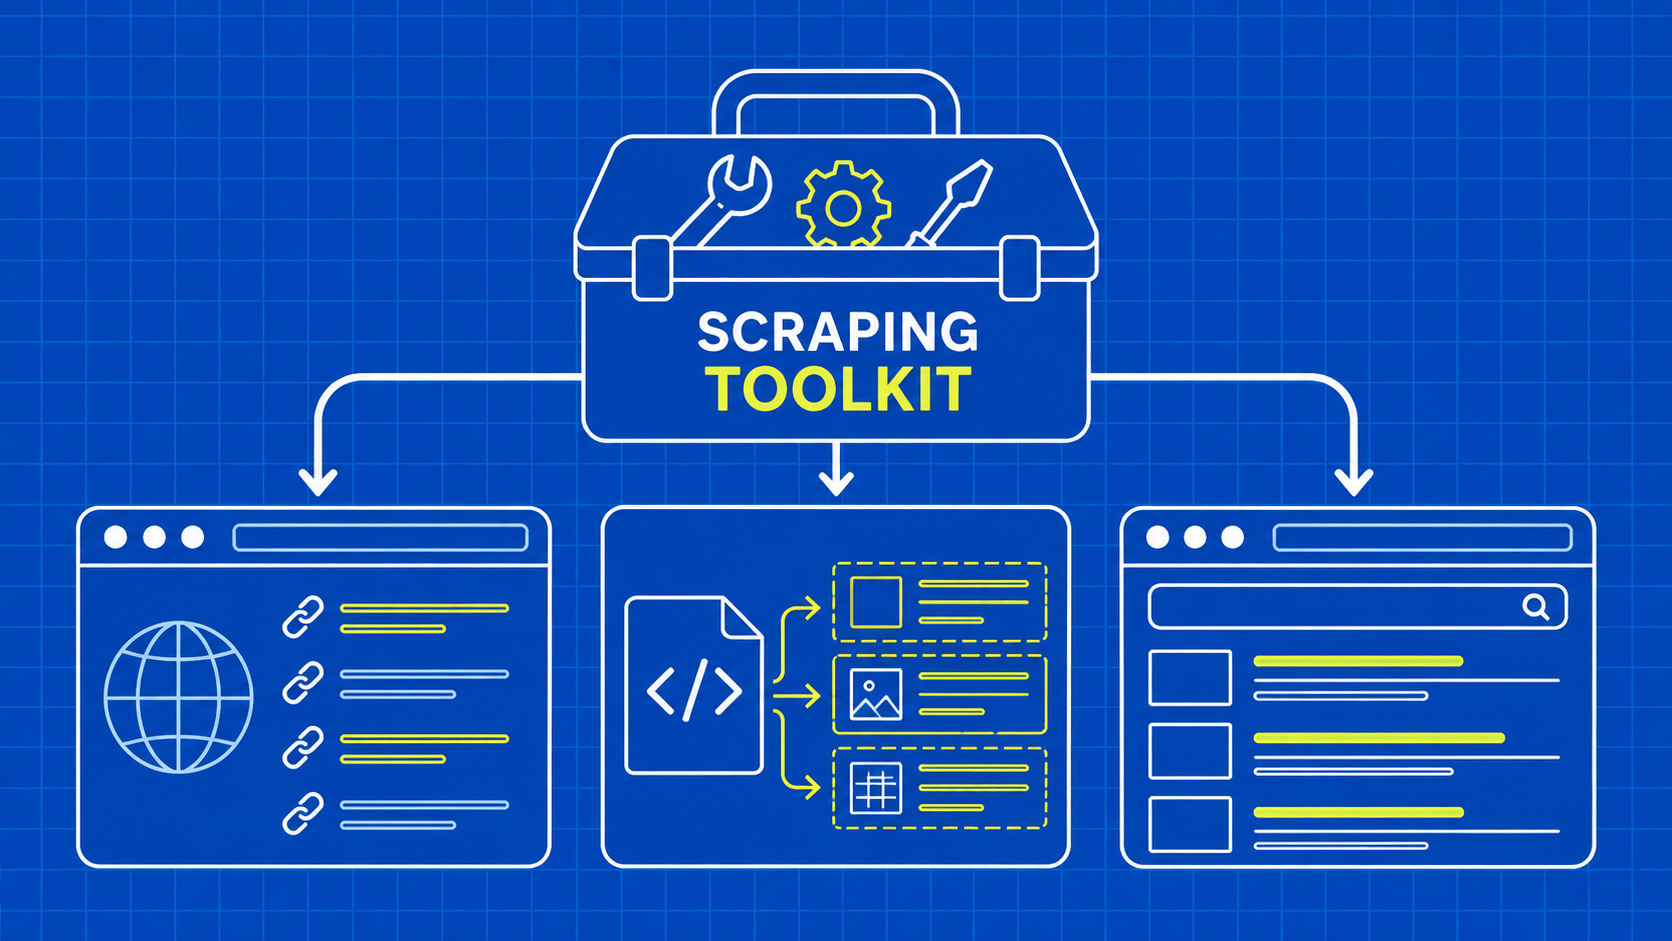
简而言之:选择 Screaming Frog 进行网站审计数据提取,使用 Scrapy 构建自定义的周期性爬虫,采用 Playwright 处理浏览器交互,利用 Web Scraper 进行可视化数据提取,并借助 OpenRefine 清理收集到的数据。这些工具分别负责工作流中的不同环节;应根据所需输出结果进行评估,而非指望单一应用程序能涵盖所有功能。
Scrapebox 的替代方案,是用来替代你当前执行的特定爬取、数据提取、网站审计或列表处理任务的工具。关键问题在于:哪些功能需要被替代,以及变更完成后由谁来操作这些工具。
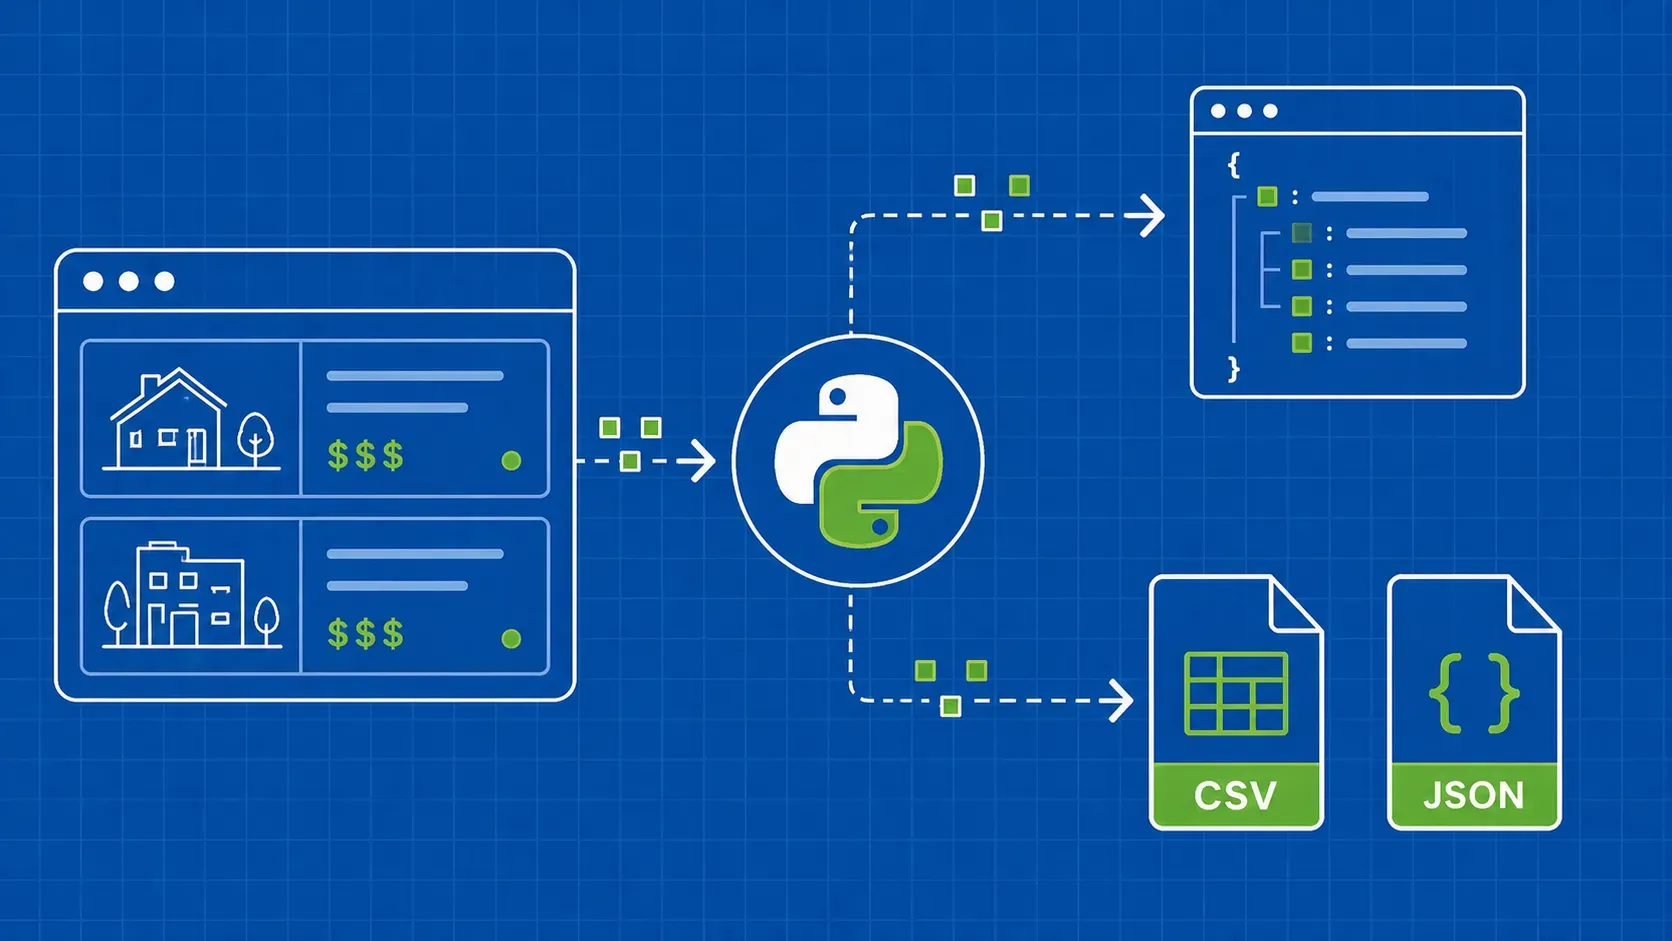
假设您现有的工作流从一个 URL 列表开始,提取页面标题和产品属性,删除重复条目,并导出报告。即使目前由一个桌面应用程序处理这些任务,数据采集、清理规则和报告生成也是各自独立的职责。若试图一次性迁移这三部分,可能会导致简单的工具替换变得出乎意料地困难。
本指南对比了五种经过验证的合法数据采集与分析方案。它不会根据无法量化的速度对它们进行排名,也不会强行推举一个“万能赢家”。技术性SEO审计与基于浏览器的产品工作流有着不同的需求,因此它们的最佳切入点可能各不相同。
您将梳理当前任务,筛选出合适的替代方案,并在淘汰旧流程前验证生成的记录。重点在于通过可重复处理的方式获取有用的数据,而非为了增加数据收集量而增加数据收集量。