Playwright Web Scraping:Python 和 Node.js 完全指南
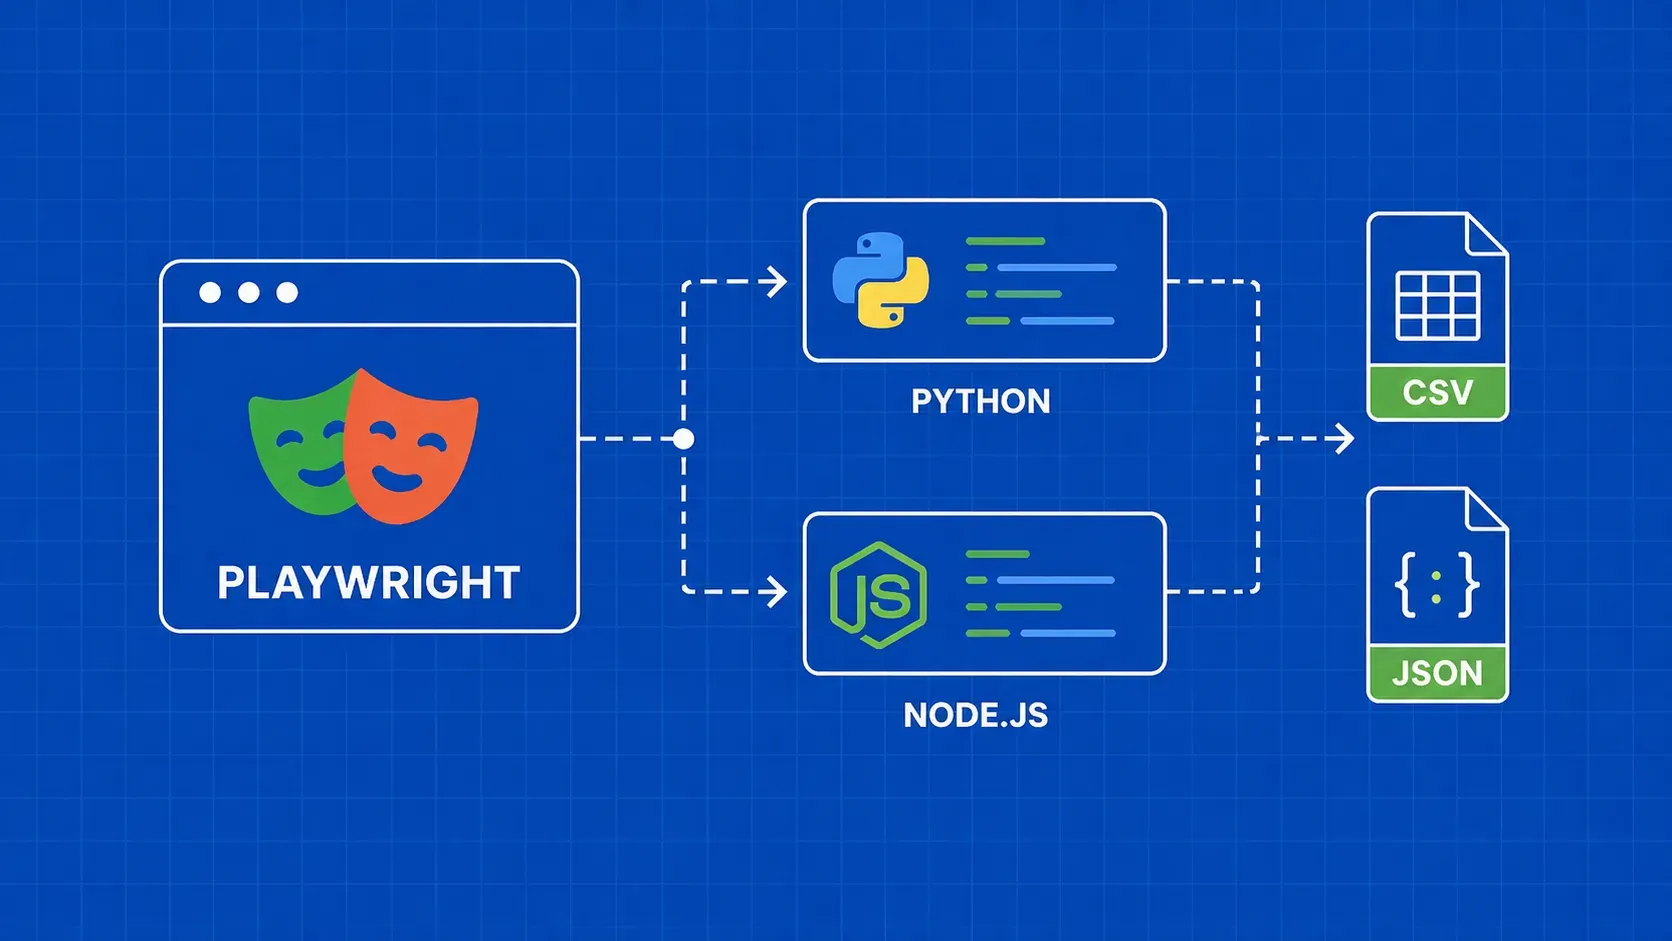
TL;DR: 简要说明:Playwright 为您提供了全面的浏览器自动化功能,可用于刮擦 JavaScript 繁重的网站,并为 Python 和 Node.js 提供一流的支持。本指南将指导您完成安装、元素提取、代理配置、反检测、分页、图片下载以及将数据导出为 CSV 或 JSON 等操作,并提供两种语言的并行代码示例。
Blog
深入探讨网络数据基础设施、数据提取技术以及大规模结构化数据的未来。
156 文章

TL;DR: 简要说明:Playwright 为您提供了全面的浏览器自动化功能,可用于刮擦 JavaScript 繁重的网站,并为 Python 和 Node.js 提供一流的支持。本指南将指导您完成安装、元素提取、代理配置、反检测、分页、图片下载以及将数据导出为 CSV 或 JSON 等操作,并提供两种语言的并行代码示例。

TL;DR: 简要说明:要想知道如何从 Google 地图中抓取评论,有三种方法:旋转代理后的 DIY Selenium 抓取器、带有渲染说明的抓取 API 或返回解析 JSON 的结构化地图评论 API。本指南用 Python 演示了这三种方法,包括可复制粘贴的代码、分页模式、防拦截策略,以及将原始评论转化为企业可实际使用的内容的最后清理步骤。

TL;DR: 学习用 urllib、requests 和 aiohttp 在 Python 中下载文件:流式下载、进度条、并行与异步下载、重试以及身份验证。

TL;DR: 简要说明:本指南从头到尾介绍了如何在 Python Requests 中使用代理:一个有效的代理字典、经过验证的 URL、环境变量、会话重用、不泄漏 DNS 的 SOCKS5 以及带有重试和断路器的轮换池。到最后,你就会知道什么时候托管 API 比 DIY 池更有价值。

TL;DR: 了解如何使用 Node.js 配合我们的 API 抓取 Google 地图的地点结果:分步指南、专业抓取工具的优势等。轻松获取 data_id、坐标以及构建数据参数。

TL;DR: 简而言之:当您需要从您已经信任的 HTML 中提取简短、可预测的文本模式(价格、SKU、电子邮件、日期)时,使用 regex 进行 Web scraping 就会大显身手。将 Python 的 re 模块与 Beautiful Soup 搭配使用,将模式范围扩大到解析的节点而不是原始标记,让 regex 远离完整的 HTML 树解析。本指南将介绍标题和价格搜索器的工作原理、高级 regex 功能,以及真正的搜索器在生产中会遇到的陷阱。