
工程
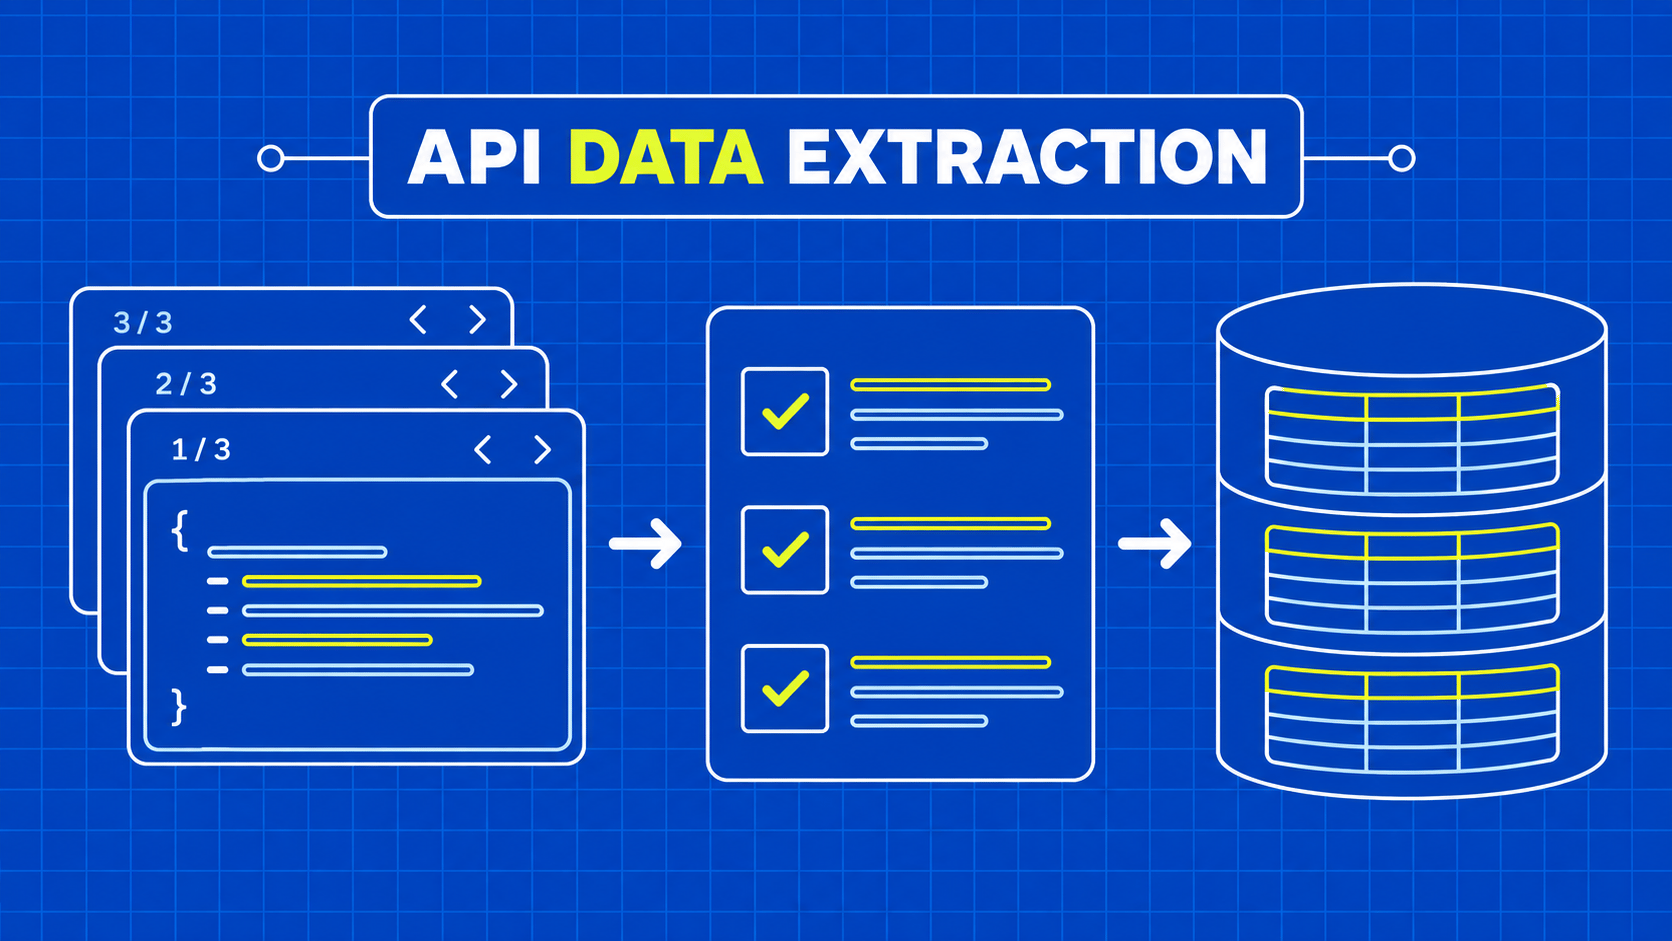
从 API 中提取数据:一个可靠的第一条数据处理管道
TL;DR: 构建一个 API 提取工作流,该工作流需对记录进行验证、跟踪延续令牌,并报告未完成的运行。在使用正式服务之前,请先使用本地测试环境进行练习。
Gabriel Cioci1 min read
阅读文章Blog
深入探讨网络数据基础设施、数据提取技术以及大规模结构化数据的未来。
156 文章
TL;DR: 构建一个 API 提取工作流,该工作流需对记录进行验证、跟踪延续令牌,并报告未完成的运行。在使用正式服务之前,请先使用本地测试环境进行练习。
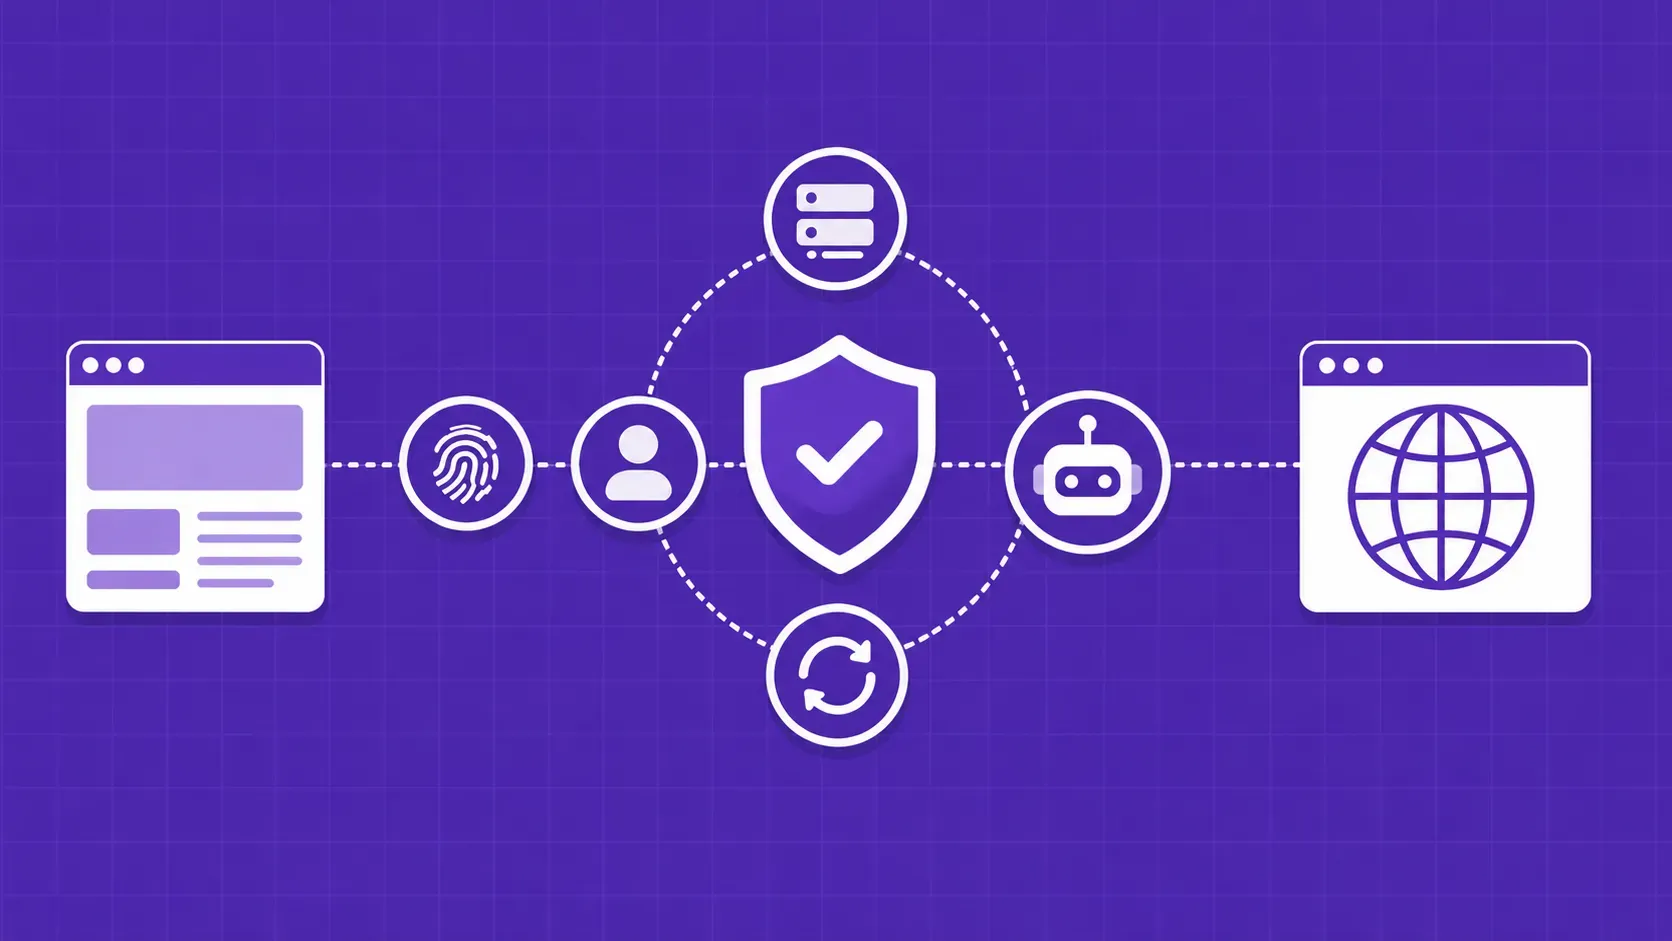
TL;DR: 简要说明:网络搜索代理位于你的搜索器和目标网站之间,掩盖你的 IP,让你在速率限制、地理墙和反僵尸防御系统中生存。正确的类型(数据中心、住宅、ISP 或移动)和正确的协议(HTTP/HTTPS 或 SOCKS5、IPv4 或 IPv6)取决于目标网站的防御、你的地理需求以及每个页面的重要性。本指南介绍了如何权衡利弊,最后提供了一份供应商中立的清单。
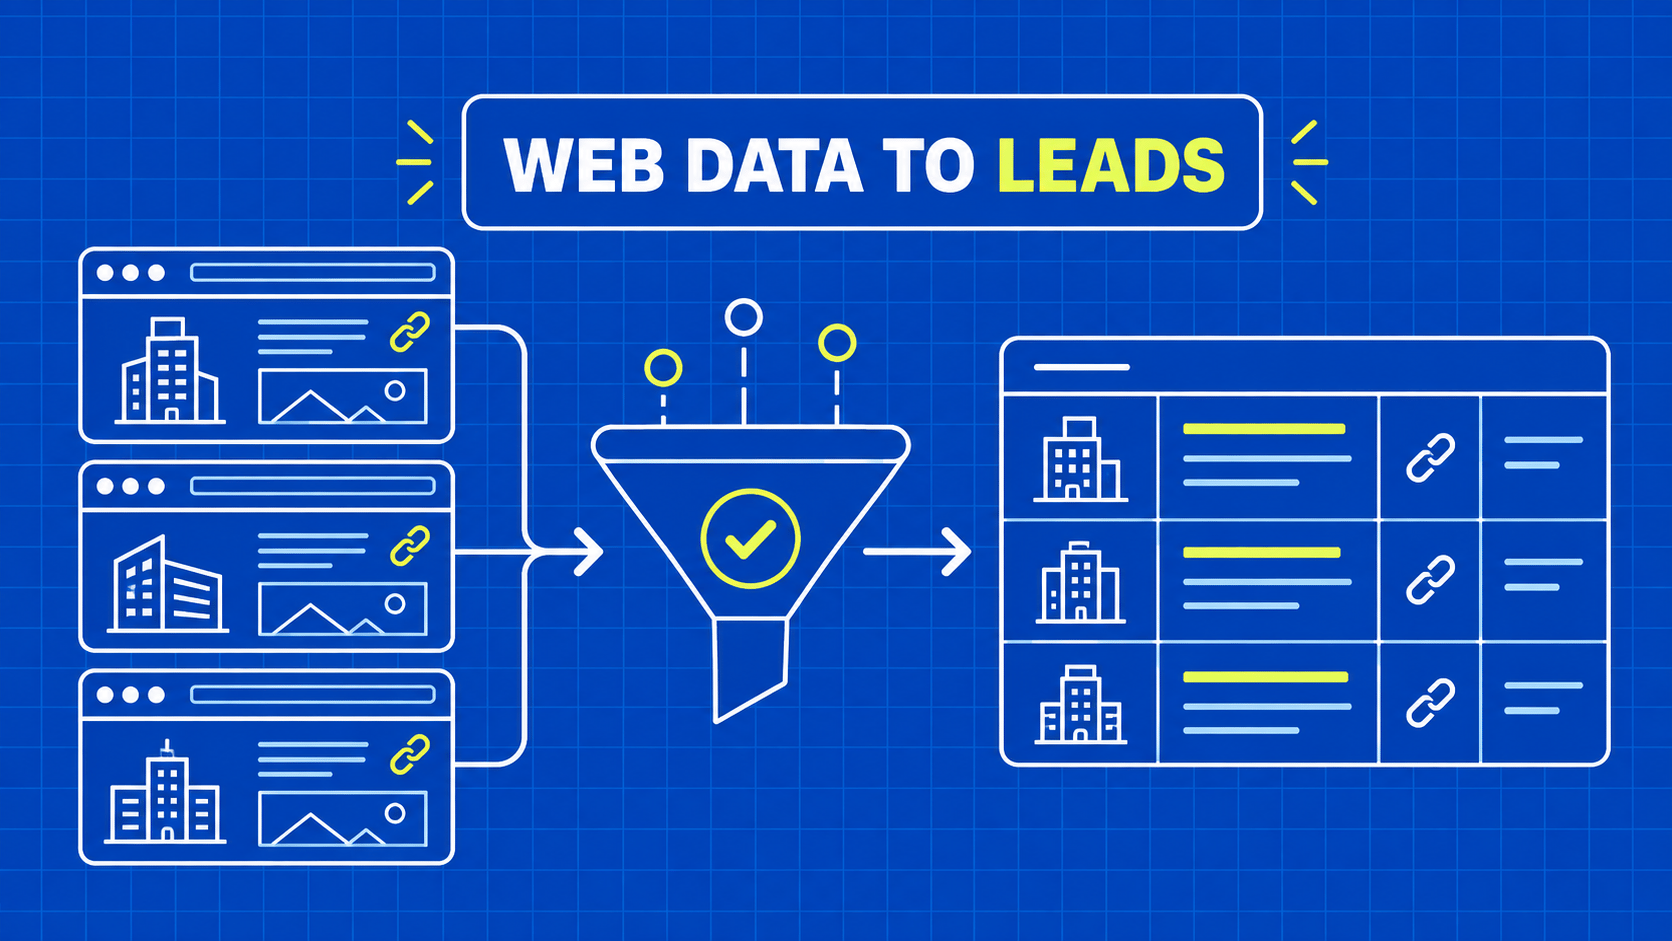
TL;DR: 用网页抓取搭建 B2B 销售线索管道:选择数据源、规范化企业数据、去重、对客户进行资格评估,并安全同步到 CRM。
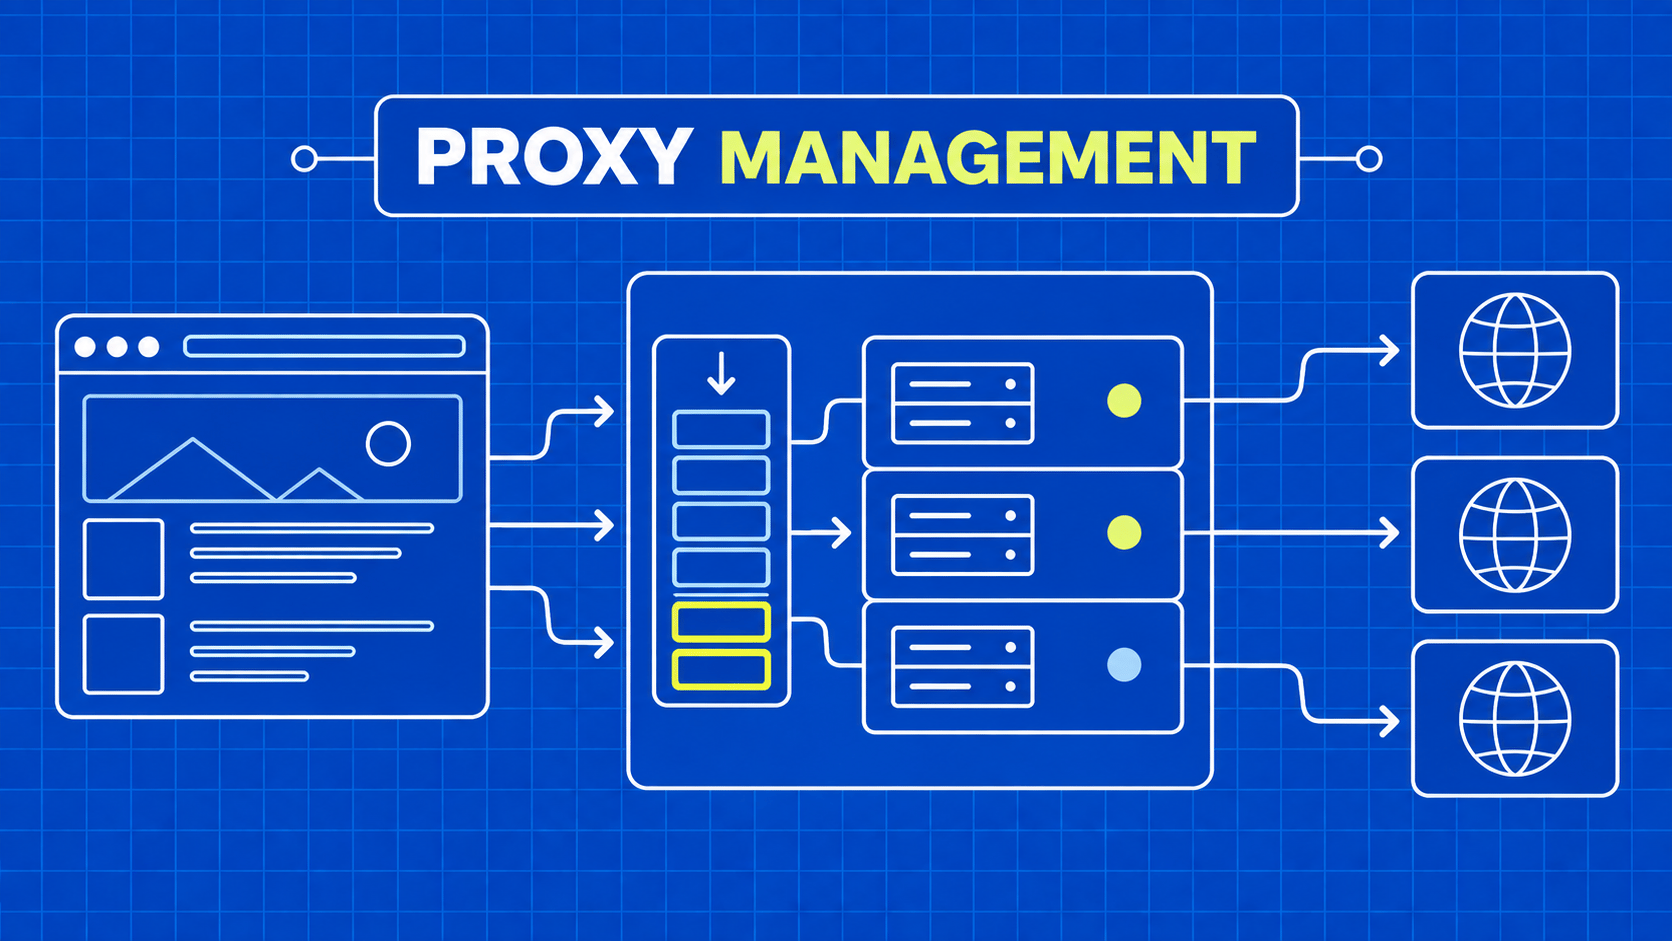
TL;DR: 围绕工作需求、会话租约、分层健康检查以及全源限制来设计代理分配方案。应统计被接受的记录数量,而非地址轮换次数。
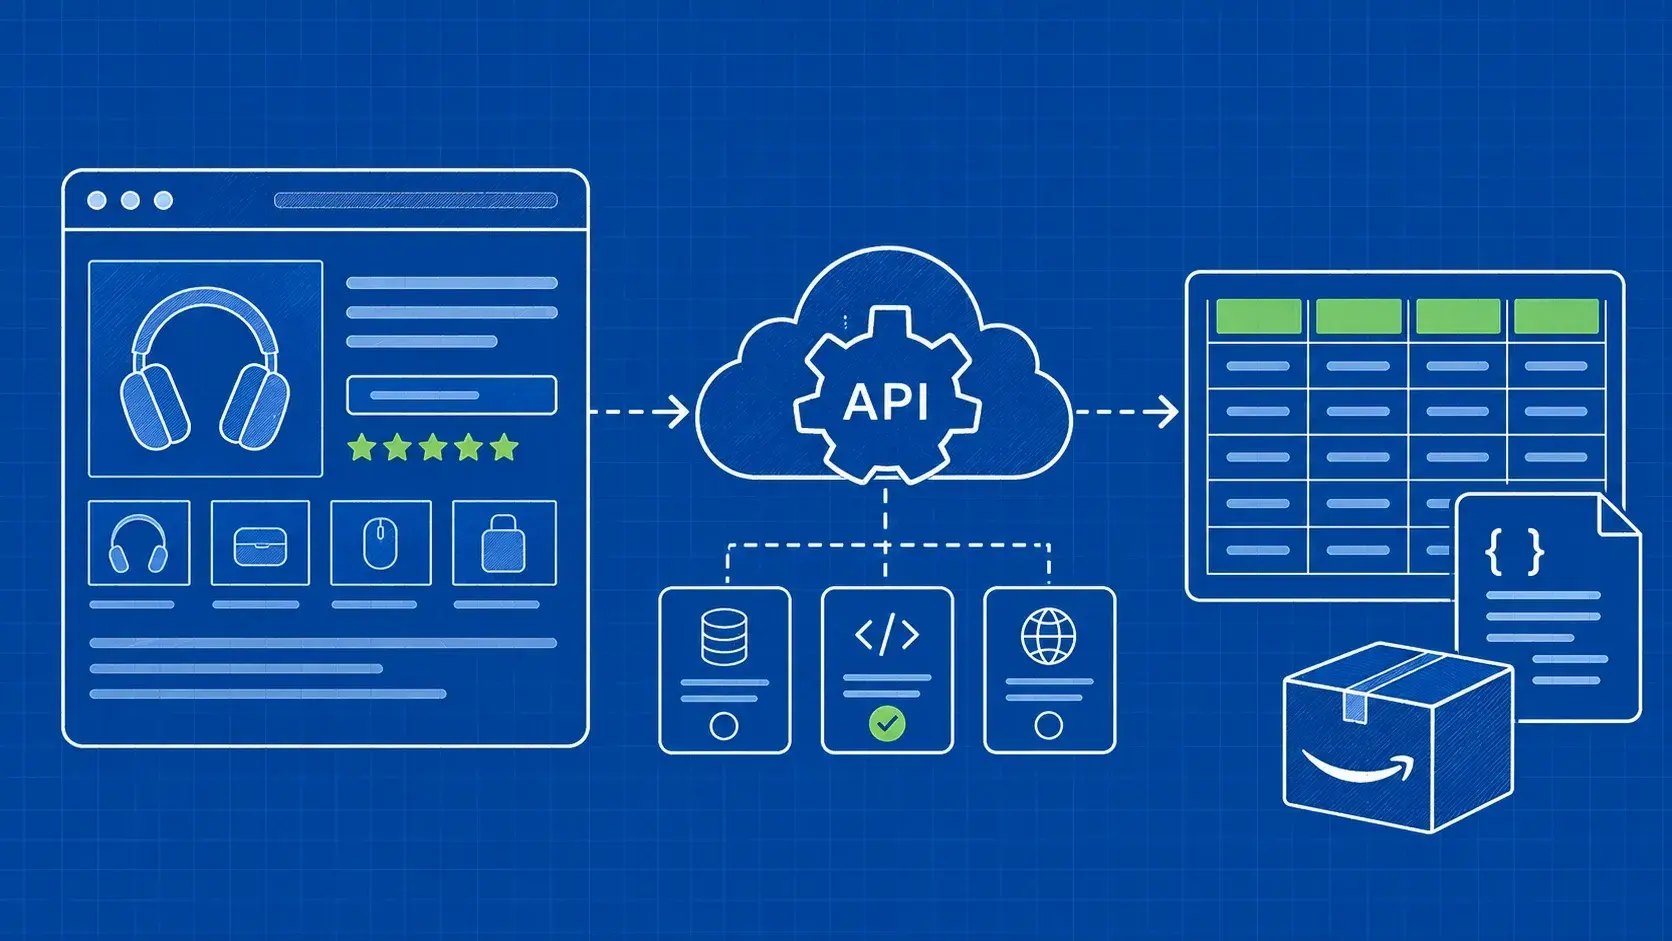
TL;DR: 根据输出结果、位置控制和工作流适配性,对比五种亚马逊数据抓取API方案。通过实际测试和成本核算,为您的项目选择合适的方案。
TL;DR: 用于网络爬虫的最佳代理就是目标网站能够接受的、价格最低的那种。本指南将数据中心代理、ISP代理、住宅代理和移动代理与爬虫任务进行匹配,对比了九家服务商的公开定价,介绍了如何计算每次成功请求的成本,并提供了一个 Python 测试框架,供您在购买前使用自己的 URL 测试各家服务商。