
跳至内容
免费开始

Blog

洞察与工程

深入探讨网络数据基础设施、数据提取技术以及大规模结构化数据的未来。

最新文章

156 文章

搜索结果页面(SERP)抓取 API 指南:Google、Bing、DuckDuckGo、Yandex
指南

搜索结果页面(SERP)抓取 API 指南:Google、Bing、DuckDuckGo、Yandex

TL;DR: 将密钥设置为环境变量,发送您的第一个 WebScrapingAPI SERP API 请求,然后按国家/地区、语言和设备对 Google 搜索结果进行本地化,采用防御性方式解析 Google 和 Bing 的 JSON 数据,自行提取 DuckDuckGo 和 Yandex 的 HTML 内容,运行异步 Google 任务, 根据文档中记载的错误代码进行重试,并根据截至 2026 年 10 月的 Google 定价方案选择合适的套餐。

Suciu Dan7 min read
阅读文章
如何使用亚马逊数据抓取 API:快速入门指南
指南

如何使用亚马逊数据抓取 API:快速入门指南

TL;DR: 开始使用 WebScrapingAPI 的亚马逊数据抓取 API:发送您的第一个请求,从九种请求类型(商品、搜索、畅销榜、优惠、卖家评论等)中进行选择,支持 20 个亚马逊市场,解析每个 JSON 响应,处理错误和重试,并选择合适的套餐。

Robert Sfichi6 min read
阅读文章
Scrapy 与 Selenium:谁是赢家?
网络爬虫技术

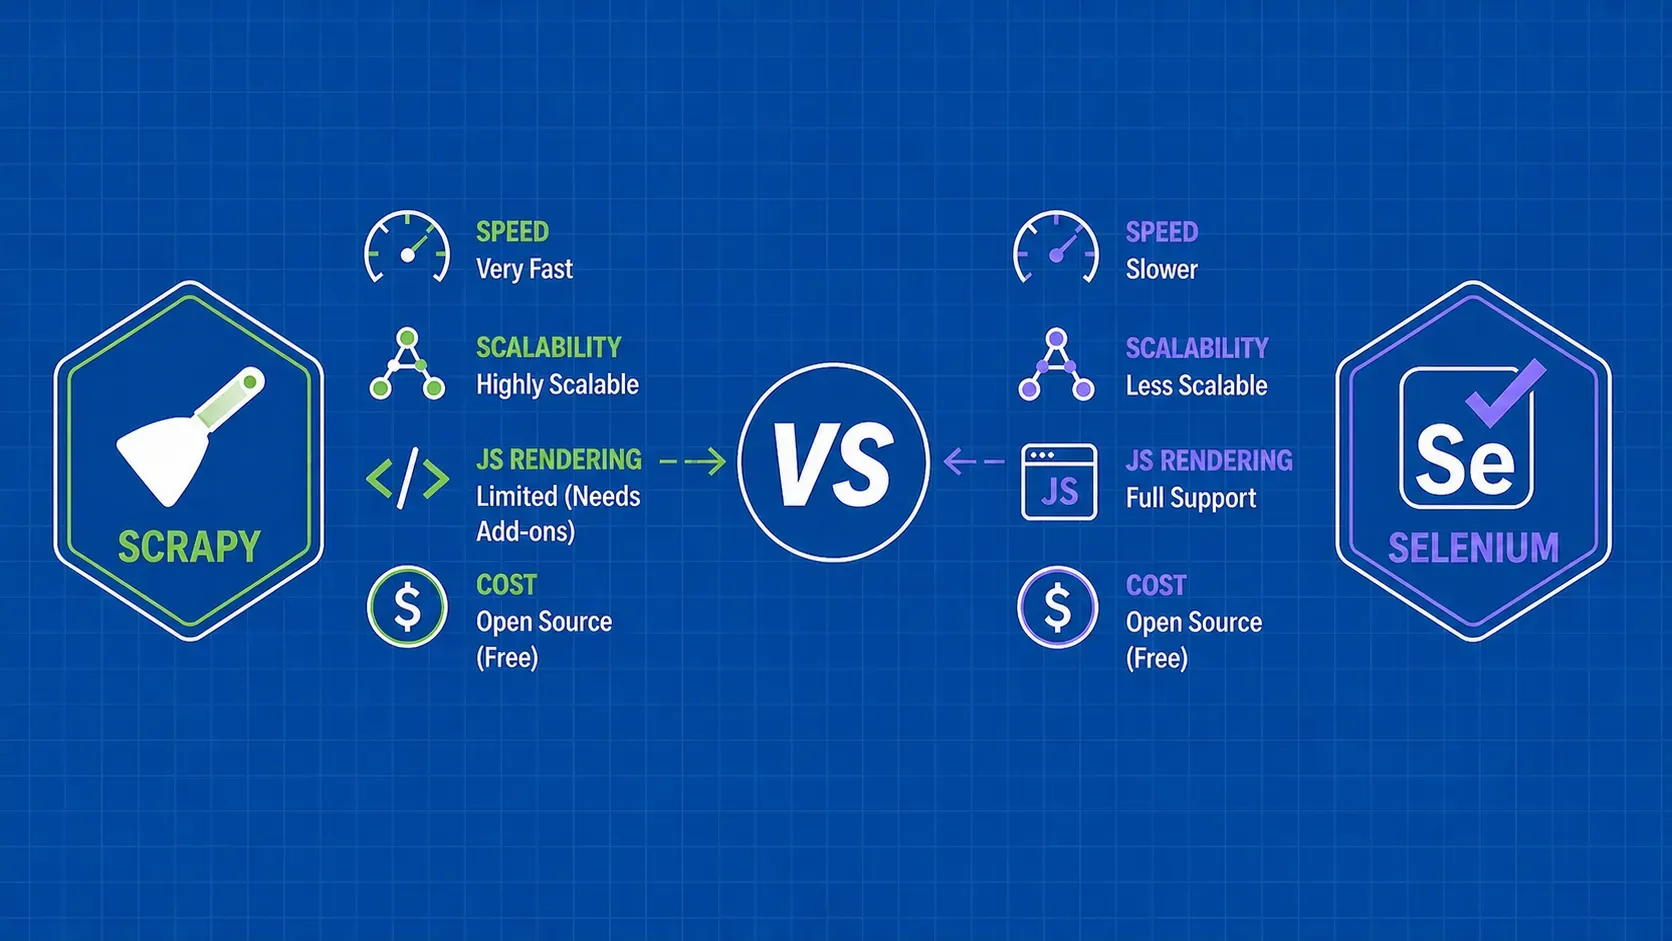
Scrapy 与 Selenium:谁是赢家?

TL;DR: 简要说明:Scrapy 是一个高速异步抓取框架,用于大规模从静态页面中提取结构化数据。Selenium 可自动运行真实浏览器并处理 JavaScript 繁重的网站,但资源成本要高得多。大多数生产型抓取项目都会受益于了解何时使用每种方法,或何时将它们结合起来使用。

Gabriel Cioci2 min read
阅读文章
Scrapy vs Beautiful Soup:选择哪种 Python 抓取工具
指南

Scrapy vs Beautiful Soup:选择哪种 Python 抓取工具

TL;DR: 简而言之:Scrapy 是一个完整的抓取框架,可在一个软件包中处理请求、解析和数据导出。Beautiful Soup 是一个轻量级解析库,可与 HTTP 客户端(如请求)配对使用。当你需要利用内置管道进行大规模并发抓取时,请选择 Scrapy。当你需要一个快速、最小化的设置来解析少量页面时,请选择 Beautiful Soup。

Mihnea-Octavian Manolache3 min read
阅读文章
Scrapy Splash 教程:渲染 JavaScript 页面
指南

Scrapy Splash 教程:渲染 JavaScript 页面

TL;DR: 简要说明:Scrapy Splash 将 Scrapy 的快速抓取引擎与 Splash 无头浏览器配对使用,以渲染 JavaScript 较多的页面。本 Scrapy Splash 教程将指导你完成 Docker 设置、Scrapy 项目配置、SplashRequest 基础知识、用于滚动和点击的 Lua 脚本、代理集成,以及修复你将遇到的最常见错误。

Ștefan Răcilă4 min read
阅读文章
使用 Python 抓取亚马逊产品数据:实践指南
指南

使用 Python 抓取亚马逊产品数据:实践指南

TL;DR: 简要说明:亚马逊产品页面包含大量有价值的数据(价格、评分、评论、ASIN),但可靠地提取这些数据需要的不仅仅是基本的 HTTP 请求。本指南将指导您使用 Requests 和 BeautifulSoup 构建 Python scraper,处理分页和反僵尸防御,导出为 CSV 或 JSON,并将结果输入 LLM 工作流。您还将了解何时使用刮擦 API 而不是推出自己的解决方案。

Raluca Penciuc3 min read
阅读文章

开始构建

准备好扩展您的数据收集规模了吗?

加入2,000多家企业,使用WebScrapingAPI在无需任何基础设施开销的情况下,以企业级规模提取网络数据。