

指南
2026年十大最佳AI网页抓取工具
TL;DR: 没有一款AI爬虫能胜任所有工作负载。根据数据提取方法、用户类型、操作功能和成本对11款工具进行对比,然后通过实用的测试方案选择最适合的工具。
Suciu Dan3 min read
阅读文章Blog
深入探讨网络数据基础设施、数据提取技术以及大规模结构化数据的未来。
156 文章
TL;DR: 没有一款AI爬虫能胜任所有工作负载。根据数据提取方法、用户类型、操作功能和成本对11款工具进行对比,然后通过实用的测试方案选择最适合的工具。
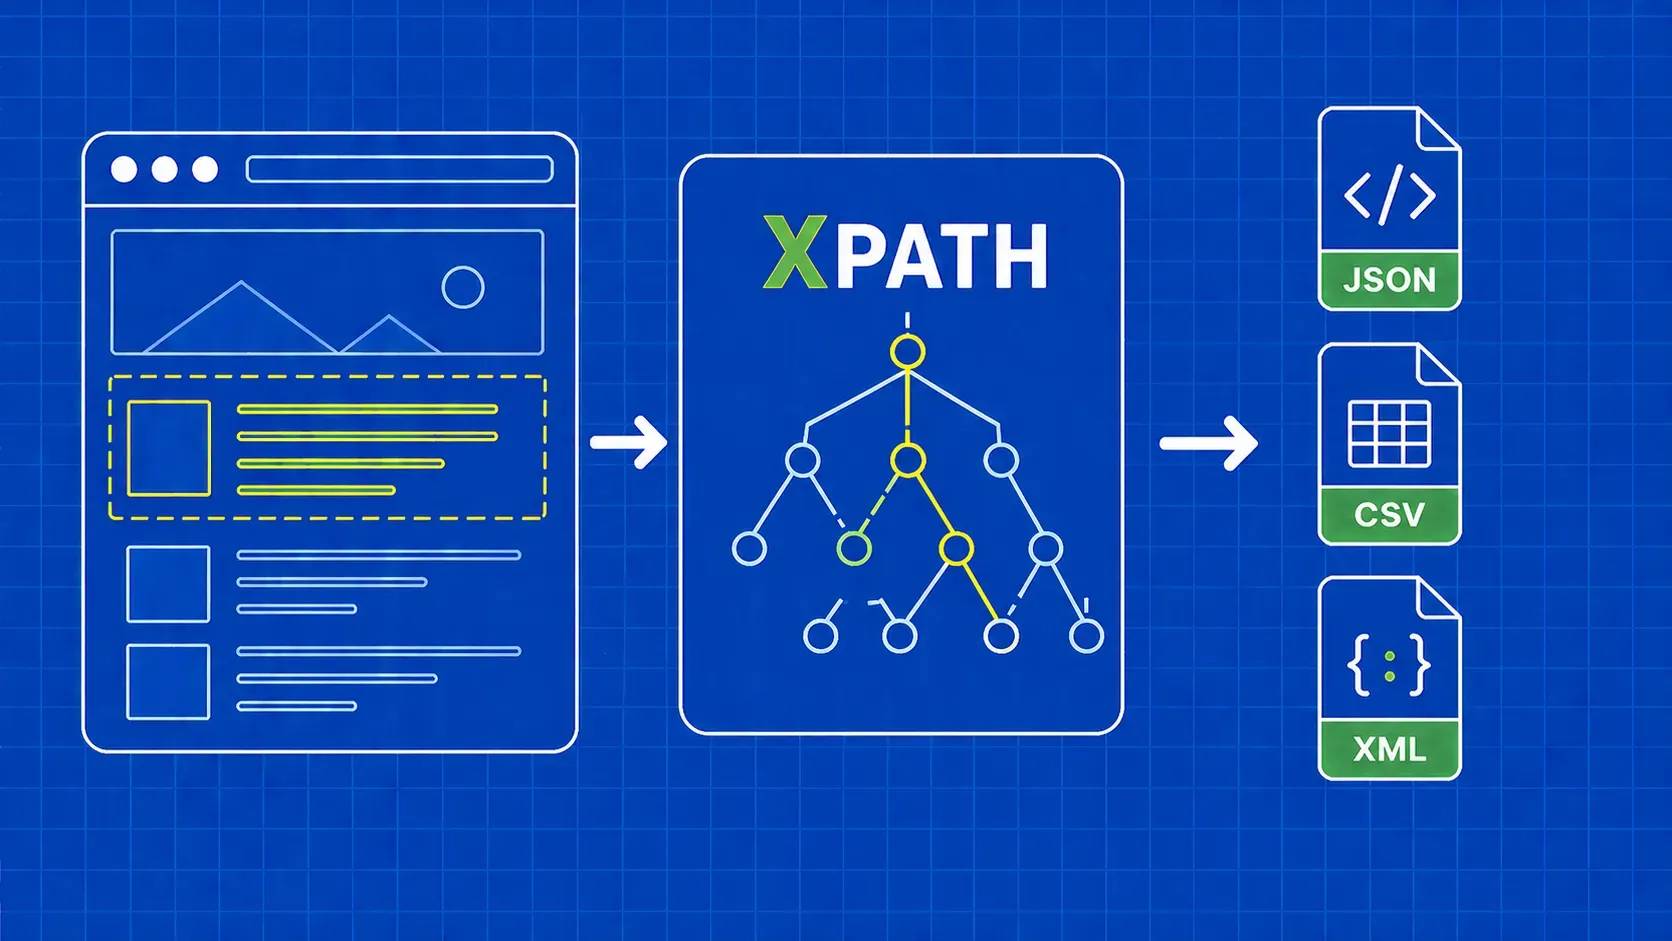
TL;DR: 简要说明:XPath 是一种查询语言,用于通过路径、属性或文本内容导航 HTML/XML 树。本指南涵盖 XPath 语法、轴和函数,然后展示了使用 lxml 和 Selenium 运行 Python scraers 的情况。您还将获得一份综合小抄和针对最常见 XPath 错误的故障排除部分。
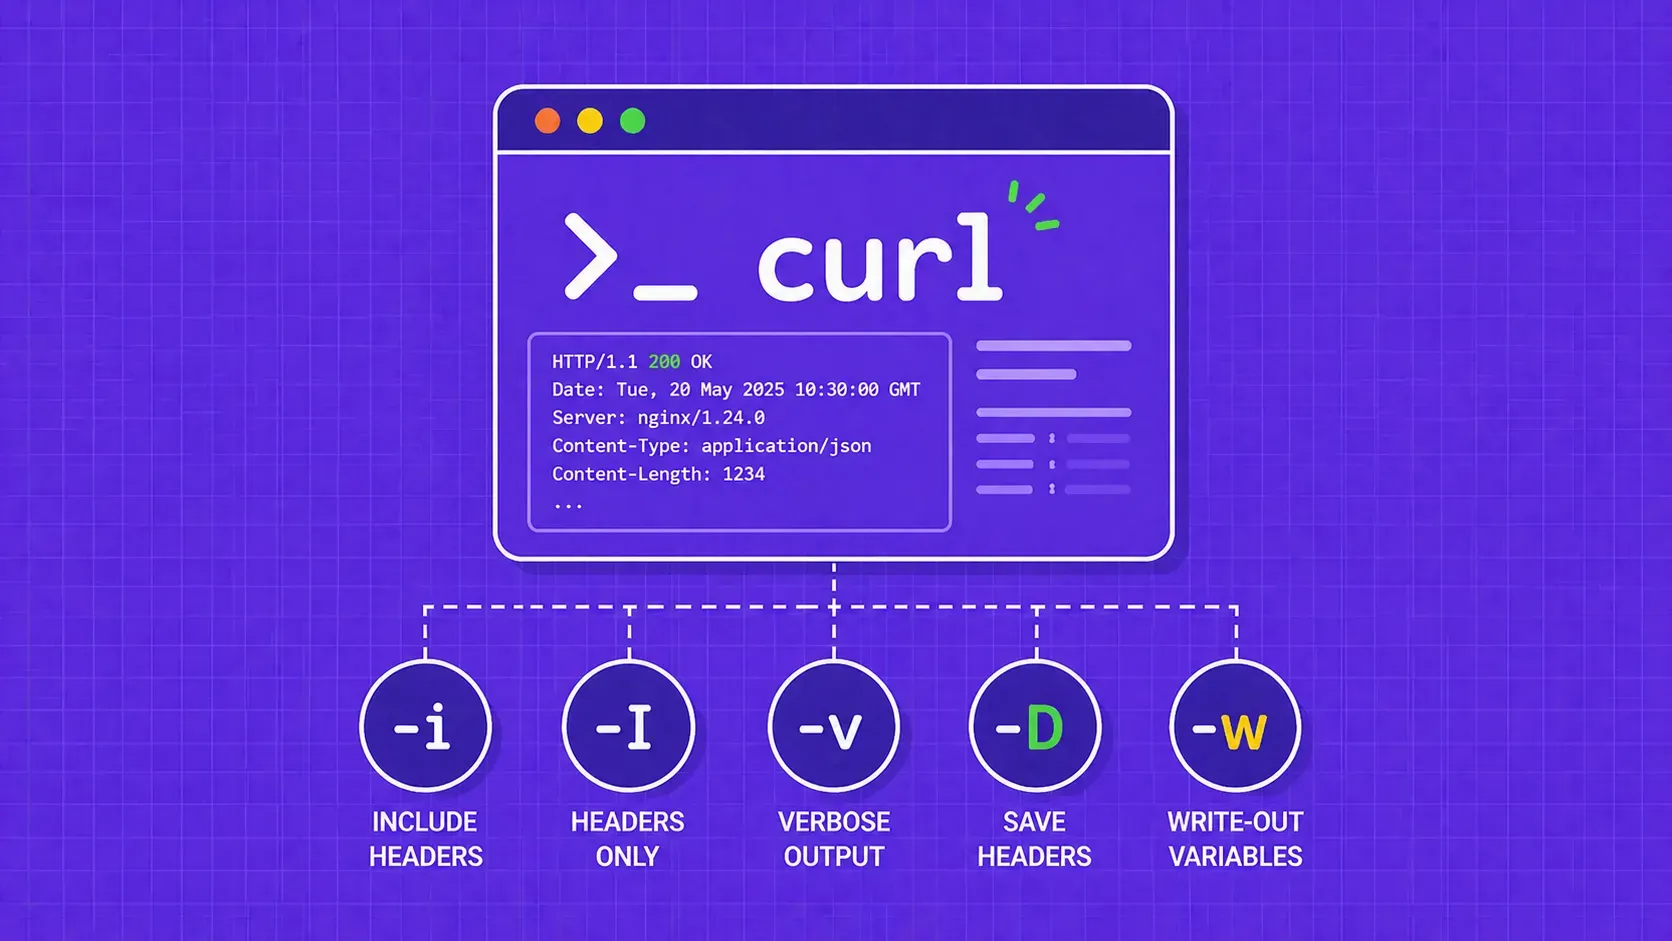
TL;DR: 简要说明:cURL 默认隐藏响应头信息。使用 -i 可以看到响应头和正文,使用 -I 可以看到 HEAD 请求只返回响应头,使用 -v 可以看到完整的请求/响应调试,使用 -D 可以将响应头保存到文件中。对于现代脚本,cURL 7.83+ 允许提取单个头信息,或使用 -w write-out 选项将所有头信息转存为 JSON 格式。
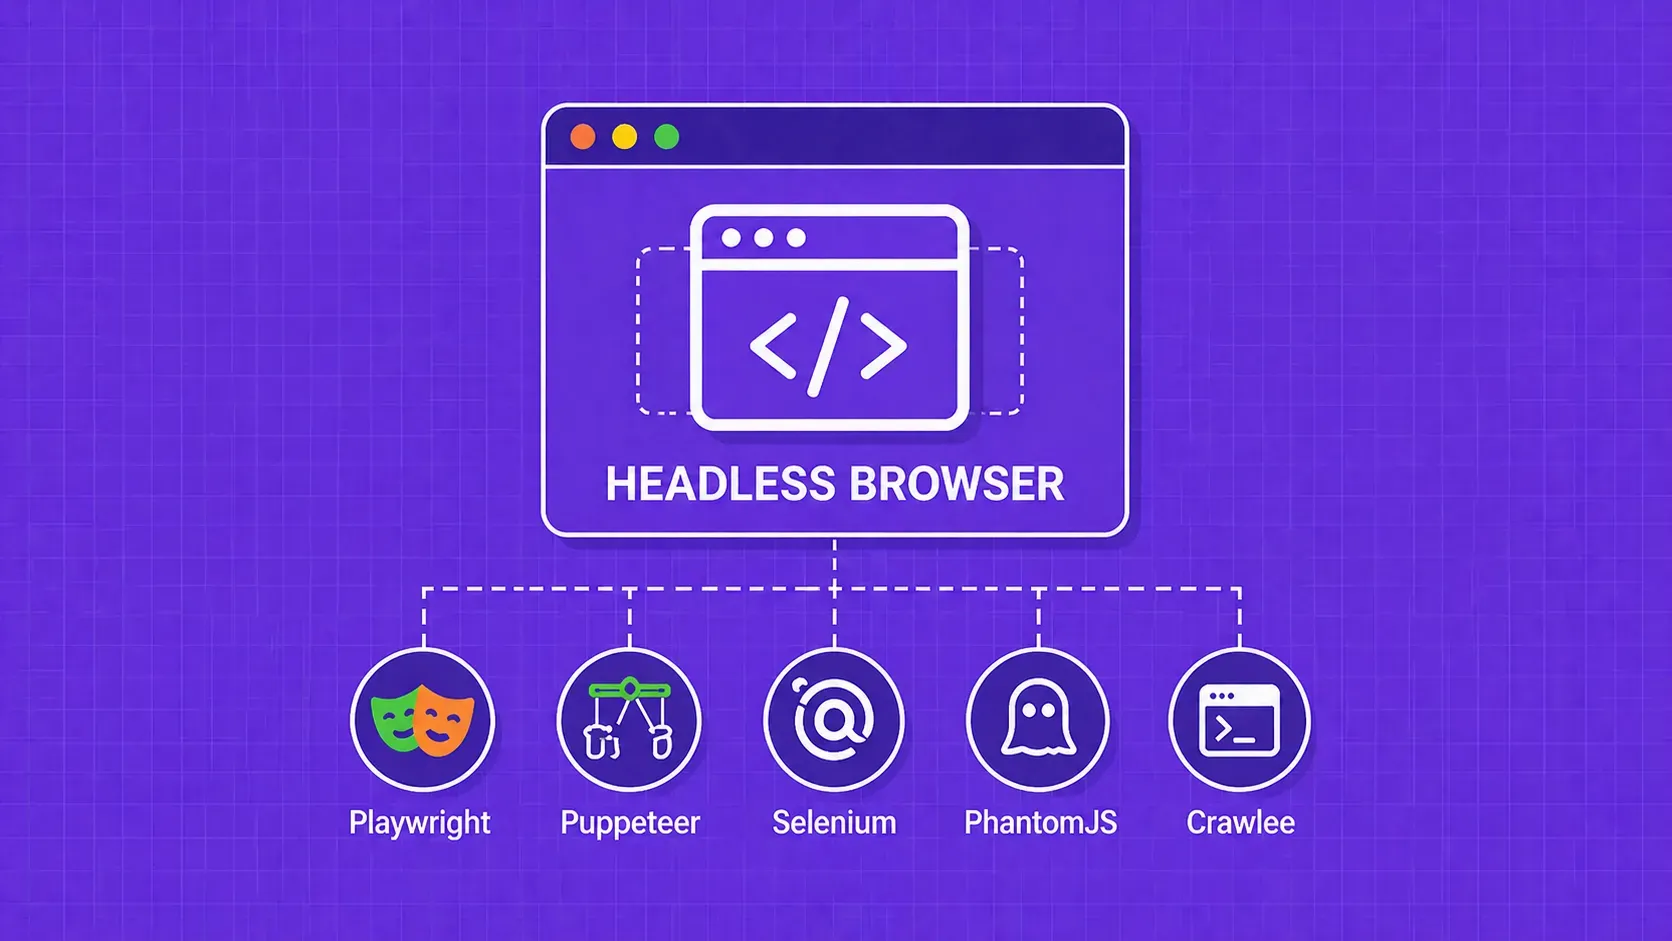
TL;DR: 简要说明:无头浏览器是一种网络浏览器,运行时没有可见的图形界面,完全由代码或命令行指令控制。开发人员将无头浏览器用于自动测试、网络扫描、性能监控,并越来越多地用于支持人工智能代理。本指南将介绍无头浏览器的内部工作原理、何时选择无头浏览器而非普通浏览器,以及哪些框架值得你花时间研究。
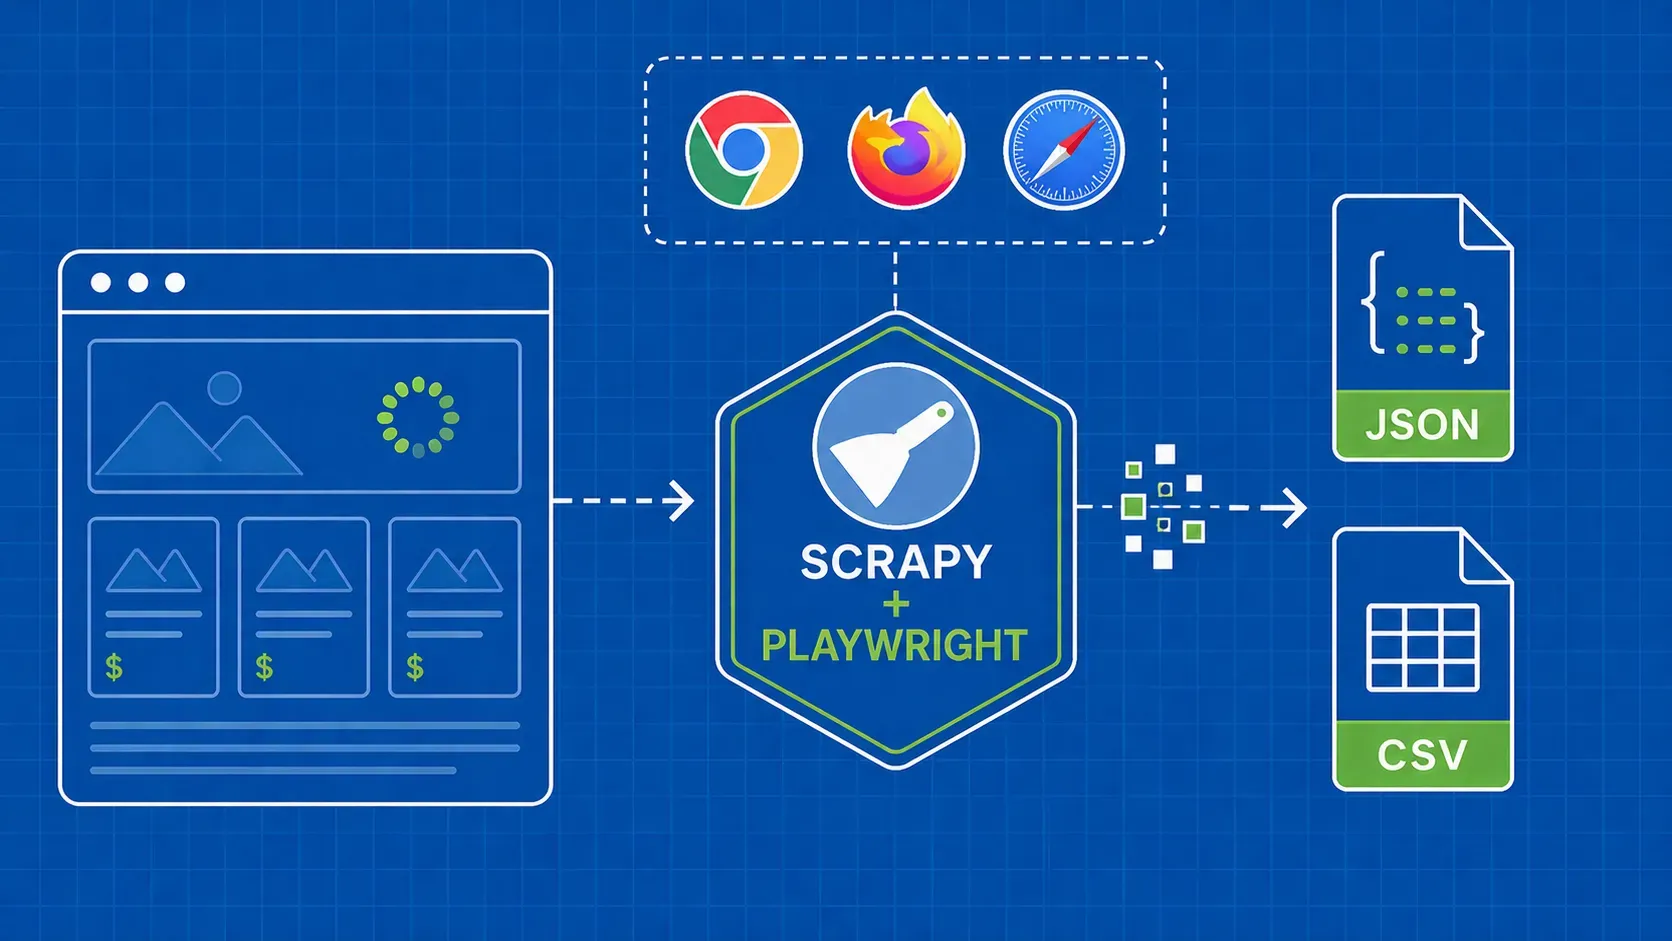
TL;DR: 简要说明:Scrapy-Playwright 可让你通过 Playwright 控制真实的 Chromium、Firefox 或 WebKit 浏览器,直接在 Scrapy spiders 中渲染 JavaScript 繁重的页面。本教程将指导你完成安装、配置、页面交互、AJAX 截取、反检测和生产就绪的项目结构,这样你就可以在不离开 Scrapy 生态系统的情况下抓取动态网站了。
TL;DR: 使用 Python 结合 JavaScript 渲染、代理服务器、CSS 选择器和分页功能,抓取 Expedia 的酒店列表,然后对数据进行清理并导出为 CSV 格式。