
指南
从情感分析到营销:Twitter网络爬取的诸多优势
TL;DR: 利用专业的网页抓取技术,充分挖掘Twitter数据。学习如何抓取Twitter数据以进行情绪分析、市场营销和商业情报分析。本指南全面介绍了如何使用TypeScript进行操作。
Raluca Penciuc2 min read
阅读文章Blog
深入探讨网络数据基础设施、数据提取技术以及大规模结构化数据的未来。
156 文章
TL;DR: 利用专业的网页抓取技术,充分挖掘Twitter数据。学习如何抓取Twitter数据以进行情绪分析、市场营销和商业情报分析。本指南全面介绍了如何使用TypeScript进行操作。

TL;DR: 简要说明:要在 C# 中使用 HttpClient 代理,只需创建一个 WebProxy,将其附加到 HttpClientHandler(或 SocketsHttpHandler),然后将该处理程序传递给 HttpClient 构造函数。在生产中,将手动循环换成 IHttpClientFactory,为经过验证的代理添加 NetworkCredential,并使用 Polly 将调用包裹在重试中,这样死 IP 就不会让你的工作程序宕机。
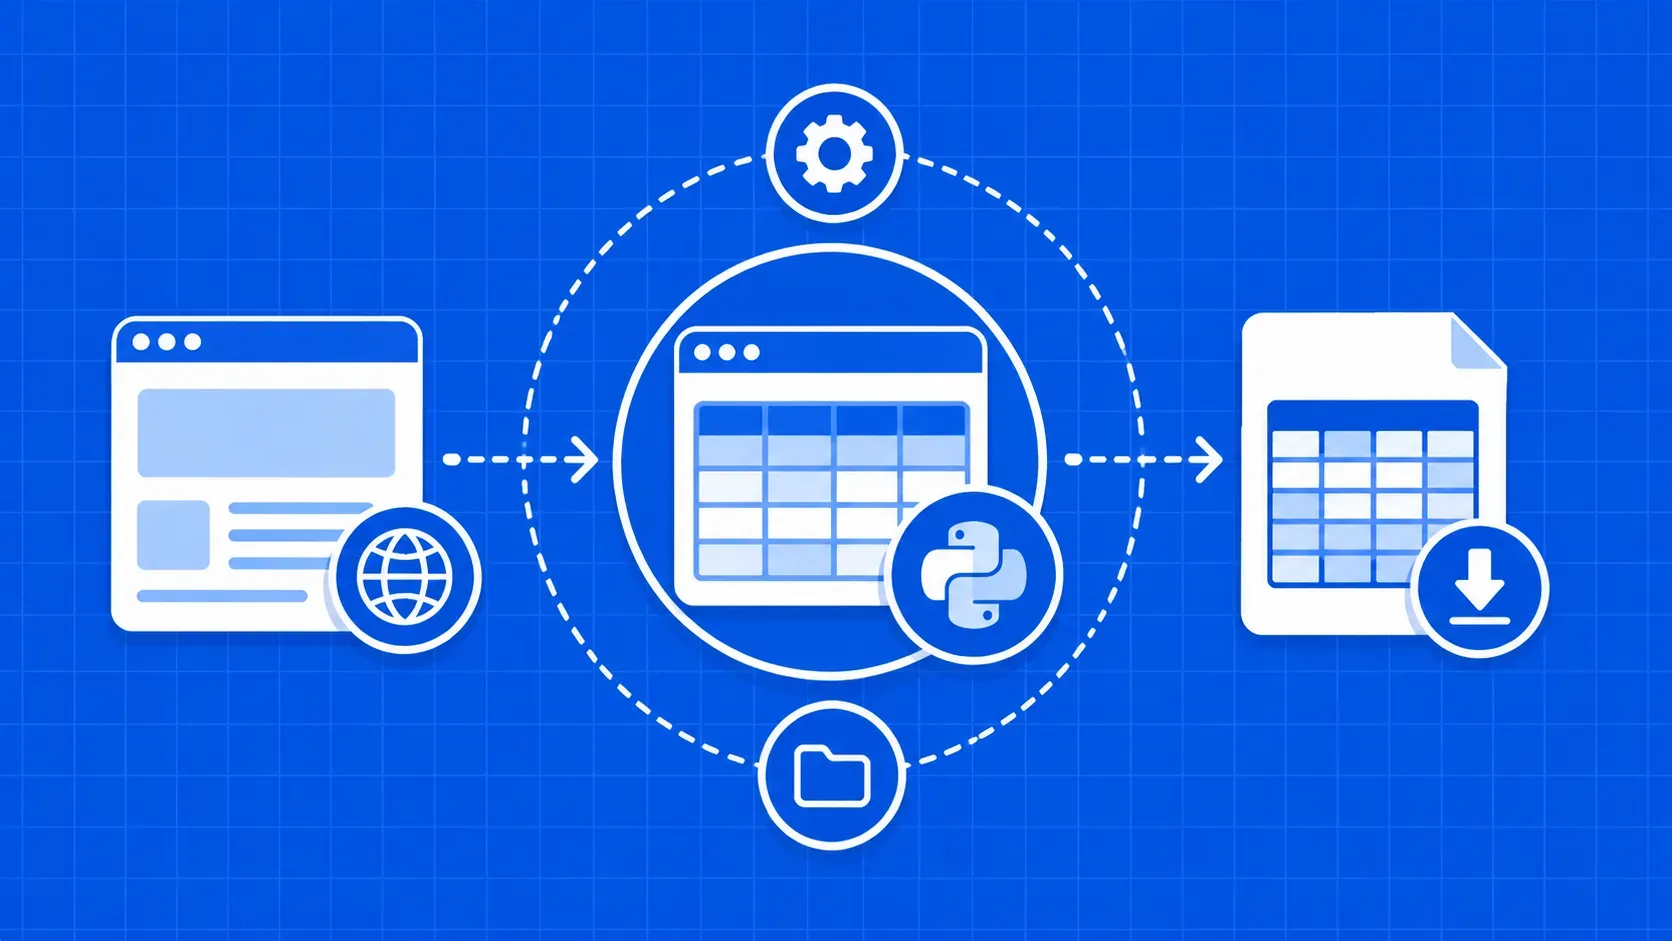
TL;DR: 简而言之:只需使用一行 pandas.read_html 命令,就能刮擦大部分 HTML 表格。当表格是分页的、JavaScript 渲染的或有合并表头时,请切换到 Requests + BeautifulSoup 或像 Playwright 这样的无头浏览器。本指南为您提供了决策矩阵、三种方法的工作代码,以及将刮擦行转化为管道就绪数据的清理步骤。
TL;DR: 简而言之:Cheerio 是轻量级 HTML 解析器;Puppeteer 驱动真正的 Chromium 浏览器。当数据已经存在于原始 HTML 中时,使用 Cheerio;当 JavaScript 渲染数据时,使用 Puppeteer;当每次访问需要提取大量字段的 JS 页面时,将它们结合起来使用。

TL;DR: 简要说明:浏览器自动化是指通过代码驱动真实或无头 Web 浏览器,使其代表您点击、键入、导航和读取页面。本指南将解释什么是浏览器自动化,比较 Selenium、Playwright、Puppeteer 和 Cypress,并说明何时不需要使用完整浏览器。

TL;DR: 简要说明:网络搜刮从公共网页中收集原始数据。数据挖掘分析结构化数据,以显示模式、预测和细分。它们是同一生命周期中的不同阶段,大多数生产系统都将它们结合在一个 "先搜刮,后规范化,再挖掘 "的流程中。