
指南
使用 libcurl 和 lexbor 进行 C 和 C++ 网页抓取
TL;DR: 使用 libcurl 和 lexbor 在 C 和 C++ 中抓取网站:利用 CMake 和 vcpkg 构建一个“礼貌型”的 C++20 爬虫,导出格式规范的 CSV 和 JSON 文件,通过三种方式处理 JavaScript 页面,并用纯 C 语言运行相同的抓取程序。
Raluca Penciuc7 min read
阅读文章Blog
深入探讨网络数据基础设施、数据提取技术以及大规模结构化数据的未来。
156 文章
TL;DR: 使用 libcurl 和 lexbor 在 C 和 C++ 中抓取网站:利用 CMake 和 vcpkg 构建一个“礼貌型”的 C++20 爬虫,导出格式规范的 CSV 和 JSON 文件,通过三种方式处理 JavaScript 页面,并用纯 C 语言运行相同的抓取程序。
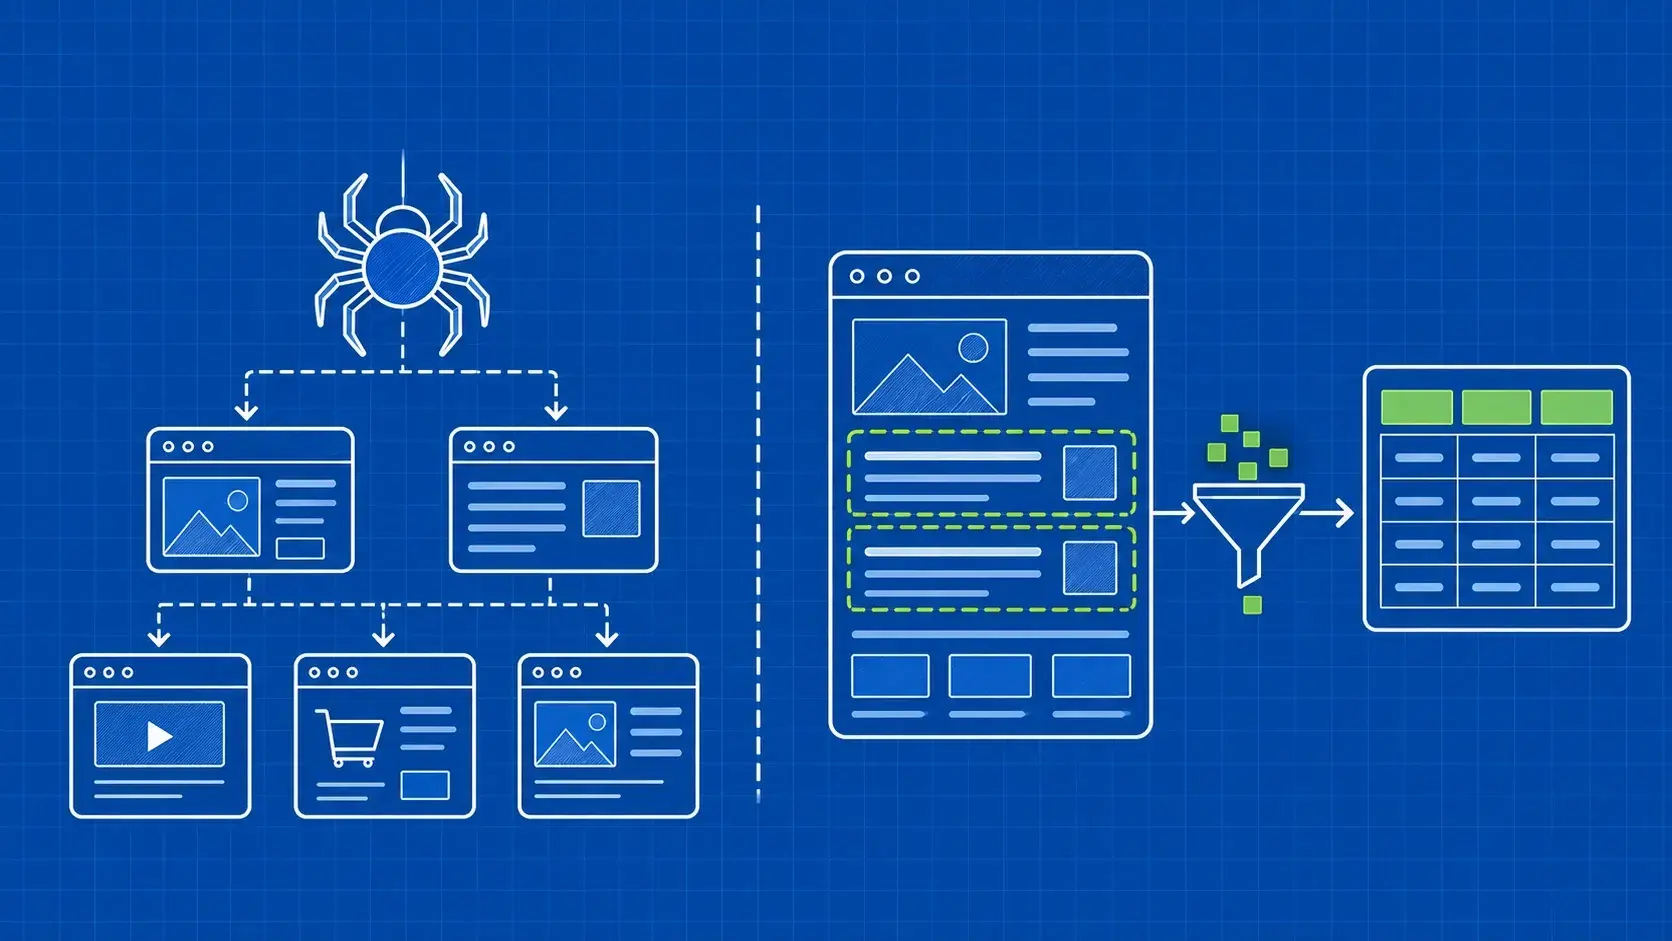
TL;DR: 了解爬虫如何查找网页,以及数据抓取工具如何提取有用数据。以一家书店为例,比较它们的输出结果,并为您的首个项目选择合适的工作流程。
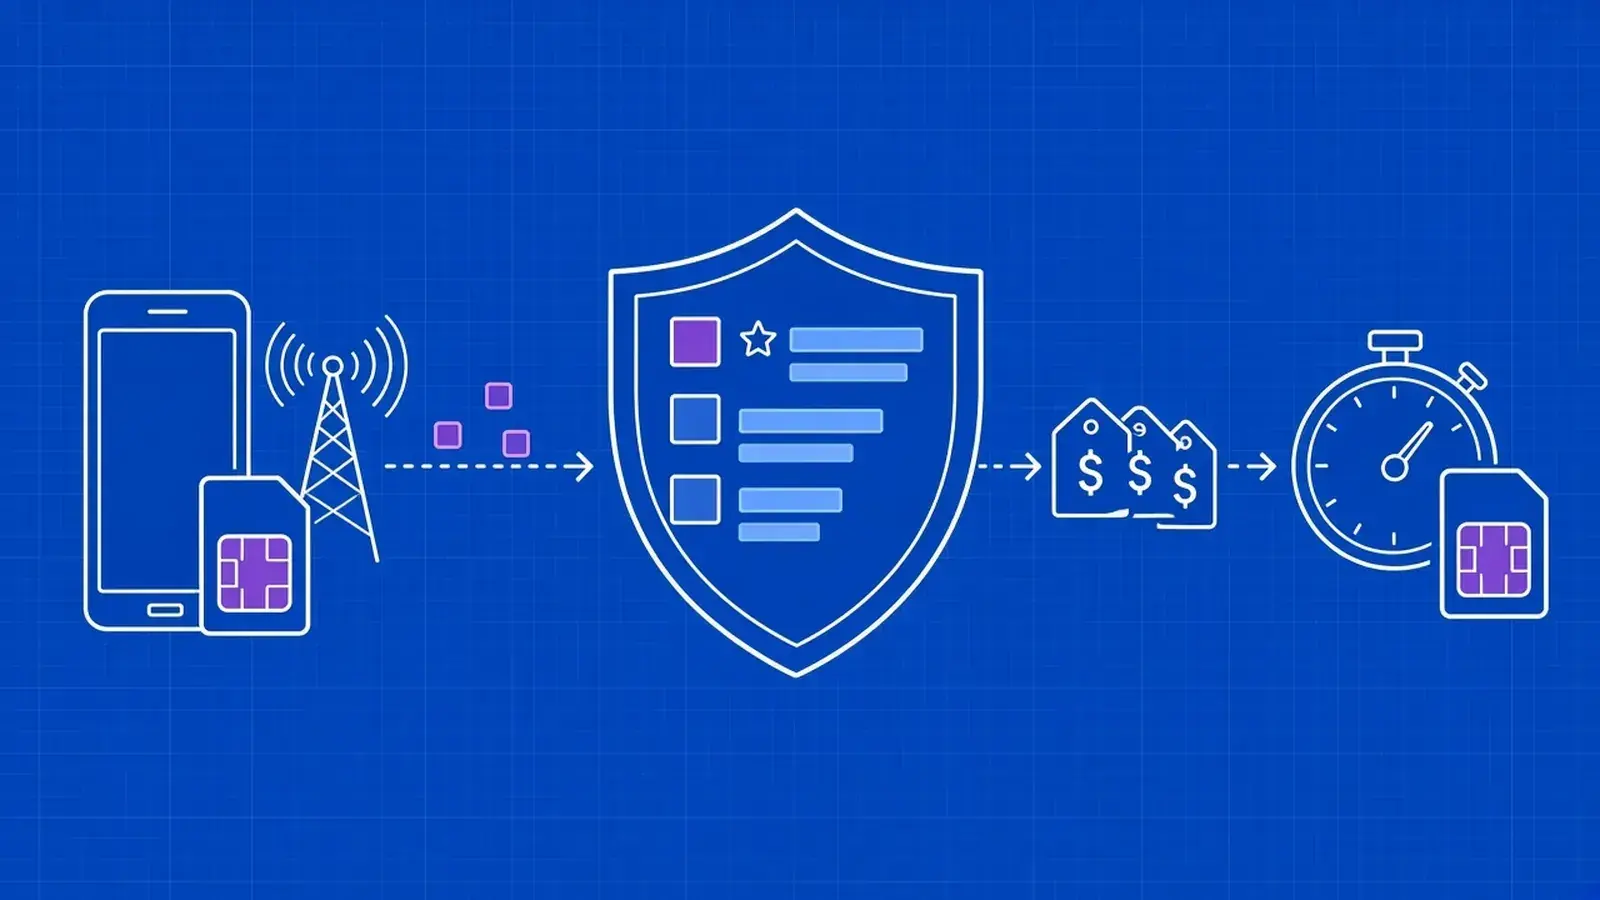
TL;DR: 按每 GB 或每端口价格、运营商与 ASN 定向、5G、粘性会话和试用条款,对比 9 家用于网页抓取的移动代理服务商(截至 2026 年 10 月)。
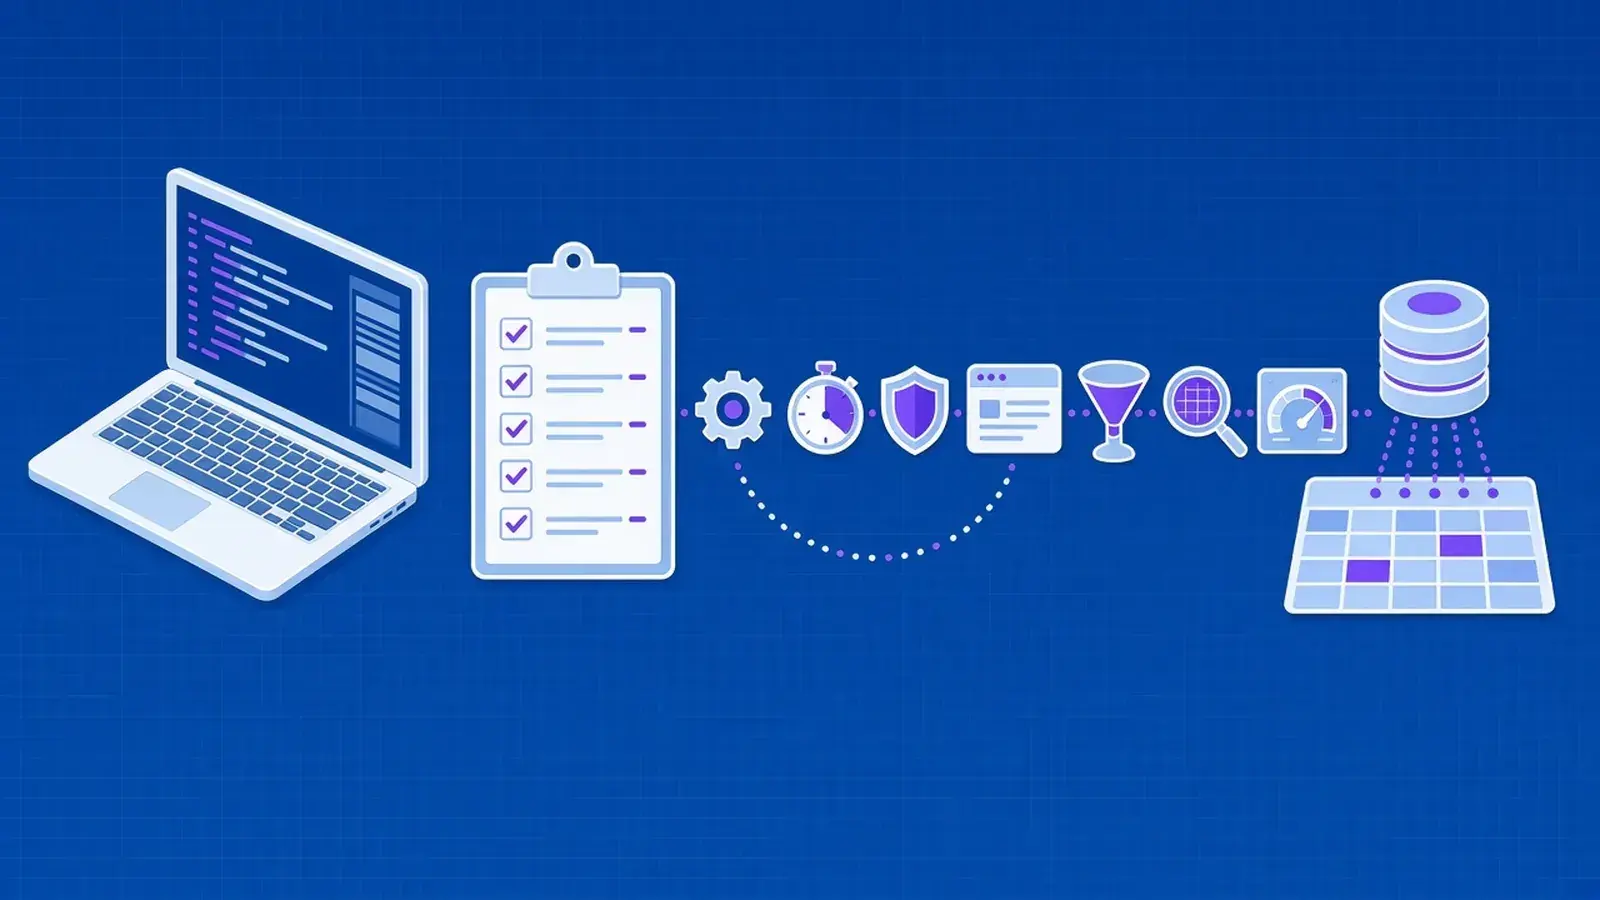
TL;DR: 简而言之:网页抓取最佳实践,是让爬虫保持合法、礼貌、准确且运行成本低的一系列习惯。请编写数据契约,优先使用 API 或 JSON 而非 HTML,按照 RFC 9309 的定义遵守 robots.txt,控制对每个主机的请求节奏,遵守 Retry-After,并在保存前验证每条记录。本指南将这些实践应用于爬虫生命周期的每个阶段,并附有可运行的 Python 代码片段。
TL;DR: 构建一份权威的SEO审计报告,将观察到的页面证据与搜索引擎结果区分开来。对比页面渲染、规范链接信号、指令以及模板缺陷。
TL;DR: 设计出收集器能够可靠调用的 API。将分页、重试、验证器、身份验证、模式演进和恢复作为明确的契约进行定义。