
指南
如何使用 Puppeteer 和 NodeJS 进行网络抓取 2026 指南
TL;DR: 简要说明:Puppeteer 可让你在 Node.js 中完全控制一个无头 Chrome 浏览器实例,使其成为刮削 JavaScript 渲染页面的首选工具。本指南将指导你完成安装、基于选择器的提取、无限滚动、表单登录、请求拦截、隐身插件、结构化数据导出和 Docker 部署,这样你就可以从一个玩具脚本变成一个生产级的搜刮器。
Gabriel Cioci3 min read
阅读文章Blog
深入探讨网络数据基础设施、数据提取技术以及大规模结构化数据的未来。
156 文章
TL;DR: 简要说明:Puppeteer 可让你在 Node.js 中完全控制一个无头 Chrome 浏览器实例,使其成为刮削 JavaScript 渲染页面的首选工具。本指南将指导你完成安装、基于选择器的提取、无限滚动、表单登录、请求拦截、隐身插件、结构化数据导出和 Docker 部署,这样你就可以从一个玩具脚本变成一个生产级的搜刮器。
TL;DR: 共享型、半专用型和专用型数据中心代理的定价和计费方式差异巨大,以至于标价最低的那种往往实际花费最高。 本指南对比了11家服务商的当前标价,针对不同任务各推荐一家,详细解释了按IP计费与按GB计费的区别以及合理使用政策,并附有Python脚本,可用于估算成本并验证您的IP是否真正属于专用IP。
TL;DR: 学习如何用 Python 抓取房地产数据:选择数据源,解析房源列表和 JSON-LD,核查各房产门户的使用条款,并通过开放数据获取房价。
TL;DR: 简要说明:这篇 BeautifulSoup 教程将引导您完成一个完整的 Python scraper,从 pip 安装到一个加固的脚本,该脚本可以分页浏览 Hacker News、导出为 CSV 和 JSON,并保持足够的礼貌以免被屏蔽。每个片段都可运行,我们还指出了 BeautifulSoup 是错误工具的确切时刻。
TL;DR: 简而言之:当返回的 HTML 中包含数据时,先使用 HttpClient 和 Jsoup;在适当的情况下调用公开的 JSON 数据源;仅在涉及浏览器相关状态时才添加渲染或使用 Selenium。 本 Java 网络爬虫教程通过分页、并发限制、重试、会话管理、数据验证和持久化输出,逐步扩展一个 Java 21 代码库。
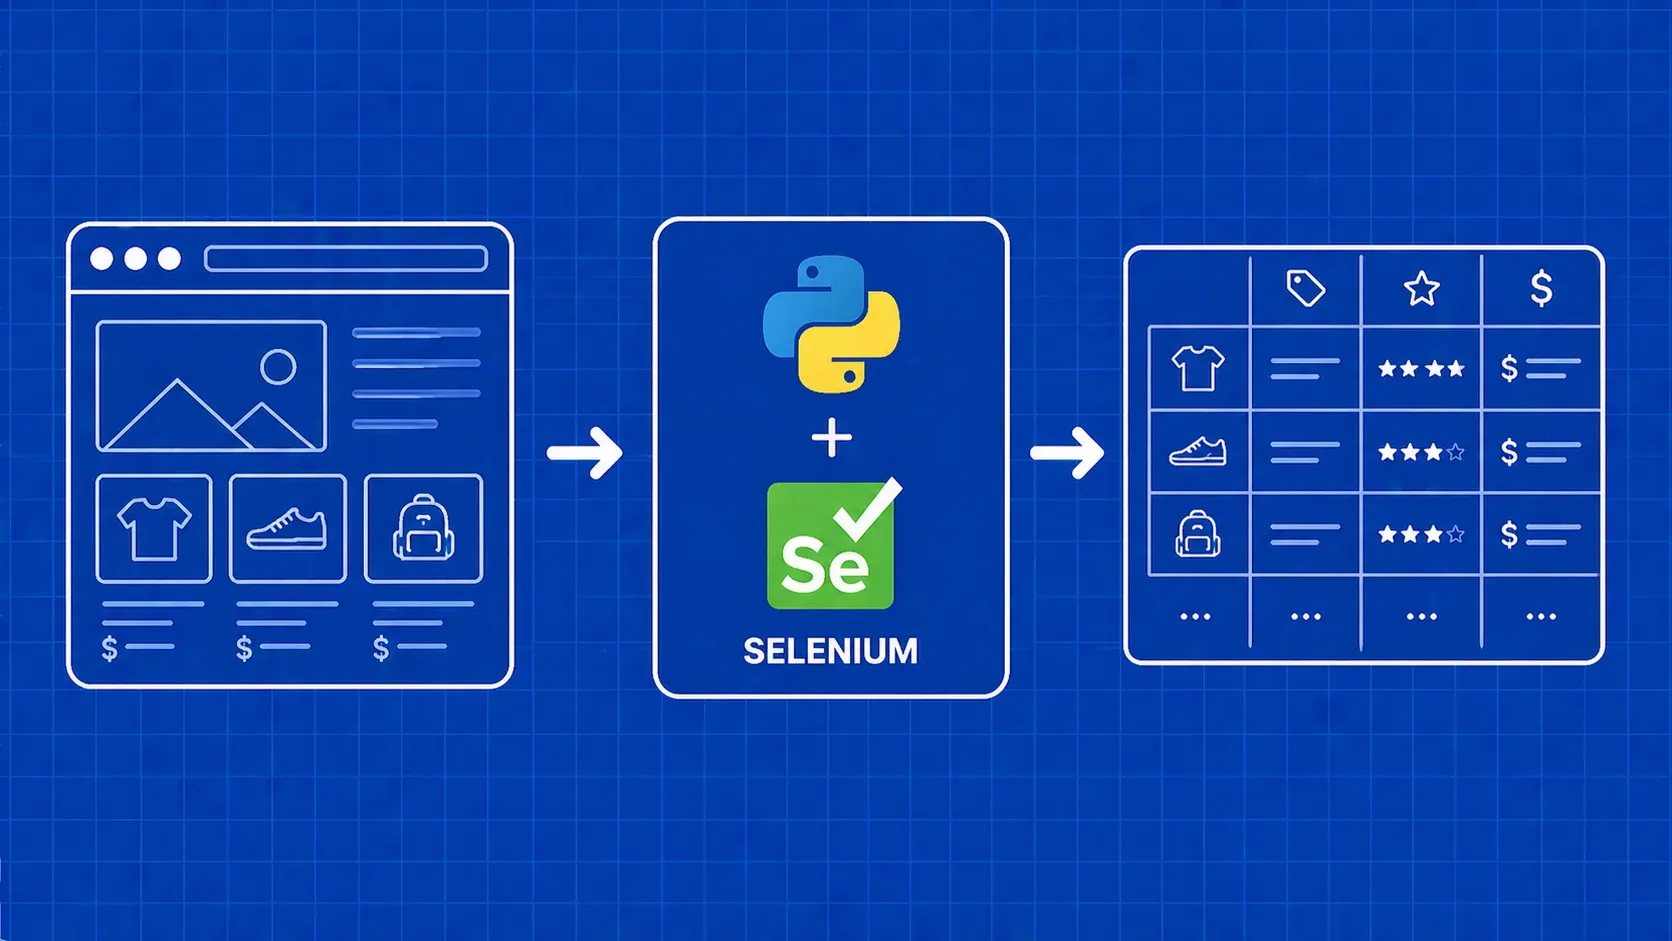
TL;DR: 简要说明:Selenium 可让您通过 Python 代码驱动真实浏览器,从而刮擦 JavaScript 繁重的网站。本教程将指导您完成每个阶段的工作:安装 Selenium、配置 Chrome 浏览器、定位元素并与之交互、处理等待和分页、导出干净的数据,以及使用代理、Selenium Grid 和基于 API 的替代方法扩展您的 scraper。