

用例
如何抓取Airbnb房源数据
TL;DR: 有没有一种简单快捷的方法可以从Airbnb提取数据?有的,这就是网络爬虫大显身手的时候了。让我们通过WebScrapingAPI向您展示具体操作方法。
Robert Sfichi1 min read
阅读文章Blog
深入探讨网络数据基础设施、数据提取技术以及大规模结构化数据的未来。
156 文章
TL;DR: 有没有一种简单快捷的方法可以从Airbnb提取数据?有的,这就是网络爬虫大显身手的时候了。让我们通过WebScrapingAPI向您展示具体操作方法。
TL;DR: 建立证据清单,识别读者与任务之间的差距,并将经过审查的观察结果转化为原创内容。保留来源、不确定性,并提供清晰的视觉解释。
TL;DR: 利用一个范围有限且经过审核的数据集,对初创企业的上线假设进行验证。将数据采集质量与用户研究相结合,并设置一个能够缩小项目范围或终止项目的上线门槛。
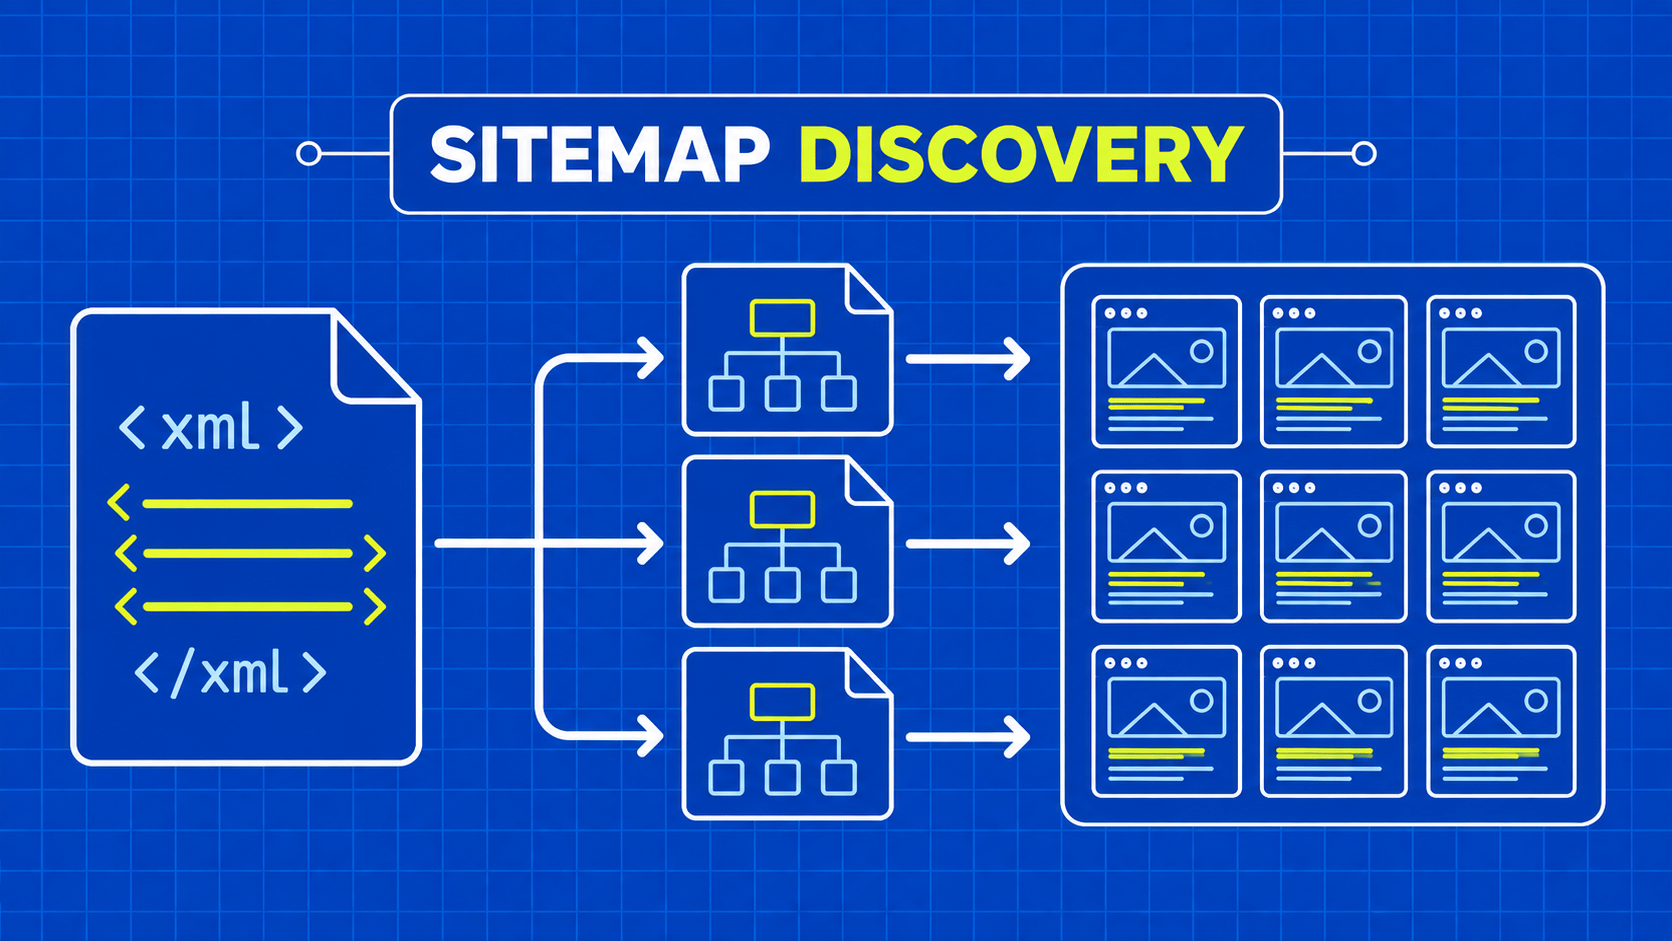
TL;DR: 将网站地图索引转化为可追踪的 URL 发现队列。了解支持命名空间的解析、协议限制、数据时效性注意事项,以及针对不可信 URL 的安全边界。
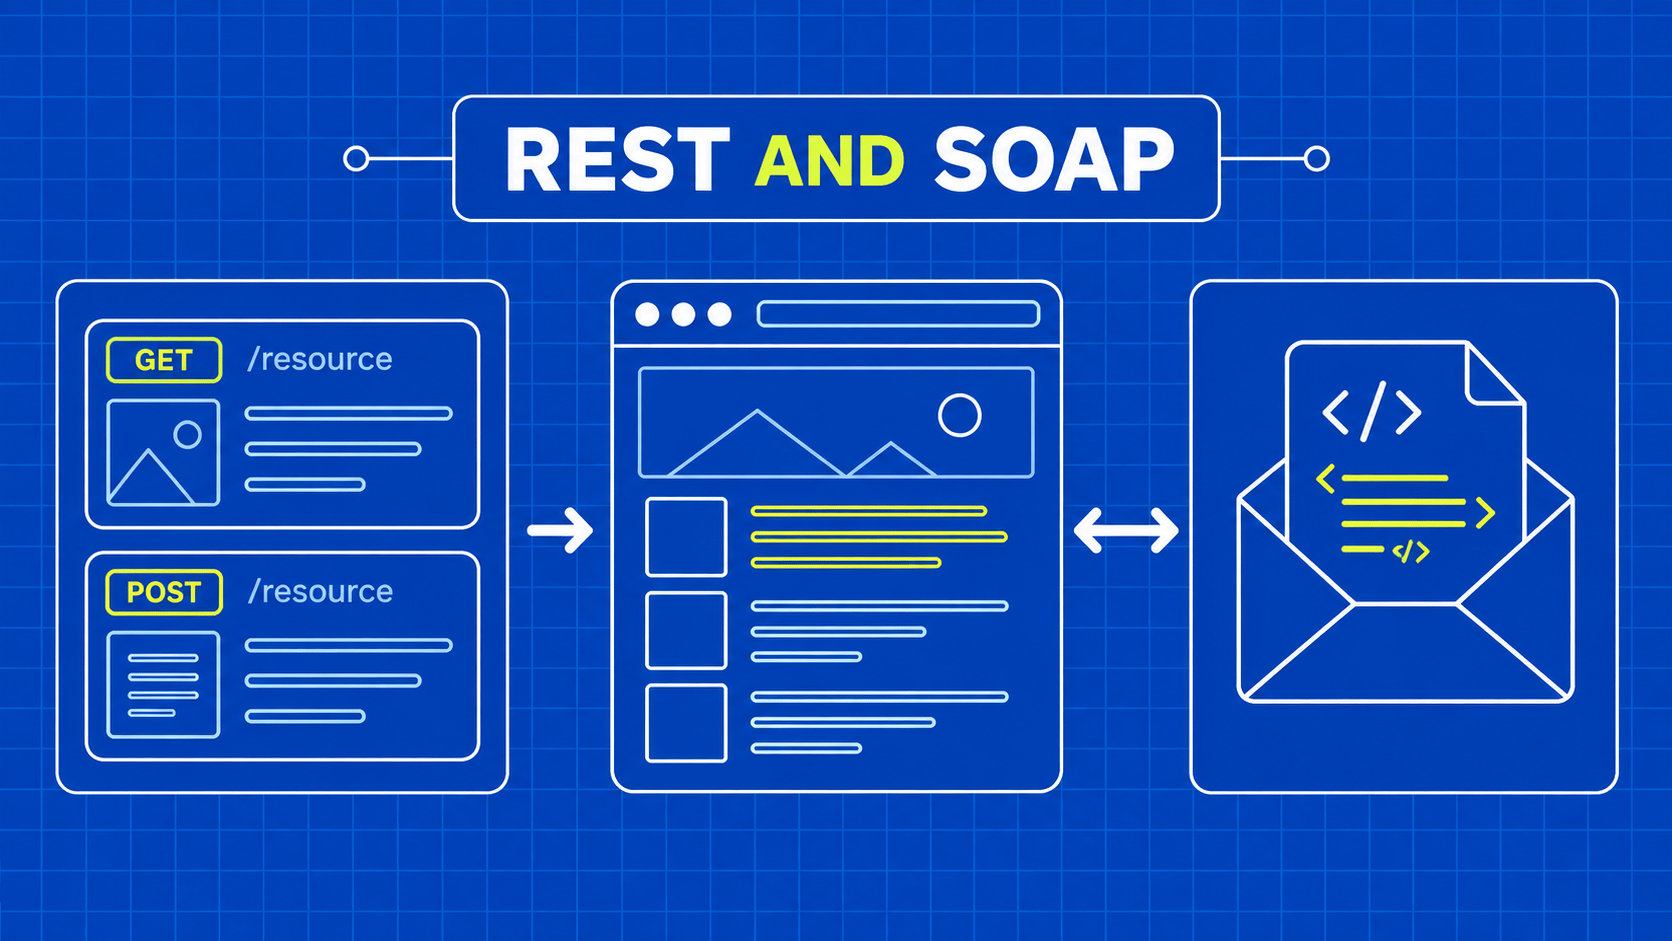
TL;DR: 根据实际合同、安全配置、工具以及恢复行为来选择集成方案。将REST架构与SOAP消息传递区分开来,并破除常见的误区。

TL;DR: 简而言之:现代阻塞发生在四个层面:网络、请求签名、浏览器和行为。首先使用状态代码和挑战页面对该层进行诊断,然后通过旋转式住宅代理、浏览器级标头、TLS 冒充、隐身浏览器和类人计时的正确组合进行修复。当流量或反僵尸技术的复杂性导致 DIY 不经济时,可将请求层卸载到托管 API。