
指南
Profit Scraper:验证可用性并替换工作流
TL;DR: 在遵循旧版“Profit Scraper”建议之前,请先验证当前服务的身份。针对商品列表数据、成交价调研以及透明的成本假设,构建一套替代工作流。
Mihai Maxim1 min read
阅读文章Blog
深入探讨网络数据基础设施、数据提取技术以及大规模结构化数据的未来。
156 文章
TL;DR: 在遵循旧版“Profit Scraper”建议之前,请先验证当前服务的身份。针对商品列表数据、成交价调研以及透明的成本假设,构建一套替代工作流。

TL;DR: 这是一份关于使用 Elixir 进行网页抓取的完整指南。了解如何使用这种最适合并发编程的语言之一来构建网页抓取工具。

TL;DR: Rust 是一种运行速度快且内存利用率高的编程语言。但它在处理网页抓取方面表现如何呢?请阅读这篇适合初学者的指南,了解如何使用它来构建一个基础的网页抓取工具。
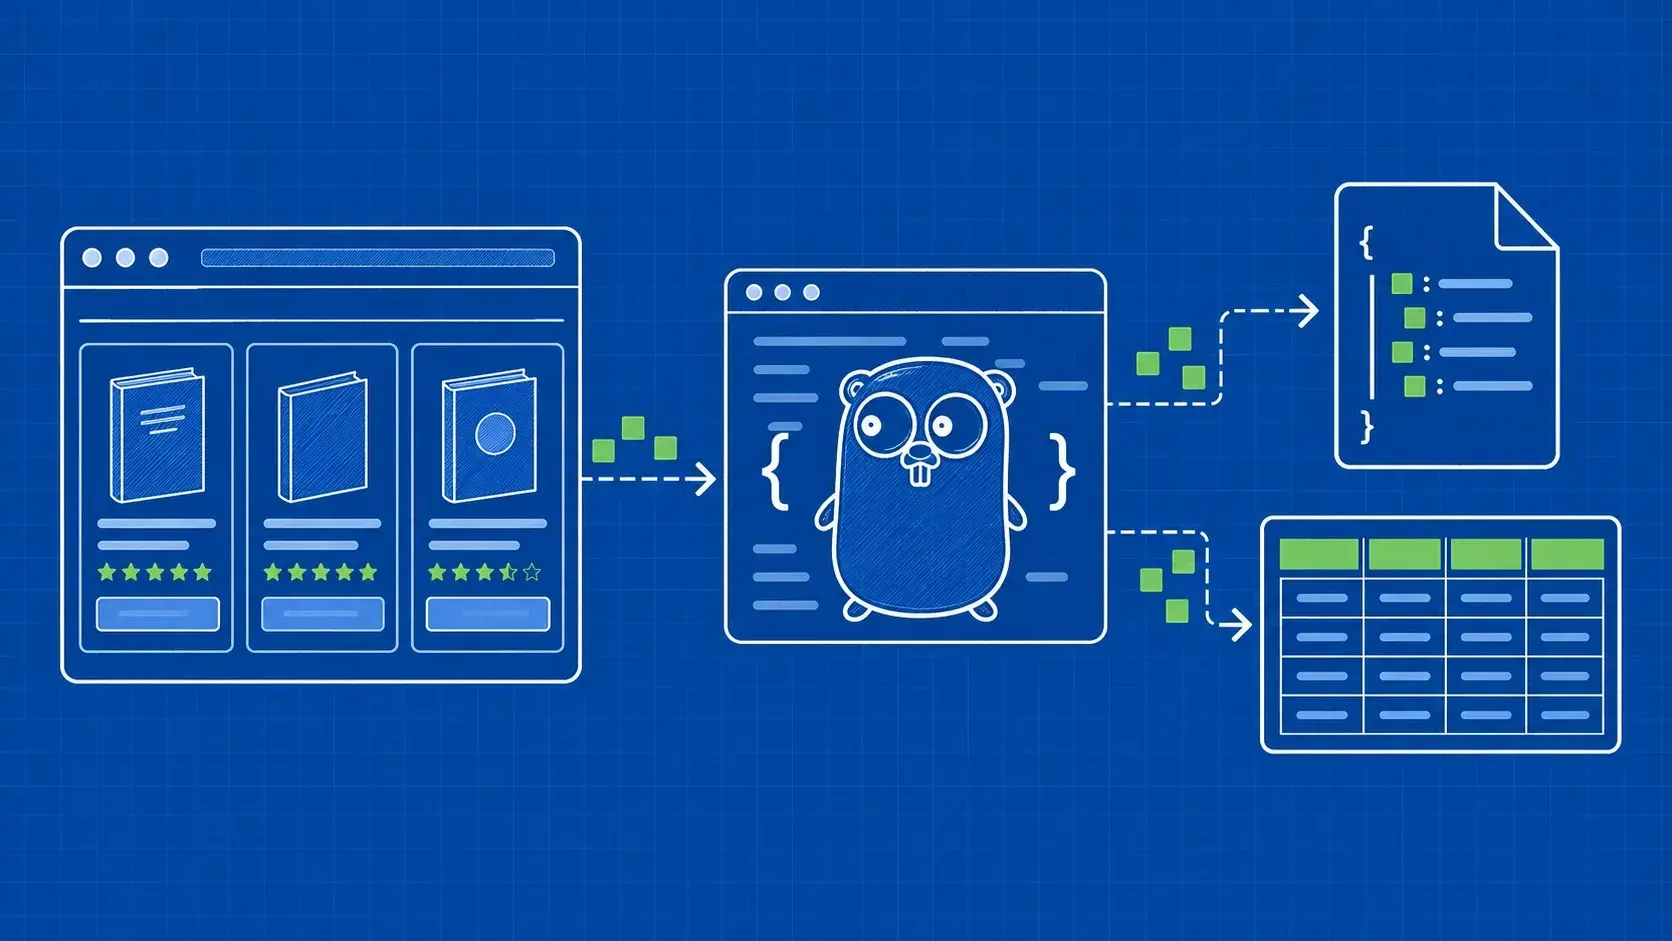
TL;DR: 构建一个 Go 爬虫,用于将图书记录提取为 JSON。先参考一个经过测试的 goquery 示例,然后规划分页、Colly、浏览器渲染和错误处理。
TL;DR: 根据保留工作量对 Web Scraper、Browse AI、Apify 和 Scrapy 进行比较。在替换 Octoparse 之前,应进行受控的可修复性测试,并验证交付成果是否完整。
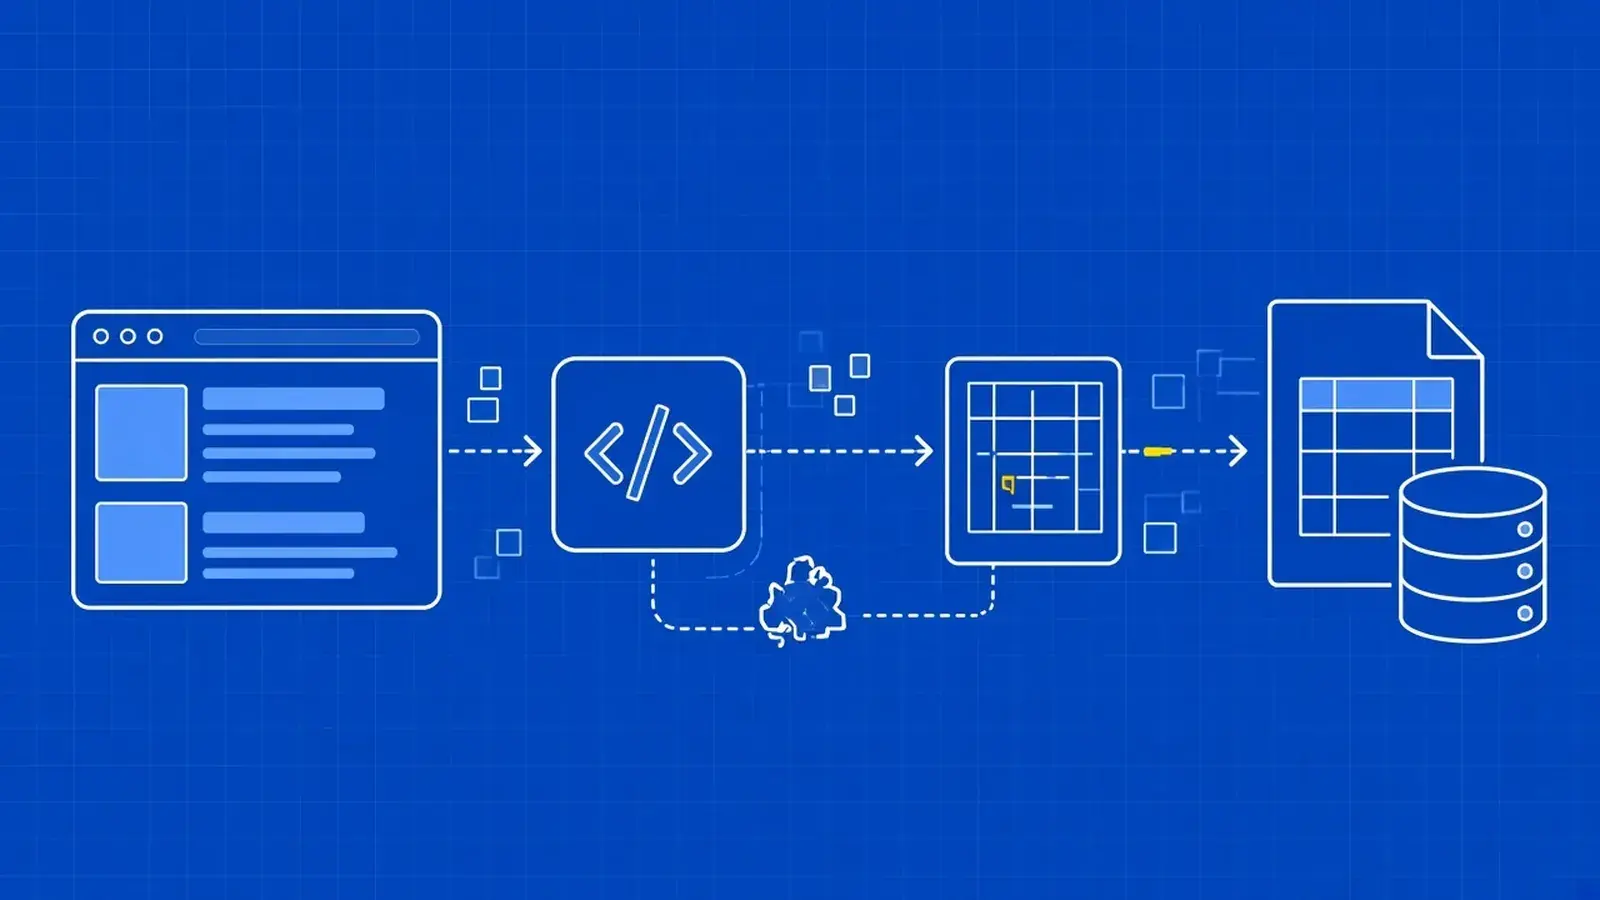
TL;DR: 简而言之:在 C# 中进行网页抓取,请从 .NET 10 入手:用内置的 HttpClient 下载网页,用 AngleSharp 通过 CSS 选择器解析 HTML。如果您更喜欢 XPath 或需要维护旧代码,请选择 HtmlAgilityPack;当页面由 JavaScript 构建时,再加入 Playwright for .NET。本指南构建一个爬虫,涵盖礼貌重试、有界爬取、CSV 和 JSON 导出以及离线测试。