
跳至内容
免费开始

Blog

洞察与工程

深入探讨网络数据基础设施、数据提取技术以及大规模结构化数据的未来。

最新文章

156 文章

如何在 2026 年将 cURL 与 Python 结合使用
指南

如何在 2026 年将 cURL 与 Python 结合使用

TL;DR: 简而言之:在 Python 中使用 cURL 有三种合理的方法:使用子进程 shell out 到 curl 二进制文件,通过 PycURL 绑定到 libcurl,或者完全跳过 curl 而使用 Requests 库。了解如何在 Python 中很好地使用 cURL 意味着对这三种方法都了如指掌。本指南将为你提供这三种方法的可运行示例、curl-flag-Python 转换表和决策矩阵,以便你第一次就能选择正确的工具。

Andrei Ogiolan5 min read
阅读文章
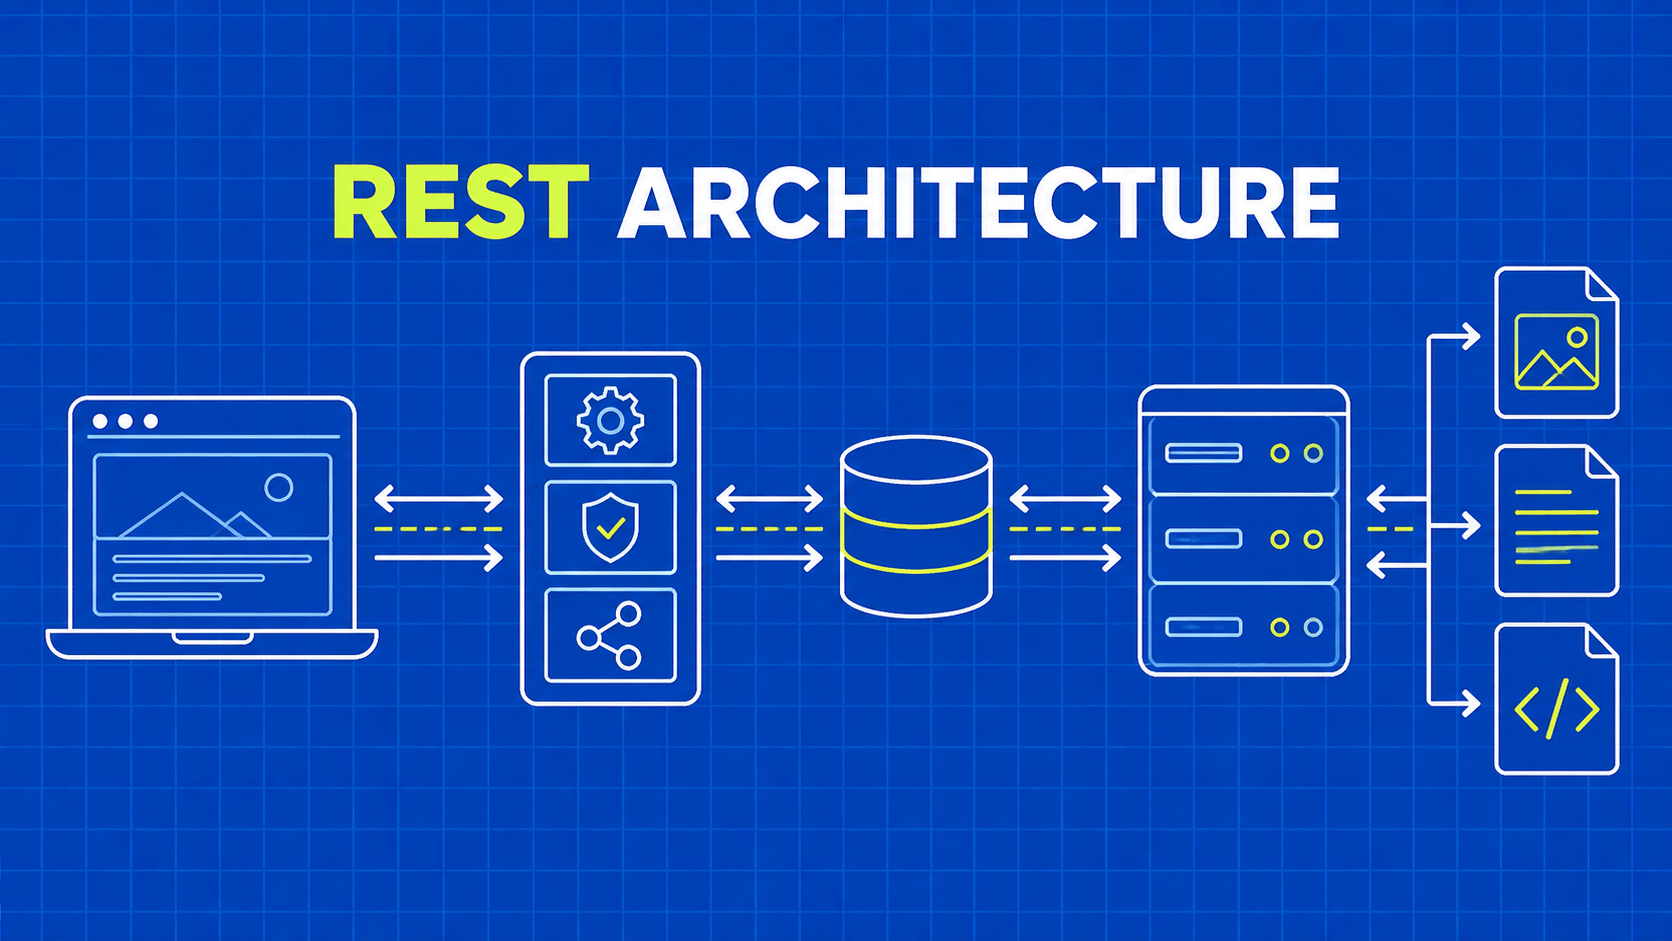
REST API 架构约束:设计指南
工程

REST API 架构约束:设计指南

TL;DR: 利用目录集成来检查 REST 的六项约束,区分资源状态与会话状态,并测试统一接口的全部四个部分。

Sorin-Gabriel Marica2 min read
阅读文章
如何在代理环境下使用 cURL:HTTP、HTTPS、SOCKS、身份验证及故障排除
用例

如何在代理环境下使用 cURL:HTTP、HTTPS、SOCKS、身份验证及故障排除

TL;DR: 简而言之:使用 -x 或 --proxy 参数通过代理运行 cURL,然后在构建自动化流程之前,对比直接连接和通过代理连接时获得的公共 IP 结果。本指南涵盖身份验证、HTTP 和 SOCKS 模式、持久化设置、绕过策略、IP 轮换、安全凭据处理、平台配置以及基于症状的故障排除。

Andrei Ogiolan3 min read
阅读文章
6款最适合网络爬虫的Python HTTP客户端
指南

6款最适合网络爬虫的Python HTTP客户端

TL;DR: 为您的爬虫选择合适的 Python HTTP 客户端。通过实际示例和可靠性建议,对比分析 Requests、HTTPX、aiohttp、urllib3、curl_cffi 和 Niquests。

Mihnea-Octavian Manolache3 min read
阅读文章
如何在 2026 年抓取 LinkedIn:Python 指南
指南

如何在 2026 年抓取 LinkedIn:Python 指南

TL;DR: 简要说明:Scraping LinkedIn 意味着要绕过咄咄逼人的认证墙、行为跟踪和 TLS 指纹识别。本指南为您提供了按页面类型划分的方法决策树,适用于工作、个人资料和公司的 Python 工作模式(必要时使用隐藏 API、JSON-LD 和 Selenium),以及 2026 年的综合防拦截清单。

Suciu Dan2 min read
阅读文章
2026 年 12 款最佳免费网络抓取工具:比较
指南

2026 年 12 款最佳免费网络抓取工具:比较

TL;DR: 简要说明:2026 年的 12 款最佳免费网络搜刮工具分为四类:管理 API(免费积分)、开源框架、无代码浏览器扩展和人工智能提取器。首先根据使用情况(一次性搜索与计划管道)进行选择,然后根据技能水平进行选择。大多数免费层级包括评估,而非生产;一旦你的成功率低于 90%,或者你在区块上花费的时间多于数据,就该升级到付费 API 了。

Suciu Dan4 min read
阅读文章

开始构建

准备好扩展您的数据收集规模了吗?

加入2,000多家企业,使用WebScrapingAPI在无需任何基础设施开销的情况下,以企业级规模提取网络数据。