

指南
使用 Ruby 进行网页抓取:从 Faraday 和 Nokogiri 到 Selenium
TL;DR: 使用 Ruby 进行网页抓取是指请求网页内容、在 HTML 或浏览器渲染的文档中定位有用值,并使用 Ruby 代码将这些值转换为结构化记录的过程。最易于维护的方法是使用能够可靠访问数据的、最轻量级的技术栈。
Raluca Penciuc3 min read
阅读文章Blog
深入探讨网络数据基础设施、数据提取技术以及大规模结构化数据的未来。
156 文章
TL;DR: 使用 Ruby 进行网页抓取是指请求网页内容、在 HTML 或浏览器渲染的文档中定位有用值,并使用 Ruby 代码将这些值转换为结构化记录的过程。最易于维护的方法是使用能够可靠访问数据的、最轻量级的技术栈。
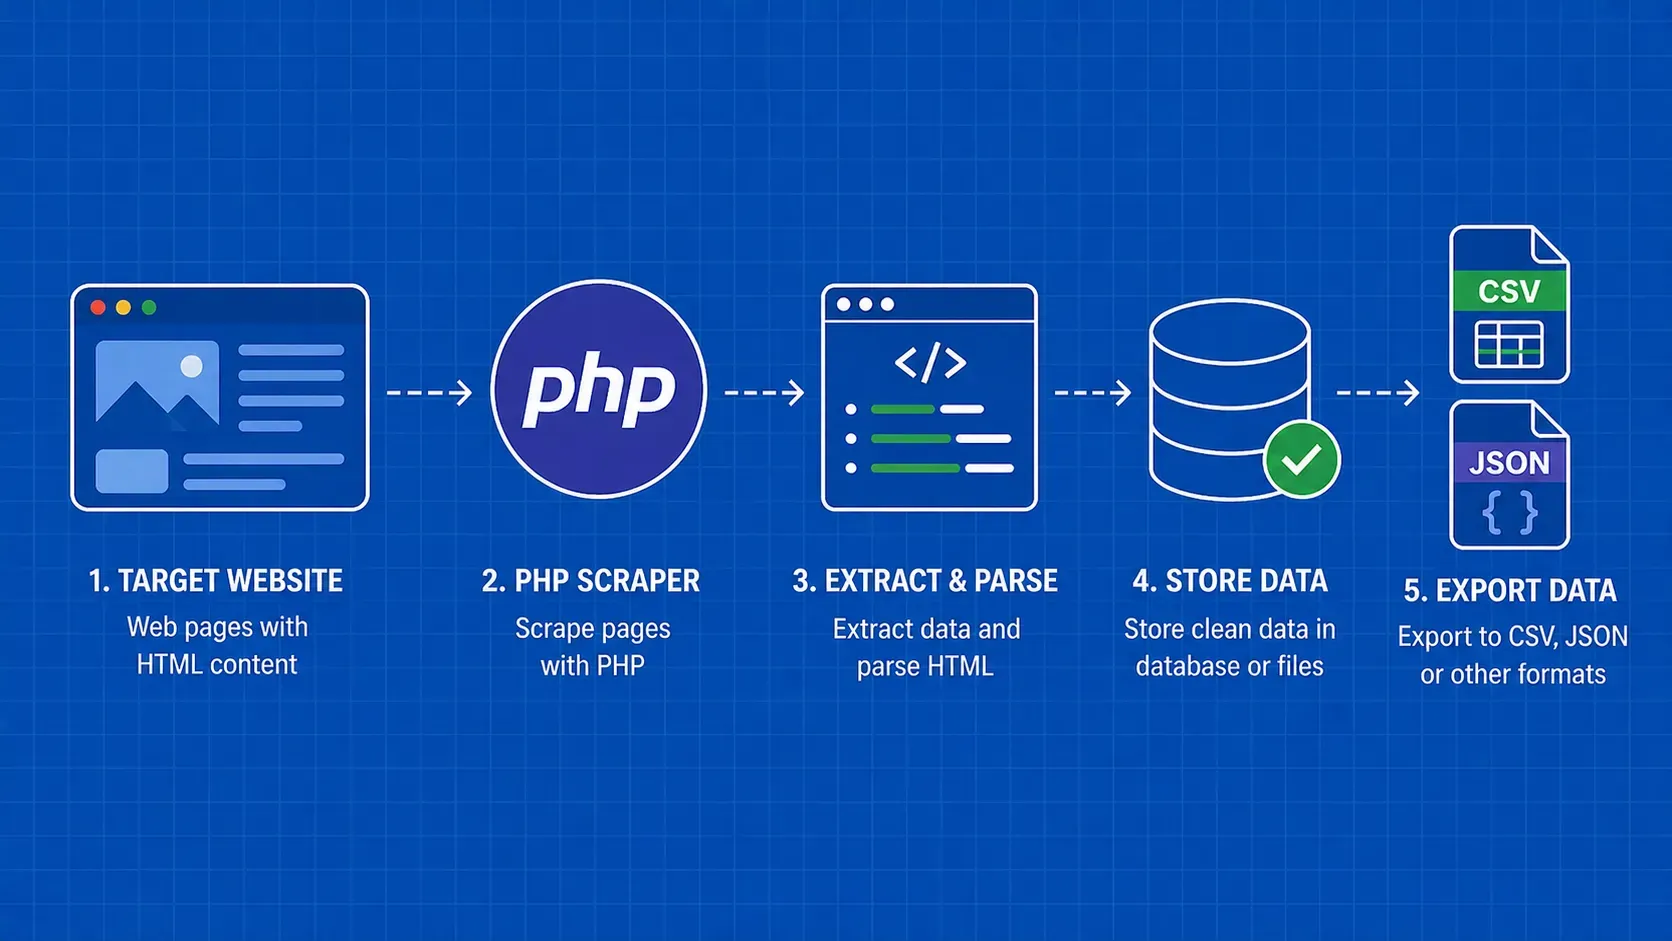
TL;DR: 简而言之:由于内置了 cURL 和 DOMDocument 等扩展,再加上包括 Guzzle、Symfony DomCrawler 和用于无头浏览的 Symfony Panther 在内的丰富的 Composer 生态系统,PHP 完全有能力胜任 Web 搜索。本指南将指导您完成整个工作流程:获取页面、解析 HTML、将结果存储到 CSV/JSON/MySQL、处理错误以及避免阻塞。

TL;DR: TL;DR:那么什么是旋转代理呢?代理服务器会为来自管理池的每个请求分配不同的 IP,这就是搜刮者如何绕过每个 IP 的速率限制、验证码和地理过滤器的原因。本指南介绍了旋转的工作原理、四种池类型、三种语言的设置代码以及如何选择提供商。
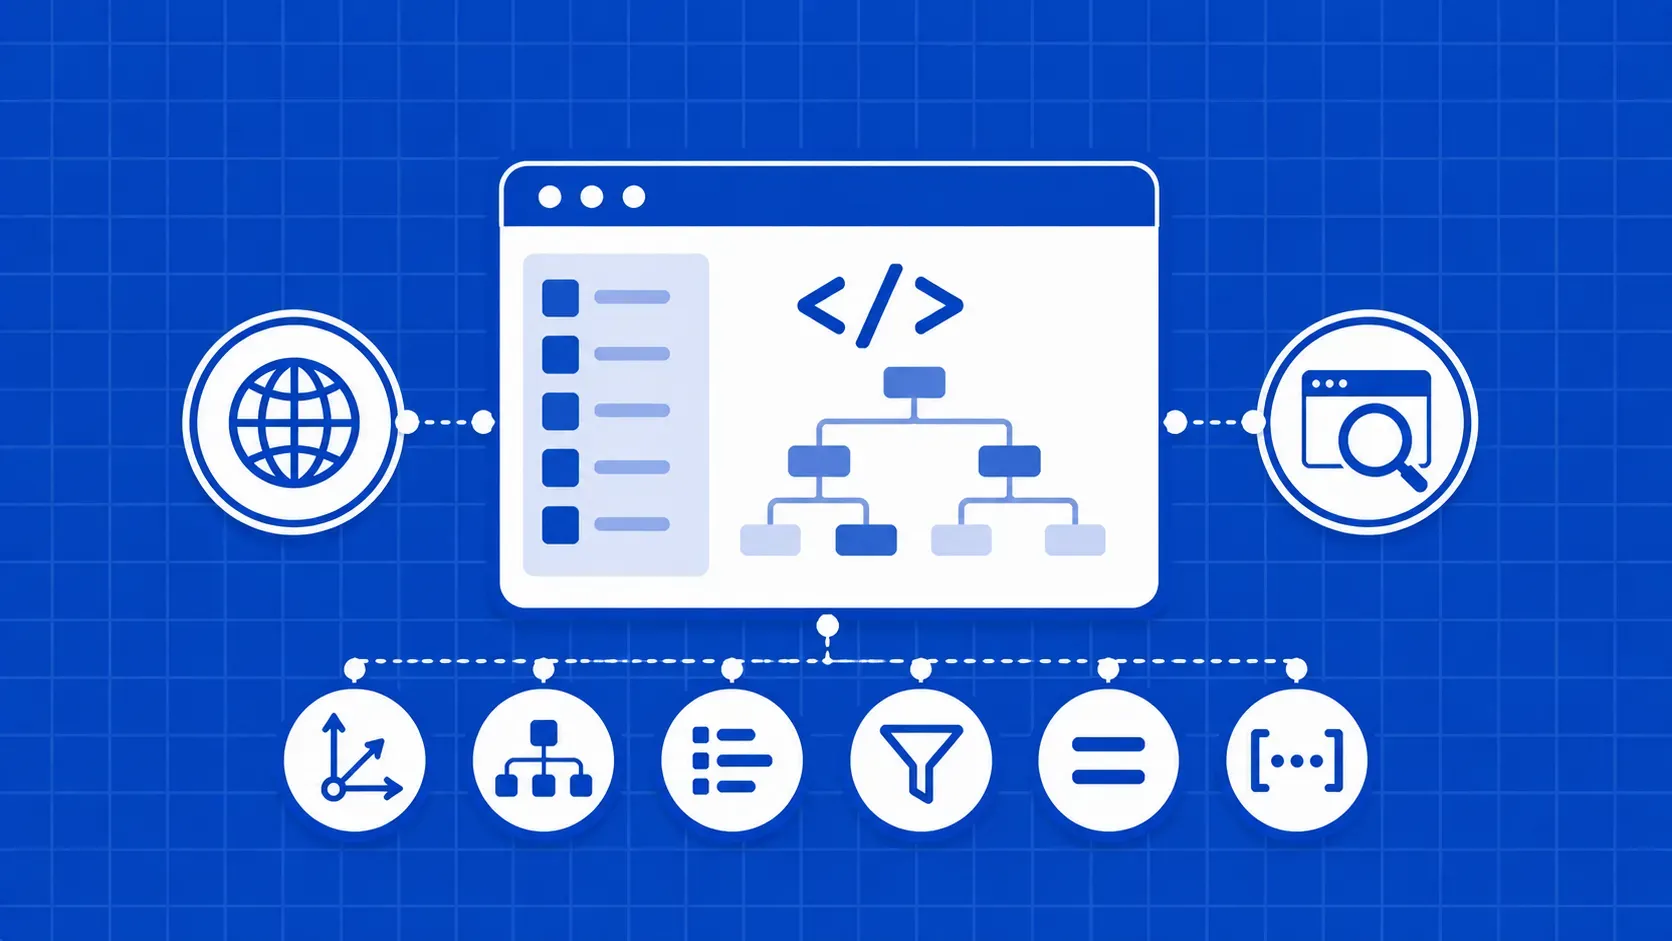
TL;DR: 简要说明:这本 XPath 小抄涵盖了网络搜刮实际需要的语法、谓词、轴和函数,还有 CSS 到 XPath 转换表和可运行的 Puppeteer 和 Scrapy 示例。下次当你依赖的网站上的 CSS 选择器悄无声息地崩溃时,你可以将它作为桌面参考。

TL;DR: 简要说明:python 网络爬虫可以自动完成在网站上跟踪链接以发现和收集内容的繁琐工作。本指南将指导您使用请求和 BeautifulSoup 从头开始构建爬虫,然后再使用 Scrapy 进行并发爬行、项目管道和结构化数据导出。您还将学习如何负责任地抓取、旋转代理以避免阻塞,以及如何处理 JavaScript 渲染的页面。
TL;DR: 简而言之:对大多数抓取团队来说,Oxylabs 和 Decodo 是最强的全能型高级代理服务,Bright Data 适合企业级预算,Webshare 则是从静态列表起步最便宜的选择。如果希望 IP 在租用期内归您专用,请选择静态列表;如果每个请求或会话都应通过不同的 IP 发出,请选择轮换网关。