
网络爬虫技术
使用 Node-Unblocker 进行网络抓取:实用指南
TL;DR: 简要说明:Node-unblocker 将 Express 应用程序变成了一个 URL 前缀 HTTP 代理,你可以在上面进行黑客攻击。这篇网络搜刮节点解锁指南介绍了如何安装、连接请求和响应中间件、轮换实例、在 Docker 或 Heroku 上部署,以及如何识别托管搜刮 API 才是更明智的选择。
Sorin-Gabriel Marica3 min read
阅读文章作者简介
索林·马里卡(Sorin Marica)是 WebScrapingAPI 的全栈及 DevOps 工程师,负责开发产品功能并维护确保平台平稳运行的基础设施。
已发表的文章
8 文章
TL;DR: 简要说明:Node-unblocker 将 Express 应用程序变成了一个 URL 前缀 HTTP 代理,你可以在上面进行黑客攻击。这篇网络搜刮节点解锁指南介绍了如何安装、连接请求和响应中间件、轮换实例、在 Docker 或 Heroku 上部署,以及如何识别托管搜刮 API 才是更明智的选择。
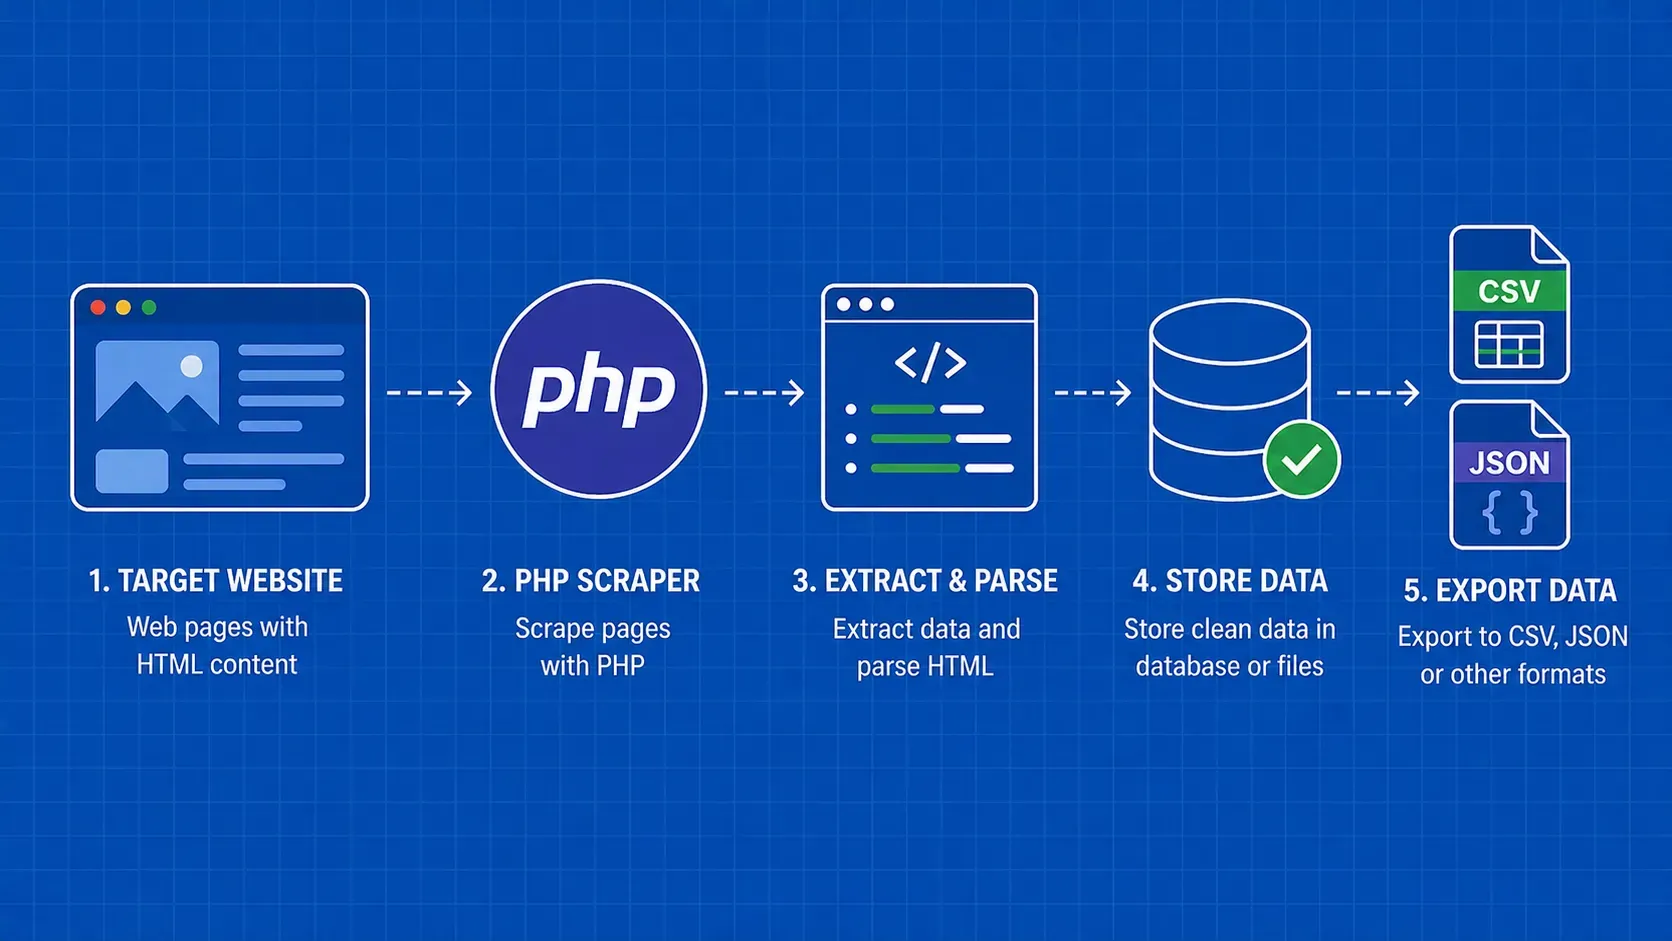
TL;DR: 简而言之:由于内置了 cURL 和 DOMDocument 等扩展,再加上包括 Guzzle、Symfony DomCrawler 和用于无头浏览的 Symfony Panther 在内的丰富的 Composer 生态系统,PHP 完全有能力胜任 Web 搜索。本指南将指导您完成整个工作流程:获取页面、解析 HTML、将结果存储到 CSV/JSON/MySQL、处理错误以及避免阻塞。
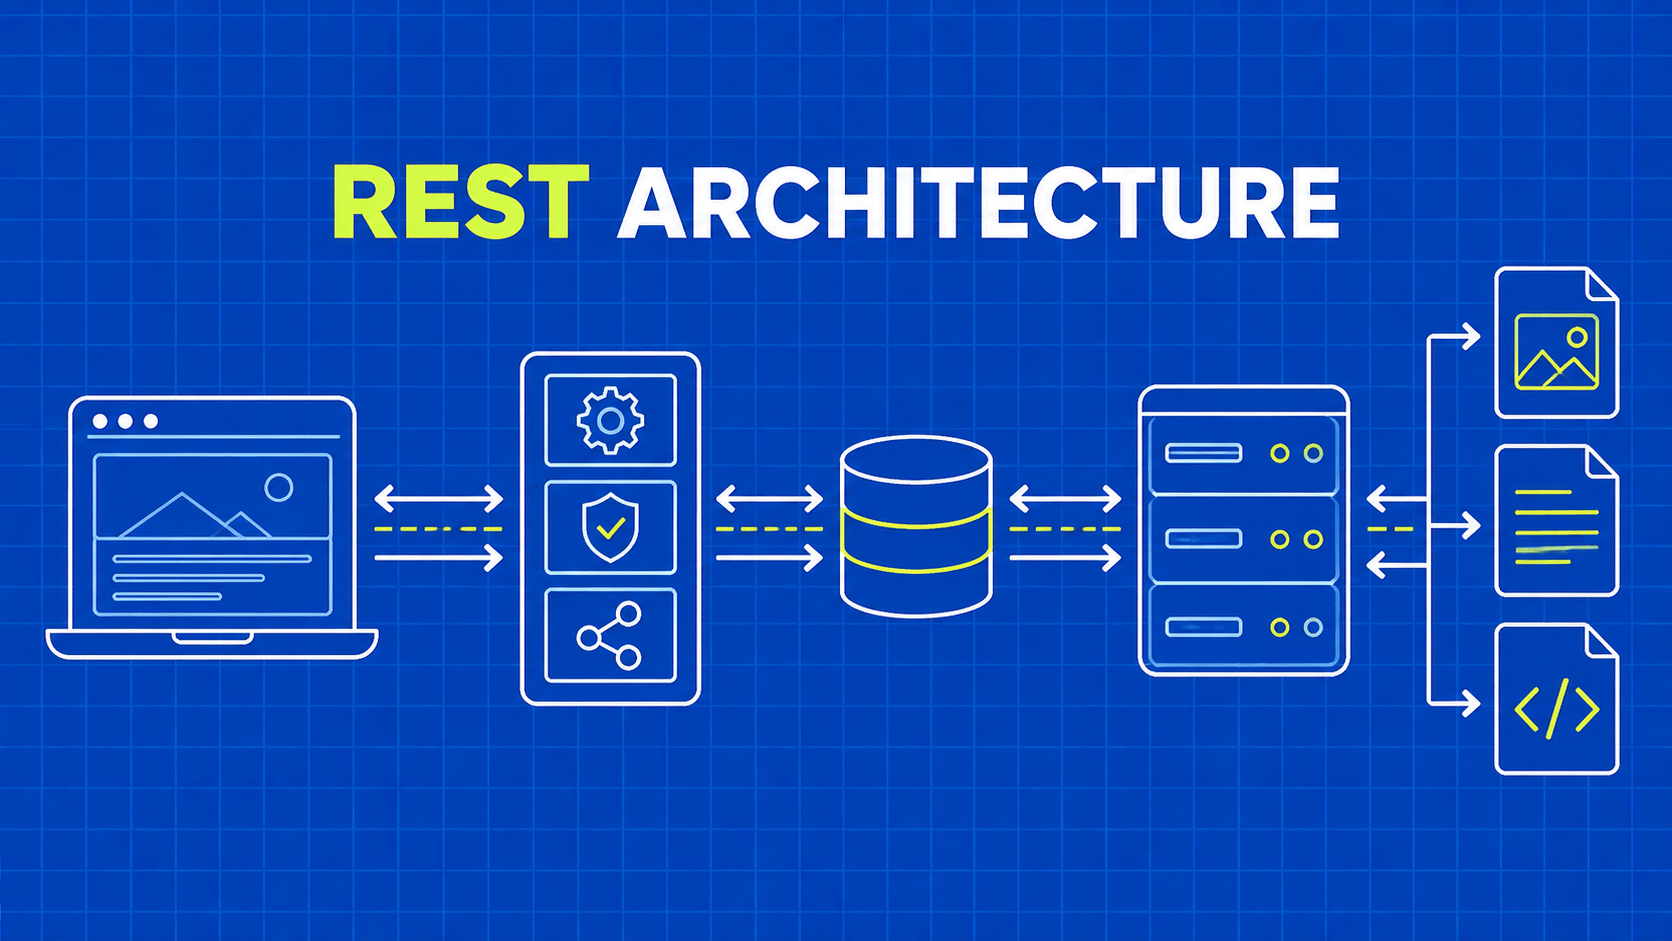
TL;DR: 利用目录集成来检查 REST 的六项约束,区分资源状态与会话状态,并测试统一接口的全部四个部分。

TL;DR: 了解如何使用新发布的 node-fetch 直接从 Node.js 发起 HTTP 请求。node-fetch 相当于 JavaScript 中的 fetch API
TL;DR: PhantomJS 已于 2018 年停止开发。请根据您的脚本原有的功能选择替代方案,将 PhantomJS 的调用映射到 Playwright 或 Puppeteer,并清理旧的依赖项。
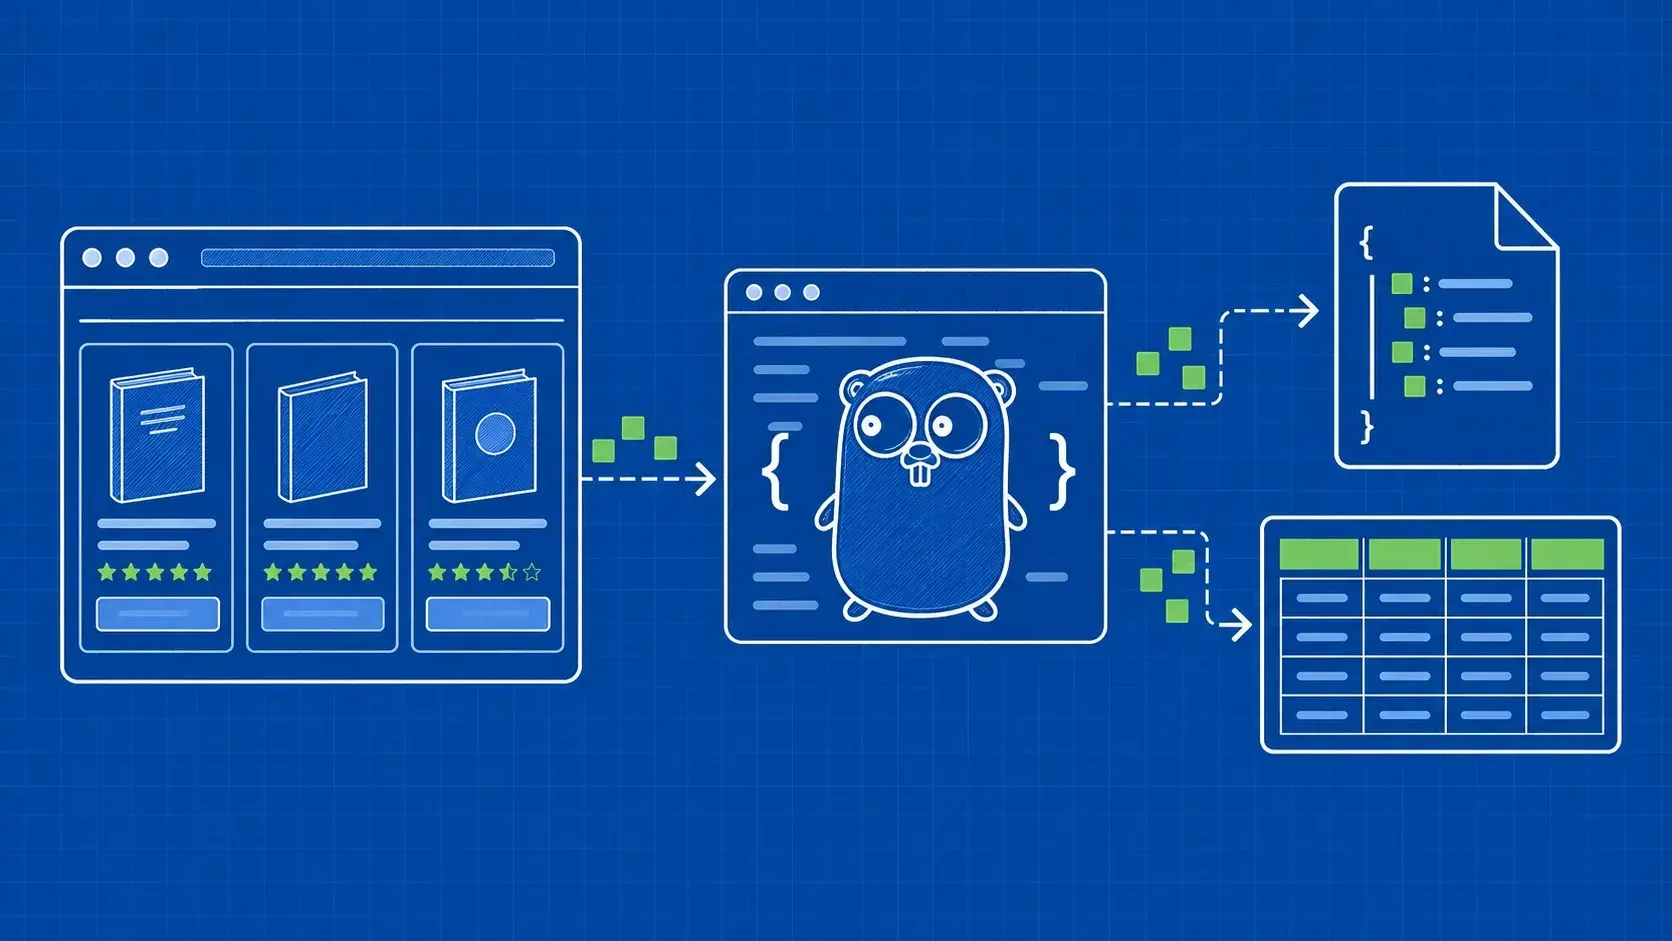
TL;DR: 构建一个 Go 爬虫,用于将图书记录提取为 JSON。先参考一个经过测试的 goquery 示例,然后规划分页、Colly、浏览器渲染和错误处理。
TL;DR: 简而言之:在 C# 中进行网页抓取,请从 .NET 10 入手:用内置的 HttpClient 下载网页,用 AngleSharp 通过 CSS 选择器解析 HTML。如果您更喜欢 XPath 或需要维护旧代码,请选择 HtmlAgilityPack;当页面由 JavaScript 构建时,再加入 Playwright for .NET。本指南构建一个爬虫,涵盖礼貌重试、有界爬取、CSV 和 JSON 导出以及离线测试。
TL;DR: 简要说明:这篇 BeautifulSoup 教程将引导您完成一个完整的 Python scraper,从 pip 安装到一个加固的脚本,该脚本可以分页浏览 Hacker News、导出为 CSV 和 JSON,并保持足够的礼貌以免被屏蔽。每个片段都可运行,我们还指出了 BeautifulSoup 是错误工具的确切时刻。