
工程
去中心化的典范:ice Network的DAO模式与Pi Network用户缺乏控制权的对比
TL;DR: 在理解了两种不同的DAO去中心化模型之间的区别后,我们将对两个相似但截然不同的网络——ICE和Pi——进行探讨。
Anda Miuțescu1 min read
阅读文章
已发表的文章
12 文章
TL;DR: 在理解了两种不同的DAO去中心化模型之间的区别后,我们将对两个相似但截然不同的网络——ICE和Pi——进行探讨。
TL;DR: 简而言之:2026 年最好的轮播住宅代理并不是拥有最大广告牌池规模的代理。它们在会话控制、地理定位、道德采购和按 GB 计算的经济性等方面都能真正匹配您搜索的目标。本指南为您提供了一个供应商中立的评估框架、11 家供应商的对比表和使用案例图,这样您就可以在使用信用卡之前筛选出两三家供应商。
TL;DR: 简而言之:Wget 虽然可靠,但已经老化。如果需要并行下载,可以使用 aria2。如果需要广泛的协议覆盖范围和脚本,curl 是首选。想要更友好的 API 测试工作流程?HTTPie(或它的 Rust 兄弟 xh)就非常适合。如果你想要最接近的升级路径,wget2 会添加 HTTP/2、多线程和插件系统,同时保留你已经熟悉的命令模式。
TL;DR: 共享型、半专用型和专用型数据中心代理的定价和计费方式差异巨大,以至于标价最低的那种往往实际花费最高。 本指南对比了11家服务商的当前标价,针对不同任务各推荐一家,详细解释了按IP计费与按GB计费的区别以及合理使用政策,并附有Python脚本,可用于估算成本并验证您的IP是否真正属于专用IP。
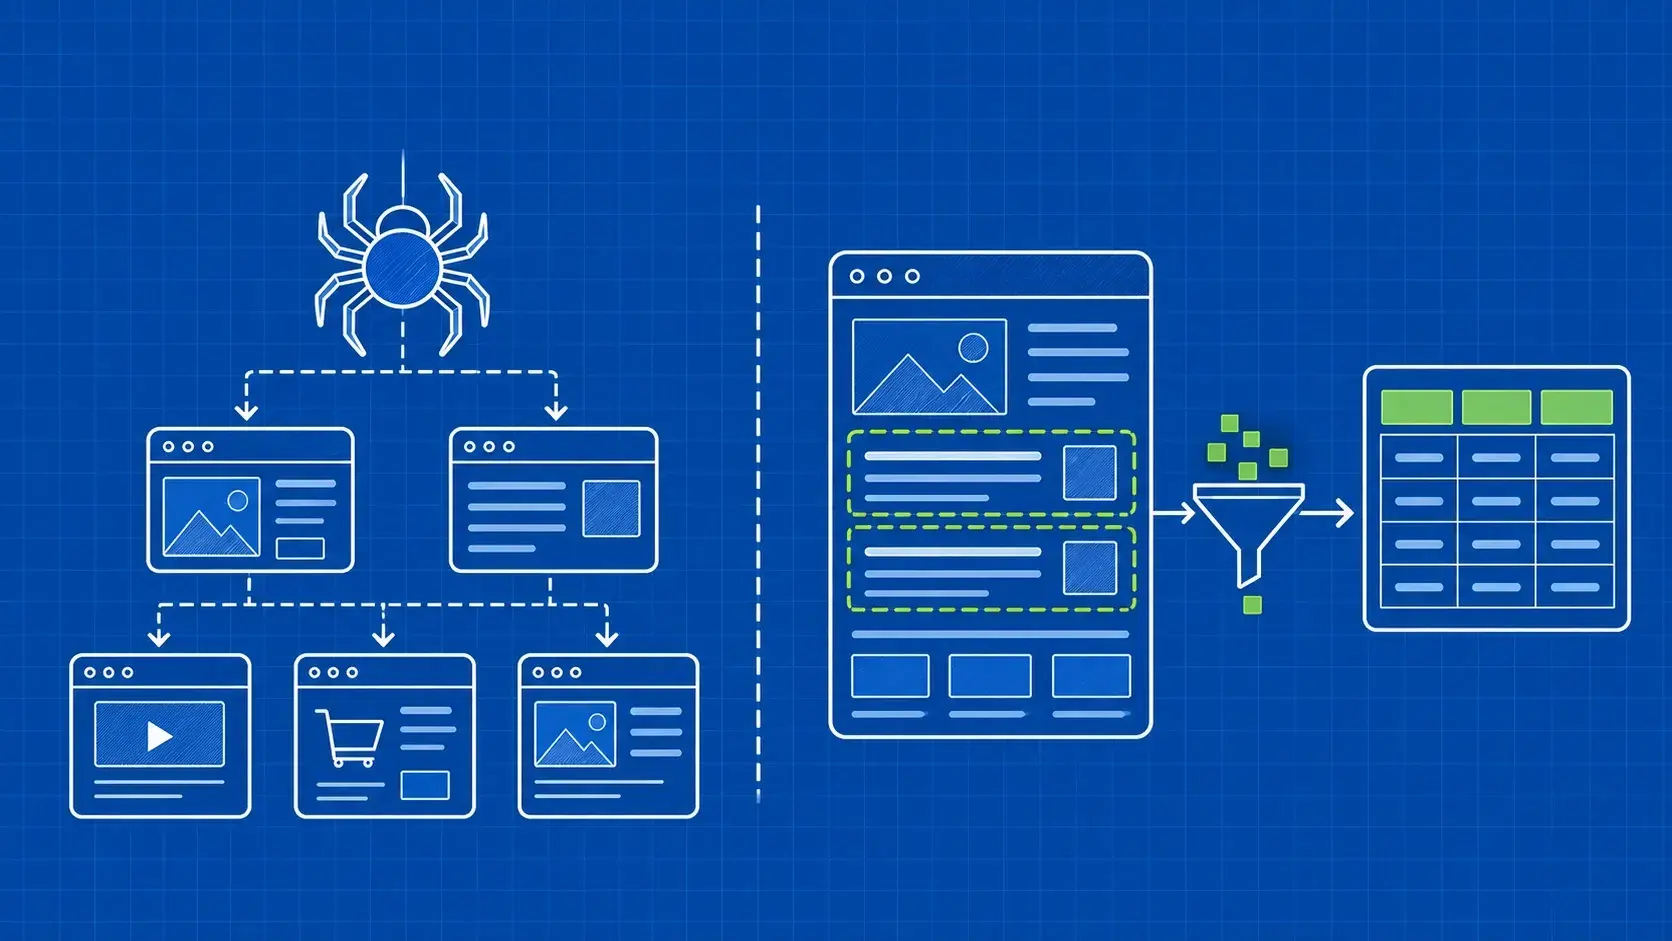
TL;DR: 了解爬虫如何查找网页,以及数据抓取工具如何提取有用数据。以一家书店为例,比较它们的输出结果,并为您的首个项目选择合适的工作流程。
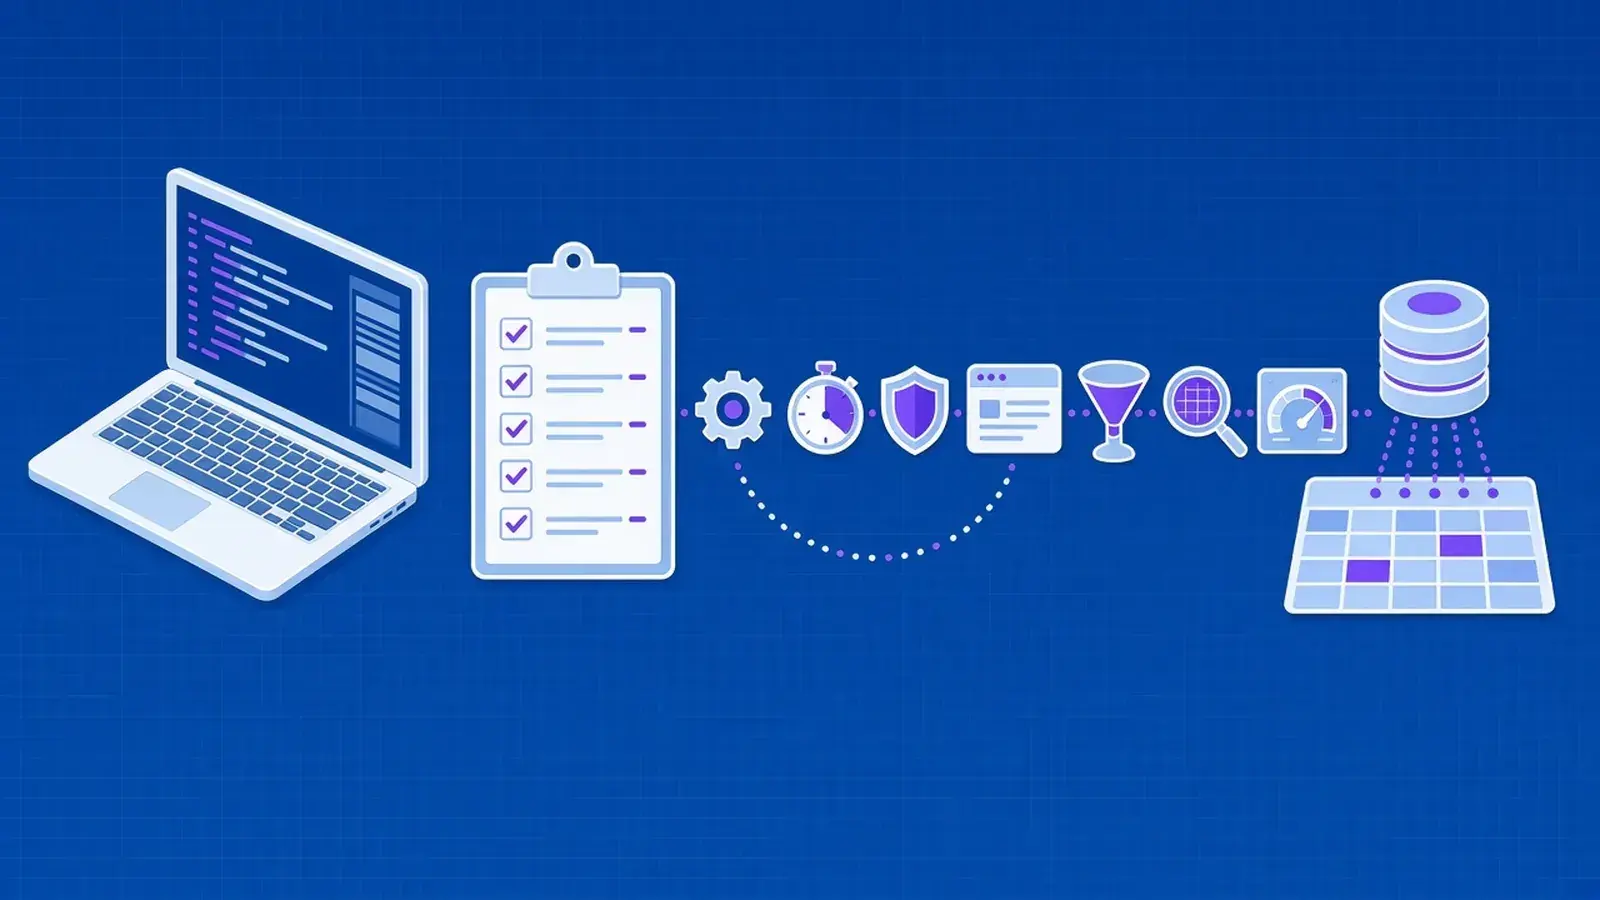
TL;DR: 简而言之:网页抓取最佳实践,是让爬虫保持合法、礼貌、准确且运行成本低的一系列习惯。请编写数据契约,优先使用 API 或 JSON 而非 HTML,按照 RFC 9309 的定义遵守 robots.txt,控制对每个主机的请求节奏,遵守 Retry-After,并在保存前验证每条记录。本指南将这些实践应用于爬虫生命周期的每个阶段,并附有可运行的 Python 代码片段。
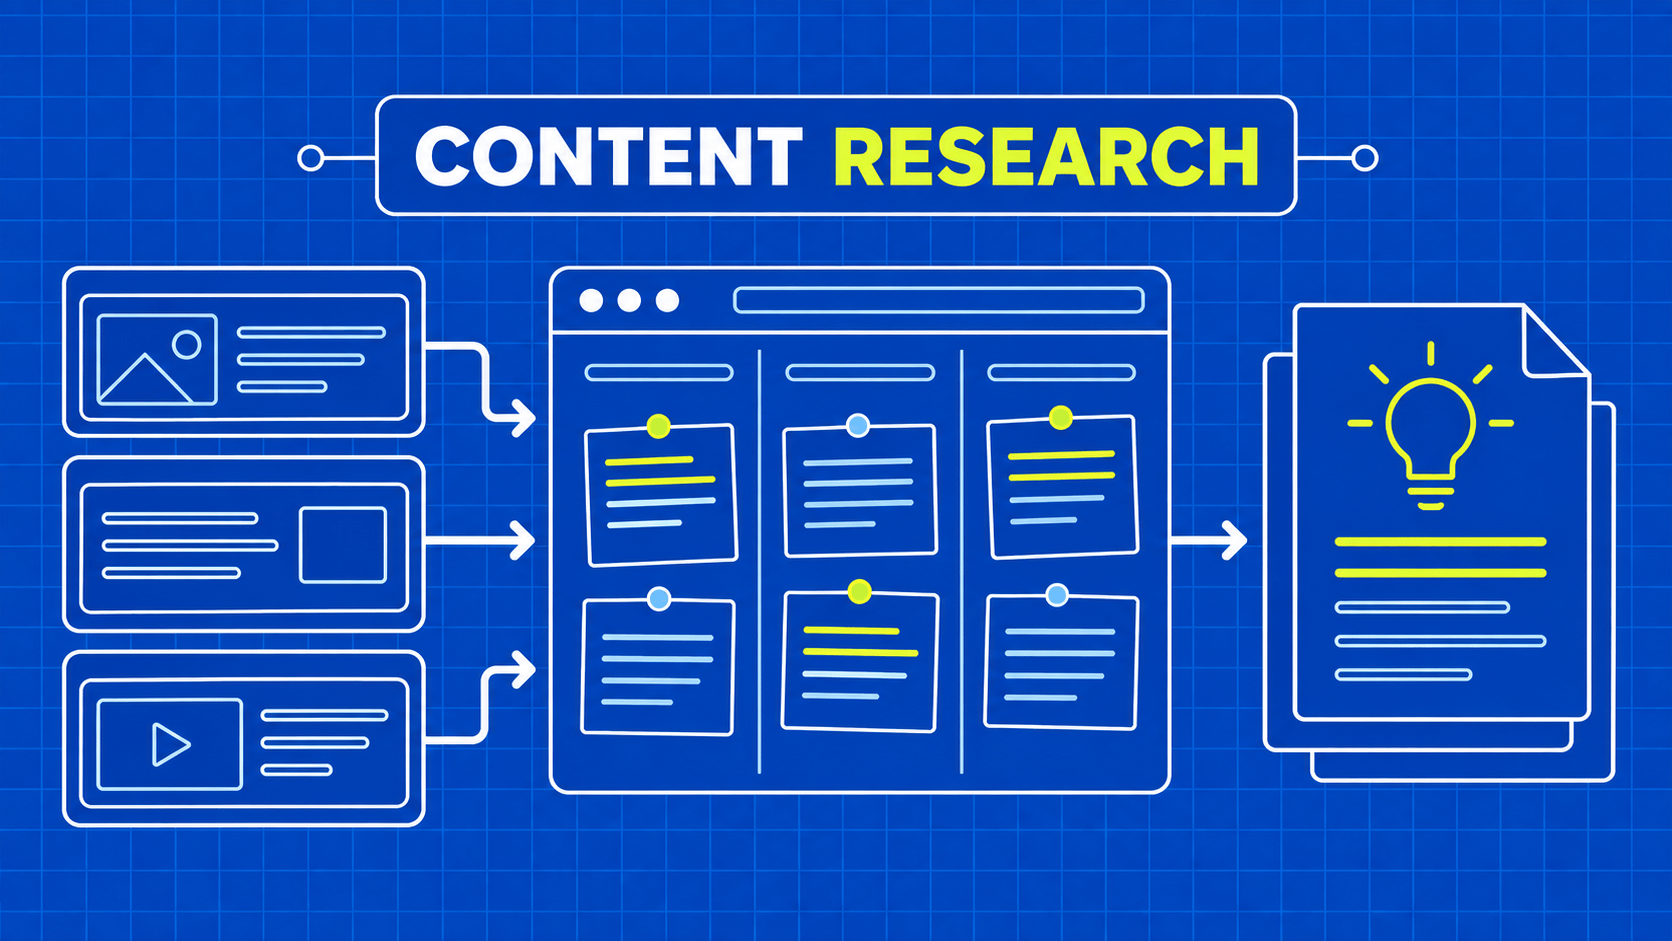
TL;DR: 建立证据清单,识别读者与任务之间的差距,并将经过审查的观察结果转化为原创内容。保留来源、不确定性,并提供清晰的视觉解释。
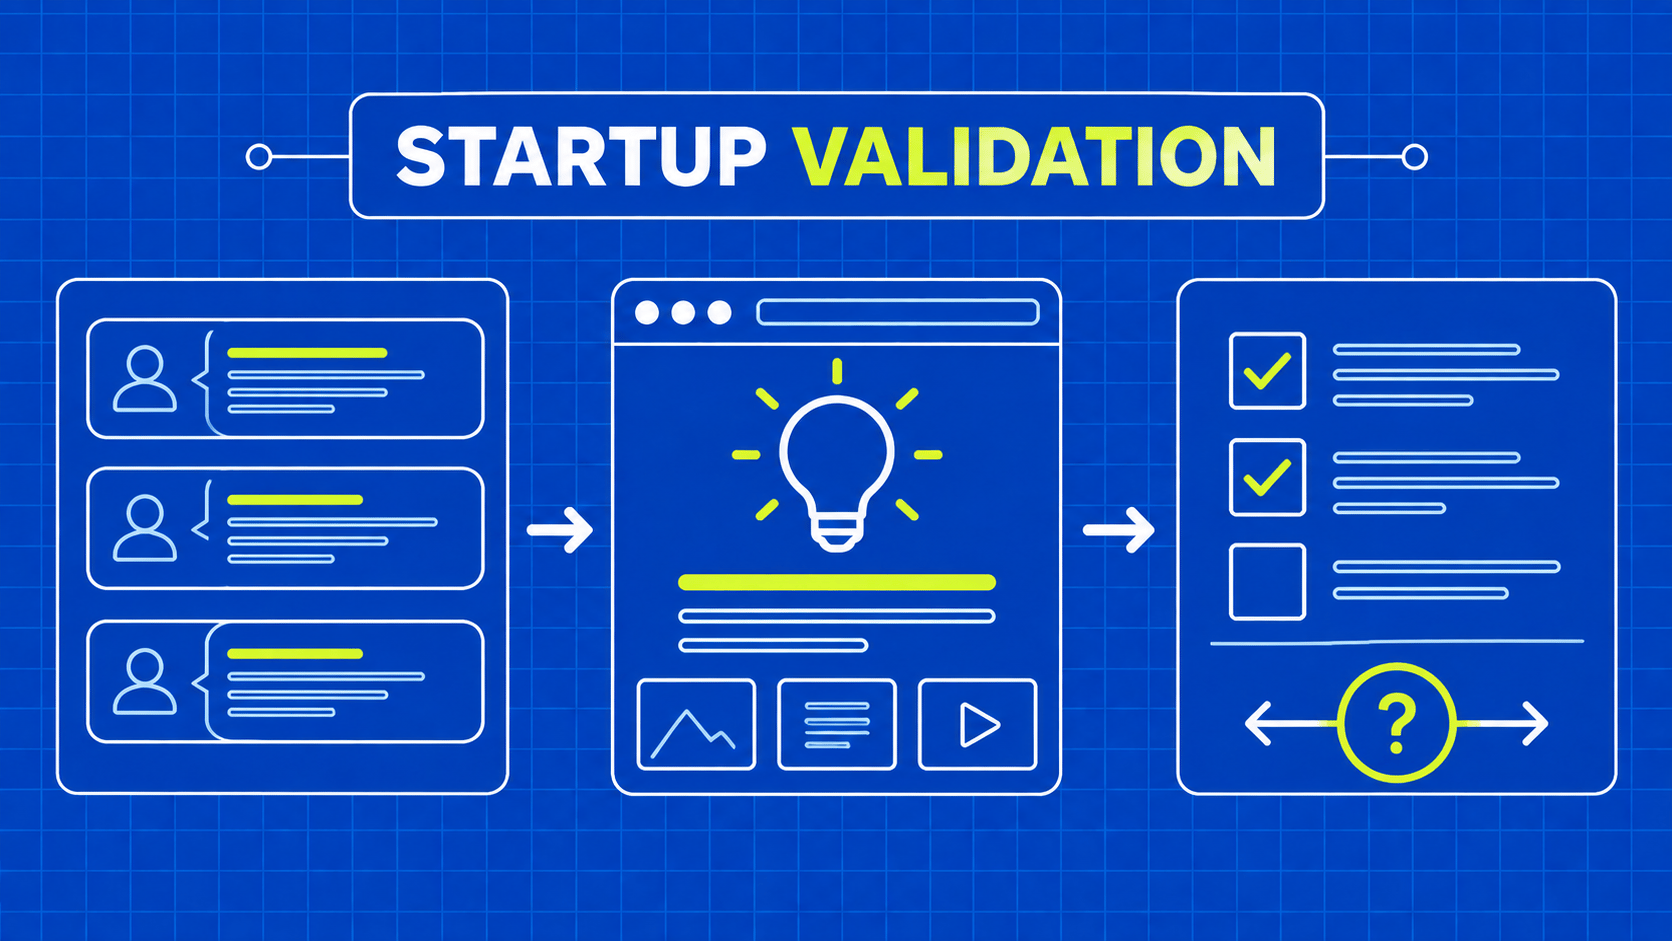
TL;DR: 利用一个范围有限且经过审核的数据集,对初创企业的上线假设进行验证。将数据采集质量与用户研究相结合,并设置一个能够缩小项目范围或终止项目的上线门槛。
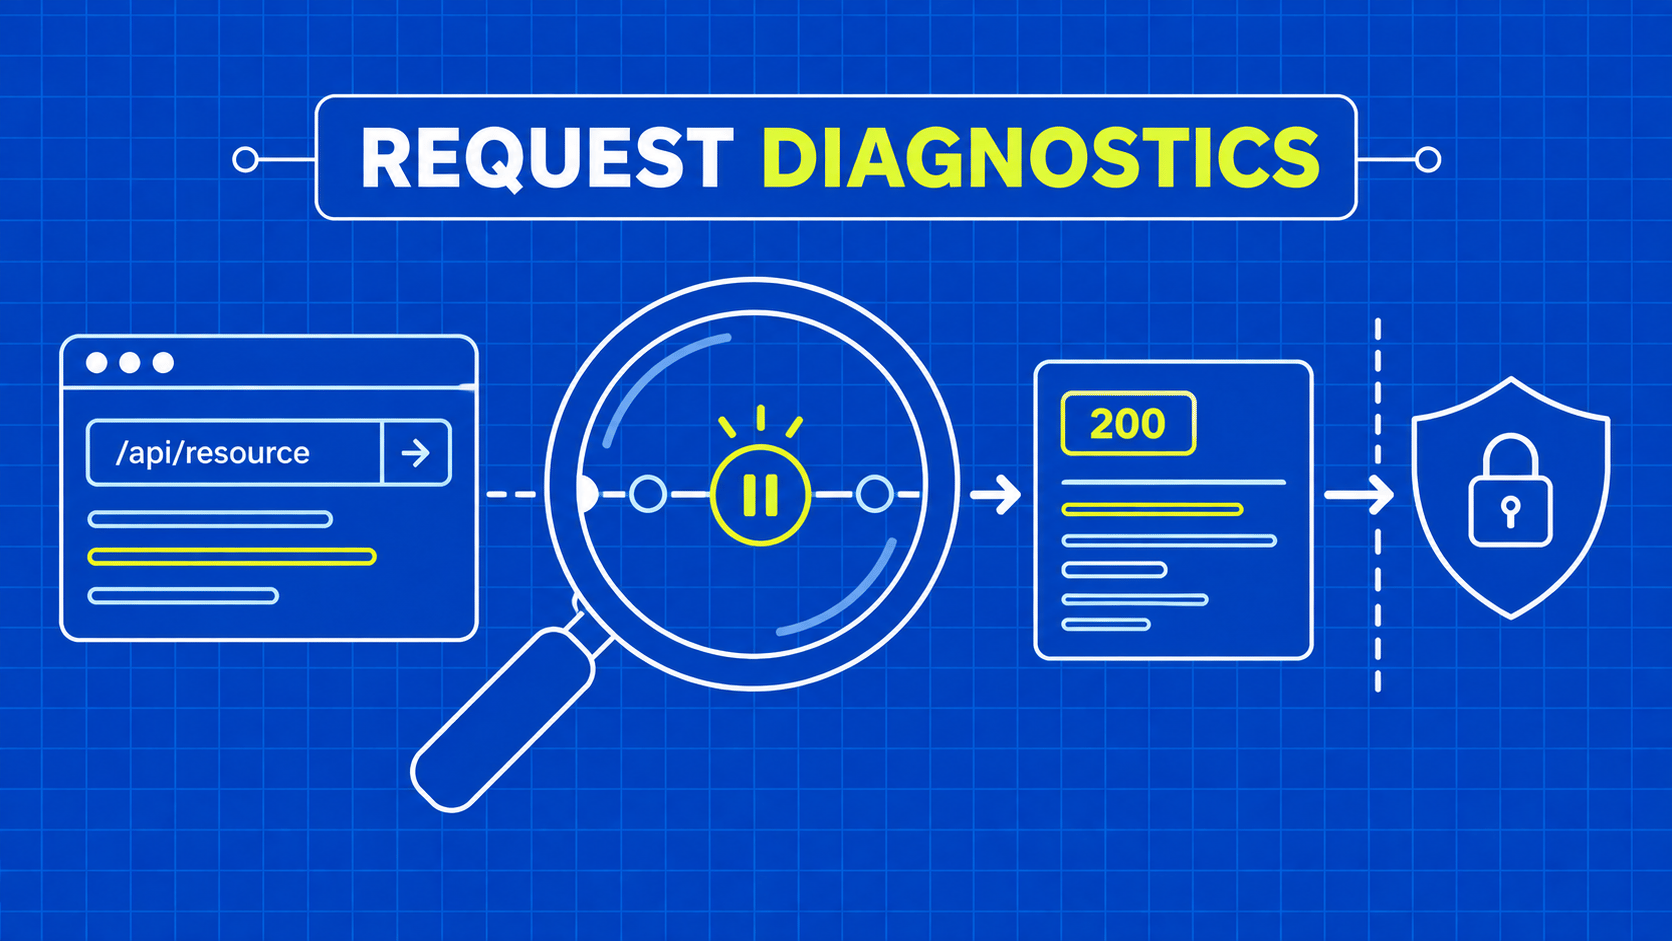
TL;DR: 在将问题归咎于IP封禁之前,应先查明导致抓取失败的根本原因。诊断速率限制、会话问题和访问拒绝情况,然后验证是否已恢复正常。

TL;DR: 企业在哪些情况下最常使用网页抓取技术?了解网页抓取技术在哪些应用场景中表现尤为出色。
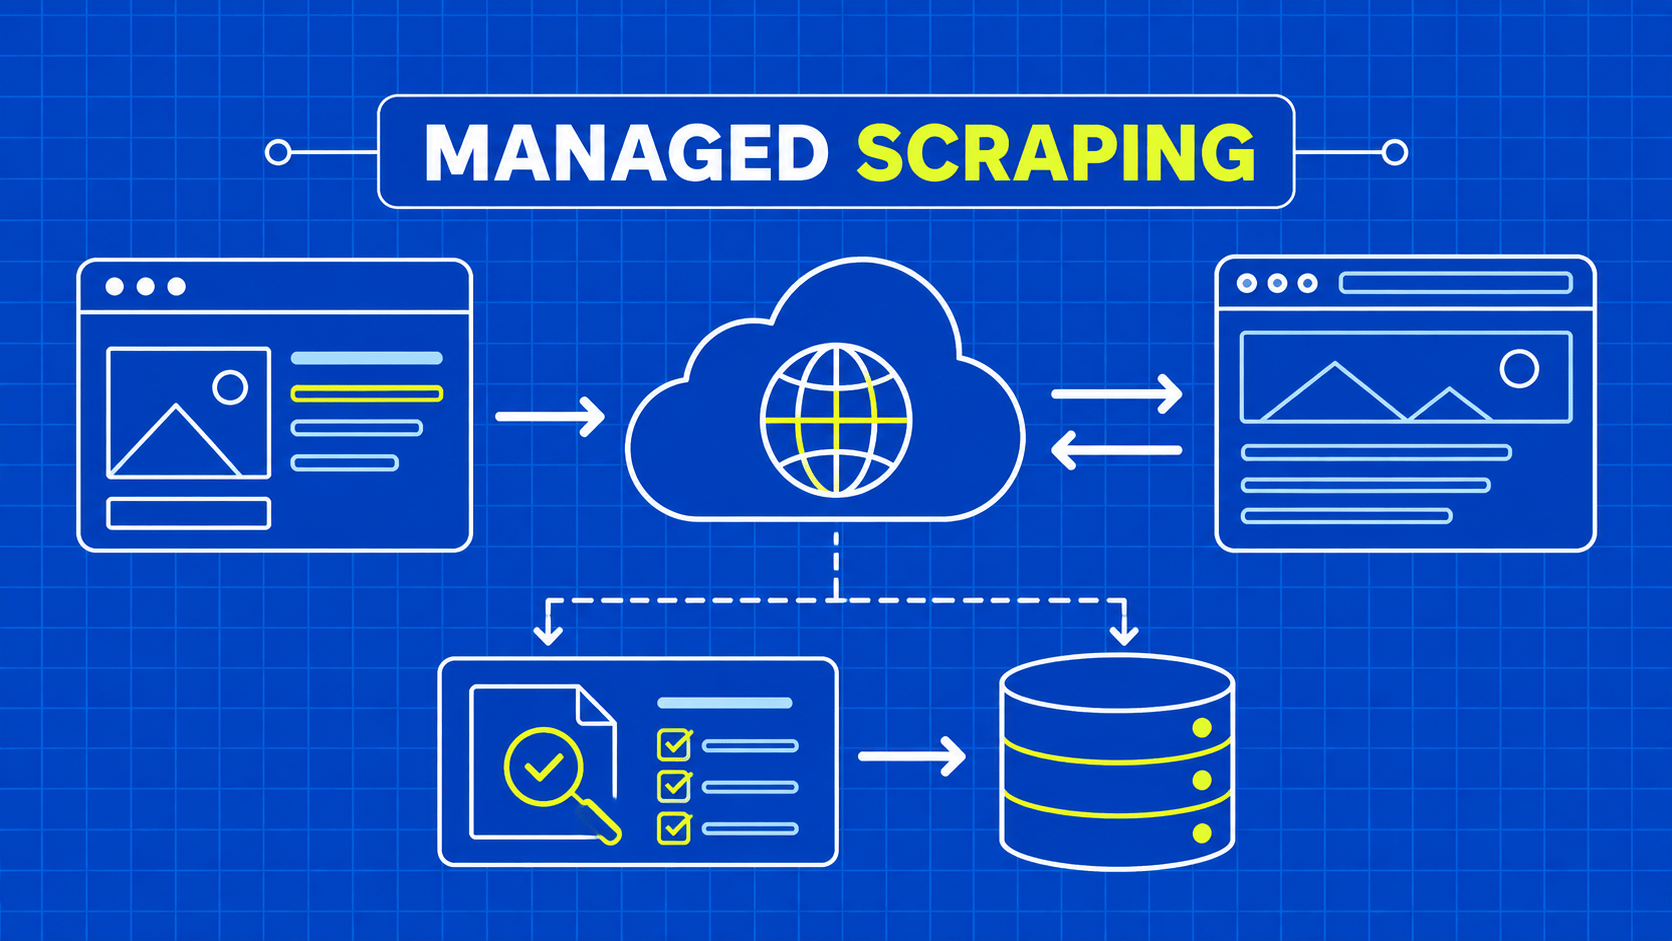
TL;DR: 了解数据抓取 API 可以承担哪些职责,哪些职责仍需由您负责。评估渲染、结构化输出、恢复以及每条可用记录的成本。

TL;DR: 您是开发人员、数据科学家、非程序员、小公司还是大公司?你来对地方了。请欣赏我们的网络搜索文章!